Strona główna
» ADMINISTRATOR SIECI
»
6 najlepszych narzędzi do monitorowania serwerów Windows Server zapewniających lepszą dostępność i wydajność
6 najlepszych narzędzi do monitorowania serwerów Windows Server zapewniających lepszą dostępność i wydajność
W środowisku Windows odpowiednie narzędzie do monitorowania powinno pokazywać więcej niż tylko to, czy serwer odpowiada na ping. Powinno ono wykrywać obciążenie zasobów, awarie usług, problemy z aplikacjami i generować alerty wymagające podjęcia działań. Sześć solidnych opcji to SolarWinds Server & Application Monitor (SAM), ManageEngine OpManager, Paessler PRTG, Zabbix, Checkmk i Datadog Infrastructure Monitoring. Przed wyborem porównaj sposób gromadzenia danych i licencjonowanie tych narzędzi.
Co powinno obejmować monitorowanie serwera Windows
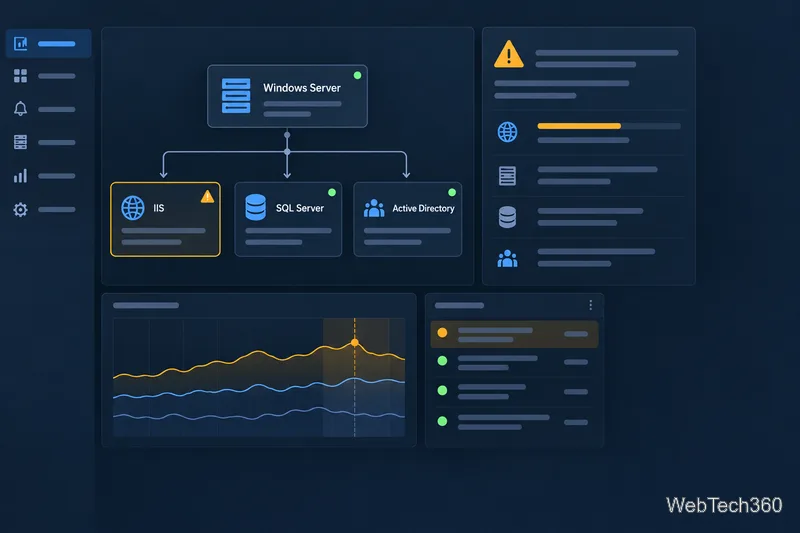
Monitoruj dostępność i wydajność hosta (procesor, pamięć, dysk i sieć), usługi systemu Windows i dzienniki zdarzeń oraz kondycję aplikacji dla obciążeń takich jak IIS, SQL Server czy Active Directory. Serwer może odpowiadać na pingi, gdy krytyczna usługa jest zatrzymana, więc sam czas sprawności nie wystarczy.
Bezagentowe sprawdzanie WMI lub WinRM redukuje liczbę instalowanych programów, ale wymaga dostępu do działających poświadczeń, dostępu do zapory sieciowej i usług zarządzania systemem Windows. Agenty mogą udostępniać dodatkowe dane hosta, ale dodają oprogramowanie do wdrożenia, aktualizacji i zabezpieczenia. Wybierz model gromadzenia danych, który pasuje do reguł sieciowych i zespołu operacyjnego.
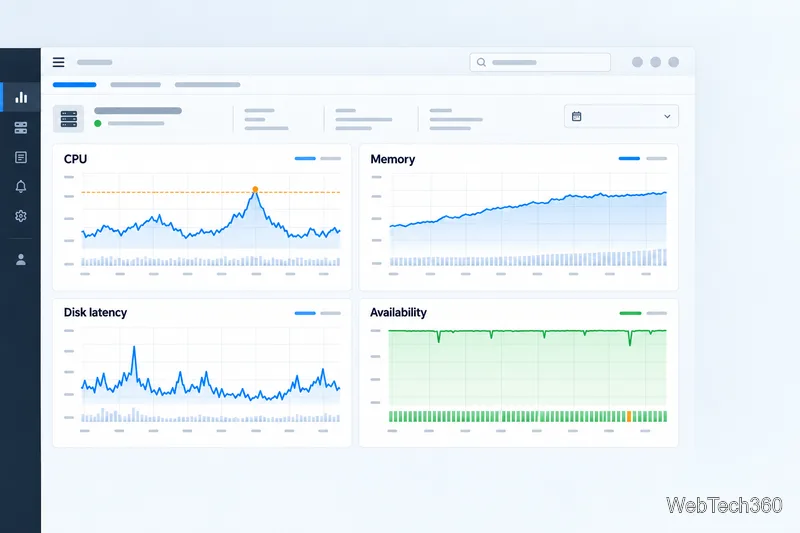
Widok floty może oznaczać wyjątki dotyczące procesora, pamięci, dysku i dostępności na hostach Windows.
Sześć narzędzi do monitorowania systemu Windows Server do porównania
Monitorowanie międzyplatformowe oparte na agentach
Monitorowanie infrastruktury Datadog
Hostowany monitoring dla stosów hybrydowych
1. Monitor serwera i aplikacji SolarWinds (SAM)
SolarWinds SAM łączy objawy problemów z serwerem ze stanem aplikacji. Szablony obejmują obciążenia Microsoft, takie jak IIS, SQL Server, Exchange i Active Directory. Używaj SAM jako samodzielnego modułu Orion lub jako części SolarWinds Observability Self-Hosted.
Rozwiązanie jest odpowiednie dla zespołów, które potrzebują kontekstu aplikacji i widoków rozwiązywania problemów. Aktualne licencjonowanie jest oparte na subskrypcji i skalowalne w oparciu o monitorowane węzły; ceny ustalane są na podstawie wyceny. Sprawdź, jakich komponentów platformy potrzebuje Twój zespół, zanim porównasz je z węższym monitorem serwerów.
Monitorowanie aplikacji dodaje informacje o stanie usług i zależnościach do metryk hosta.
2. Menedżer operacji ManageEngine
ManageEngine OpManager łączy monitorowanie serwerów i sieci. Monitoruje czas sprawności, procesor, pamięć, procesy, usługi i miejsce na dysku, z opcjami opartymi na agencie i bezagentowymi.
W systemie Windows korzysta z WMI; ManageEngine dokumentuje również WinRM jako transport, gdy porty DCOM/RPC są ograniczone. Nadal musisz zaplanować poświadczenia i reguły zapory, więc przetestuj łączność przed wdrożeniem wielu serwerów. OpManager jest odpowiedni dla zespołów, które chcą monitorować stan serwerów i sieci we współdzielonej konsoli.
3. Monitor sieciowy Paessler PRTG
Monitor sieci PRTG wykorzystuje WMI, SNMP i PowerShell do monitorowania metryk, liczników wydajności, usług i aplikacji systemu Windows Server. Model czujników ułatwia wybieranie poszczególnych pomiarów i tworzenie jednego widoku obejmującego serwery i urządzenia sieciowe.
Wykresy trendów pomagają odróżnić krótkotrwałe skoki od długotrwałych problemów z zasobami lub ich dostępnością.
4. Zabbix
Zabbix to platforma monitorująca typu open source, która nie wymaga opłat licencyjnych za oprogramowanie. Monitorowanie systemu Windows wykorzystuje agenta działającego jako usługa systemu Windows, skonfigurowanego na serwerze Zabbix i interfejsie użytkownika. Oficjalny podręcznik zawiera podstawowe metryki i alerty.
Zabbix jest odpowiedni dla zespołów, które chcą mieć kontrolę nad szablonami, wyzwalaczami i wdrożeniami. Kompromisem jest własność: zarządzasz serwerem, bazą danych, aktualizacjami, agentami, regułami alertów i przechowywaniem danych. Zapoznaj się z przewodnikiem monitorowania systemu Windows , aby oszacować nakład pracy związany z konfiguracją.
5. Checkmk
Checkmk dla systemu Windows używa agenta do raportowania zużycia procesora, pamięci, dysku, usług, procesów, interfejsów sieciowych i systemów plików. Warto rozważyć tę opcję, jeśli monitorujesz system Windows i system Linux i chcesz mieć wspólny przepływ pracy w zakresie wykrywania usług.
Zainstaluj agenta jako pakiet MSI i zarejestruj go w Checkmk; obecny kontroler agentów obsługuje szyfrowany protokół TLS po rejestracji. Dostępne są edycje społecznościowe i komercyjne, dlatego należy porównać ich ograniczenia funkcji i skalę. Przewodnik po agencie dla systemu Windows wyjaśnia zasady wdrażania.
6. Monitorowanie infrastruktury Datadog
Monitorowanie infrastruktury Datadog to hostowana opcja dla zespołów, które już korzystają z Datadog lub monitorują system Windows wraz z obciążeniami w chmurze i kontenerach. Agent systemu Windows zbiera metryki hosta; integracje mogą obejmować sprawdzanie usług i dzienników zdarzeń systemu Windows. Instalacja agenta wymaga klucza API Datadog.
Model hostowany pozwala uniknąć samodzielnego uruchamiania platformy centralnej, ale dodaje agenta i wysyła dane telemetryczne do Datadog. Plany komercyjne korzystają z cennika opartego na hoście, który różni się w zależności od planu i zobowiązania. Oszacuj koszty na podstawie liczby hostów oraz wszelkich potrzebnych logów lub dodatkowych produktów, a następnie zapoznaj się z dokumentacją agenta systemu Windows i aktualnym cennikiem .
Jak wybrać i przetestować narzędzie
Dopasuj go do awarii, którą chcesz wykryć. Nadaj priorytet sprawdzeniu usług i aplikacji pod kątem problemów z obciążeniem; wybierz łączoną konsolę serwerową i sieciową, jeśli oba systemy są własnością tego samego zespołu.
Przetestuj kolekcję na reprezentatywnych hostach. Przed szerokim wdrożeniem zweryfikuj obsługę systemu Windows Server i ról, poświadczenia, ścieżki zapory sieciowej i uprawnienia agenta.
Uczyń alerty możliwymi do wykonania. Zacznij od dostępności, stanu usług krytycznych, pojemności dysku i trendów dotyczących zasobów. Przypisz właściciela i dostosuj progi podczas pilotażu.
Porównaj koszty operacyjne. Uwzględnij licencje lub limity czujników, hostowaną telemetrię, konserwację platformy, aktualizacje agentów i czas pracy personelu.
Przeprowadź pilotaż dwóch lub trzech opcji na tych samych serwerach reprezentatywnych. Najlepszym rozwiązaniem jest takie, które daje Twojemu zespołowi jasne sygnały i użyteczny kontekst aplikacji, bez generowania dodatkowych kosztów konserwacji i kosztów, których środowisko nie jest w stanie obsłużyć.