Serwer domowy Matrix Synapse może wyglądać na sprawny przez wiele dni, a potem nagle PostgreSQL zużywa większość dostępnej pamięci RAM maszyny. Typowe objawy są znane: pamięć wymiany zaczyna się rozrastać, synchronizacja klientów zwalnia, kolejkowanie zadań federacyjnych i administrowanie skromnym serwerem staje się trudne. Ważnym pierwszym krokiem jest nie zakładanie, że PostgreSQL ma wyciek. Wysokie zużycie pamięci może wynikać z kilku niezależnych źródeł, w tym ze współdzielonej pamięci podręcznej bufora, pamięci roboczej dla każdego zapytania, wielu zapleczy baz danych, pracowników obsługi technicznej oraz nieefektywnych zapytań spowodowanych nieaktualnymi statystykami lub rotacją tabel.
Własna dokumentacja firmy Synapse zaleca PostgreSQL do zastosowań produkcyjnych i udostępnia kontrolki puli połączeń z bazą danych, takie jak cp_mini cp_max. PostgreSQL ostrzega, że ustawienia takie jak work_memmogą być używane przez wiele operacji w ramach jednego zapytania i przez wiele sesji jednocześnie. Ta kombinacja sprawia, że ustawienie, które wygląda na nieszkodliwe w izolacji, może stać się kosztowne w okresie wzmożonego ruchu. Najbezpieczniejszym rozwiązaniem jest najpierw dokonać pomiarów, następnie ograniczyć zbędną współbieżność, a następnie dostosować pamięć i zachowanie konserwacji tylko tam, gdzie dowody na to wskazują.
Krok 1: Sprawdź, czy PostgreSQL jest rzeczywiście źródłem obciążenia pamięci
Zacznij od poziomu systemu operacyjnego. W systemie Linux porównaj całkowitą pamięć, pamięć dostępną, pamięć wymiany i największe procesy:
free -h
ps aux --sort=-%mem | head -n 15
Nie oceniaj serwera na podstawie pojedynczej linii procesu. PostgreSQL korzysta zarówno z pamięci współdzielonej, jak i prywatnej w procesach zaplecza, więc warto zadać sobie pytanie, czy host rzeczywiście jest pod presją: mało dostępnej pamięci, rosnąca liczba pamięci wymiany, braki pamięci (OOM) czy utrzymujące się opóźnienie. Rejestruj wyniki w okresie ciszy i ponownie w okresie wzmożonego ruchu. Taka linia bazowa umożliwia mierzenie późniejszych zmian, a nie opiera się na domysłach.
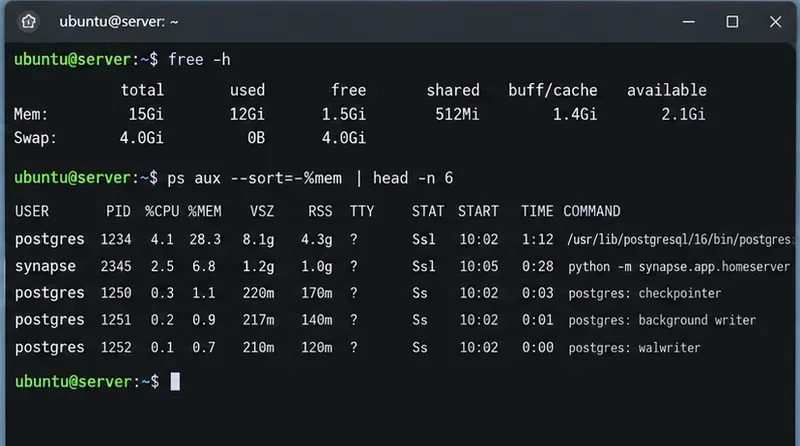
Podpis: Przed zmianą konfiguracji przeprowadzana jest kontrola pamięci, podczas której porównywana jest dostępna pamięć RAM na poziomie hosta z procesami PostgreSQL i Synapse.
Następnie sprawdź ustawienia PostgreSQL, które najprawdopodobniej mają wpływ na pamięć:
SHOW shared_buffers;
SHOW work_mem;
SHOW maintenance_work_mem;
SHOW autovacuum_work_mem;
SHOW max_connections;
Dokumentacja dotycząca zużycia zasobów w PostgreSQL opisuje kluczową różnicę. shared_buffersJest to współdzielona pamięć podręczna dla całego serwera. Z kolei work_memjest to limit dla pojedynczych operacji sortowania lub haszowania, zanim zostaną one przeniesione do plików tymczasowych; złożone zapytanie może obejmować kilka takich operacji, a wiele sesji może uruchamiać je jednocześnie. PostgreSQL obecnie podaje 4 MB jako wartość domyślną work_memi zauważa, że całkowite wykorzystanie może być wielokrotnie wyższe.
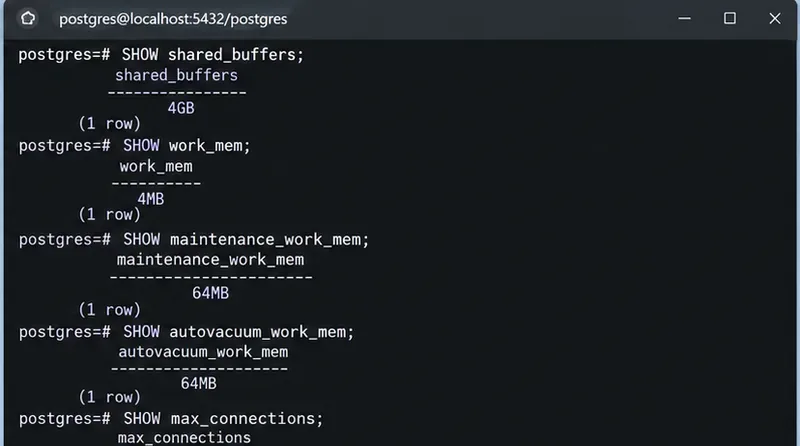
Podpis: Przed zmianą ustawień PostgreSQL należy je uważnie przeczytać. Niebezpieczną wartością jest często kombinacja ustawień i współbieżności, a nie pojedyncza liczba.
Krok 2: Zlicz połączenia z bazą danych Synapse i znajdź aktywną pracę
Duża pula połączeń nie zużywa automatycznie zasobów work_memdla każdego połączenia, ale każdy backend PostgreSQL ma swój własny proces i pamięć prywatną, a większa liczba współbieżnych zapytań stwarza więcej możliwości alokacji pamięci dla każdej operacji. Sprawdź, ile połączeń jest faktycznie otwartych i w jakim są stanie:
SELECT state,
       usename,
       application_name,
       count(*) AS connections
FROM pg_stat_activity
GROUP BY state, usename, application_name
ORDER BY connections DESC;
Następnie sprawdź długotrwałe aktywne zapytania:
SELECT pid,
       usename,
       state,
       now() - query_start AS running_for,
       wait_event_type,
       wait_event,
       left(query, 180) AS query
FROM pg_stat_activity
WHERE state <> 'idle'
ORDER BY query_start;
Oficjalna dokumentacja wyjaśnia pola sesji i aktywności. Duża liczba bezczynnych sesji różni się od niewielkiej liczby kosztownych aktywnych zapytań, więc rozwiązanie również powinno być inne. Jeśli problemem jest liczba połączeń lubpg_stat_activity rozmiar puli adresów. Jeśli problemem jest kilka zapytań wymagających dużej ilości pamięci, samo obniżenie puli może jedynie ukryć symptom.
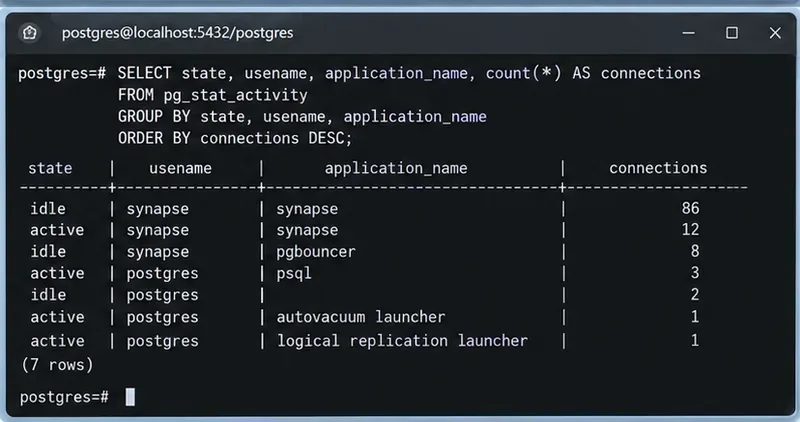
Podpis: Grupowanie pg_stat_activityułatwia odróżnienie wielu nieaktywnych zapleczy od mniejszego zbioru aktywnych sesji bazy danych.
Krok 3: Dopasuj rozmiar puli połączeń Synapse PostgreSQL
Synapse przekazuje większość argumentów bazy danych do PostgreSQL, jednocześnie konsumując opcje zaczynające się od cp_dla puli połączeń Twisted. Aktualny przewodnik po Synapse PostgreSQL pokazuje przykład z cp_min: 5i cp_max: 10. Należy je traktować jako wartości przykładowe, a nie jako cel uniwersalny.
Sprawdź databaseblok w homeserver.yaml:
database:
  name: psycopg2
  args:
    user: synapse_user
    password: "your-secret"
    dbname: synapse
    host: 127.0.0.1
    cp_min: 5
    cp_max: 10
Jeśli wcześniej agresywnie zwiększałeś/ aś liczbę połączeń Synapse cp_maxi pg_stat_activitywykazywał/aś dużą liczbę, w większości bezczynnych, stopniowo ją zmniejszaj i obserwuj opóźnienie żądań. W przypadku wdrożenia Synapse opartego na procesach roboczych pamiętaj, że zapotrzebowanie na bazę danych pochodzi z wielu procesów Synapse, dlatego oceniaj łączną liczbę połączeń, a nie liczbę połączeń z jednego procesu roboczego oddzielnie. W podręczniku konfiguracji Synapse potwierdzono, że cp_opcje konfigurują pulę połączeń.
Po edycji konfiguracji uruchom ponownie odpowiedni proces lub procesy Synapse zgodnie z metodą wdrożenia, a następnie ponownie uruchom zapytanie o liczbę połączeń. Nie zmniejszaj puli, dopóki żądania nie zaczną się kolejkować, aby zaoszczędzić kilka megabajtów. Zbyt mała pula może spowodować, że współbieżność bazy danych przełoży się na opóźnienia aplikacji.
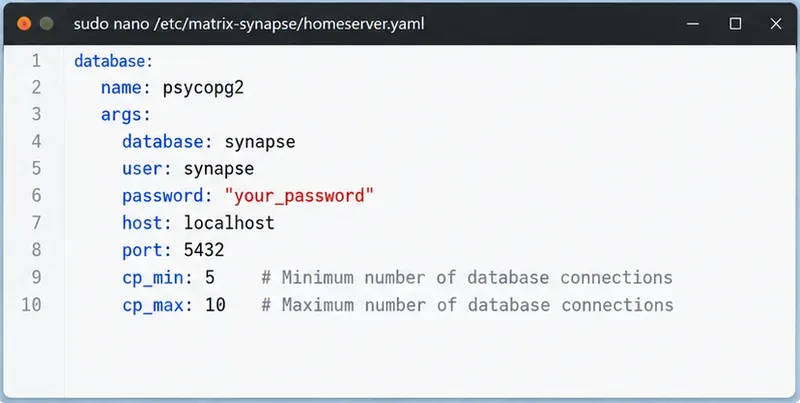
Podpis: Synapse udostępnia cp_mini cp_maxw konfiguracji bazy danych PostgreSQL, umożliwiając administratorom ograniczenie niepotrzebnej współbieżności zaplecza.
Krok 4: Konserwatywne dostrajanie pamięci PostgreSQL
Gdy liczba połączeń będzie rozsądna, sprawdź ustawienia pamięci PostgreSQL w kontekście pamięci RAM faktycznie dostępnej dla bazy danych. PostgreSQL twierdzi, że na dedykowanym serwerze bazy danych z co najmniej 1 GB pamięci RAM, około 25% pamięci systemowej to rozsądny punkt wyjścia shared_buffers. Te wytyczne dotyczą wyłącznie dedykowanego serwera bazy danych. Jeśli Synapse, odwrotny serwer proxy, Redis, monitorowanie i PostgreSQL współdzielą jedną małą maszynę wirtualną, PostgreSQL nie jest właścicielem całej maszyny, więc odpowiednio zaplanuj budżet.
Ustawieniem, które najprawdopodobniej zaskoczy administratorów, jest work_mem. Unikaj mnożenia work_memprzez max_connectionsi traktowania tego jako sztywnej rezerwacji; PostgreSQL nie alokuje jej wstępnie w ten sposób. Zamiast tego myśl o współbieżnych operacjach zapytań. Pojedyncze zapytanie może używać kilku węzłów sortowania lub haszowania, a operacje haszowania mogą używać wielokrotności work_mem. Jeśli globalnie ustawisz work_membardzo dużą liczbę, ponieważ jeden raport był powolny, okres federacji lub intensywnej synchronizacji może spowodować znacznie większy szczyt zużycia pamięci niż oczekiwano.
Rozsądnym rozwiązaniem jest zachowanie konserwatywnej wartości globalnej i podniesienie jej tylko na czas konkretnej sesji administracyjnej, gdy znane zapytanie potrzebuje więcej pamięci. Przed zmianą wartości należy zachować istniejącą konfigurację i zanotować, które parametry wymagają ponownego uruchomienia PostgreSQL. shared_buffersNa przykład, jest ustawieniem startowym serwera. Zmiany powinny być planowane, aby można było porównać pamięć, opóźnienie i zachowanie plików tymczasowych przed i po.
Sprawdź również maintenance_work_memi autovacuum_work_mem. PostgreSQL zauważa, że procesy automatycznej próżni mogą alokować pamięć konserwacyjną jednocześnie. Jeśli autovacuum_work_mempozostawimy odziedziczone zachowanie, nietypowo duża wartość maintenance_work_memmoże sprawić, że jednoczesne działanie kilku procesów automatycznych próżni będzie kosztowne. Nie należy wyłączać funkcji automatycznej próżni w celu oszczędzania pamięci RAM; zazwyczaj powoduje to zamianę krótkotrwałego problemu z pamięcią na rozdęcie tabeli, nieaktualne statystyki i gorszą wydajność.
Krok 5: Sprawdź stan odkurzacza, a następnie zweryfikuj poprawkę pod rzeczywistym obciążeniem
Synapse zapisuje i aktualizuje duże ilości danych zdarzeń i stanu. PostgreSQL wymaga rutynowego odkurzania, aby odzyskać nieużywane krotki do ponownego użycia i utrzymać aktualność statystyk planisty. Przewodnik po rutynowym odkurzaniu w PostgreSQL zaleca automatyczne odkurzanie w większości instalacji.
Szukaj tabel z wieloma szacowanymi martwymi krotkami lub nieaktualnymi znacznikami czasu konserwacji:
SELECT relname,
       n_live_tup,
       n_dead_tup,
       last_autovacuum,
       last_autoanalyze
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;
Jeśli konkretna tabela wyraźnie wymaga uwagi, VACUUM (ANALYZE)zwykle pierwszym narzędziem, jakie należy rozważyć, jest tabela normalna:
VACUUM (ANALYZE) your_table_name;
Unikaj przeskakiwania od razu do VACUUM FULL. Oficjalne źródło VACUUM wyjaśnia, że tryb regularny VACUUMmoże działać równolegle z normalnymi odczytami i zapisami, jednocześnie VACUUM FULLprzepisując tabelę i blokując ACCESS EXCLUSIVEją. Używaj tego drugiego trybu tylko wtedy, gdy odzyskiwanie miejsca na dysku jest warte planowanego zakłócenia.
Jak stwierdzić, czy zmiana faktycznie zadziałała
Sprawdź wynik dla tego samego rodzaju obciążenia, które spowodowało problem. Skuteczne rozwiązanie to nie tylko stwierdzenie, że „Postgres natychmiast zużywa mniej pamięci RAM”. Pamięć podręczna bazy danych powinna być używana. Zamiast tego sprawdź, czy dostępna pamięć jest stabilna, czy występuje niewielki lub żaden nieoczekiwany wzrost pamięci wymiany, czy nie występują zdarzenia OOM, czy liczba połączeń jest zgodna z oczekiwaną współbieżnością, oraz czy czasy odpowiedzi Synapse są akceptowalne.
- Uruchom
free -hi wypisz procesy na tym samym poziomie ruchu, jaki został użyty w konfiguracji bazowej.
- Powtórz
pg_stat_activityzapytanie o połączenie i sprawdź, czy liczba bezczynnych zasobów zaplecza spadła, jeśli zmieniłeś pulę Synapse.
- Obserwuj opóźnienie zapytań i synchronizacji po obniżeniu
cp_max; cofnij zmianę, jeśli czas oczekiwania na bazę danych zauważalnie się zwiększy.
- Sprawdzaj
pg_stat_user_tablesz czasem, czy odkurzacz automatyczny rzeczywiście obsługuje zajęte stoliki.
- Jeśli obniżysz tę wartość
work_mem, sprawdź, czy duże sortowania nie rozprzestrzeniają się nadmiernie do plików tymczasowych, zanim obniżysz ją jeszcze bardziej.
Jeśli po tych sprawdzeniach PostgreSQL nadal rośnie, aż do momentu, gdy host intensywnie się przełączy, należy przechwycić listę aktywnych zapytań podczas skoku obciążenia i zbadać obciążenie, zamiast wielokrotnie zmniejszać globalne limity pamięci. W obsługiwanych wersjach PostgreSQL pg_backend_memory_contextsmożliwe jest sprawdzenie kontekstów pamięci dla bieżącego zaplecza; dokumentacja widoku systemowego PostgreSQL opisuje widok i jego uprawnienia. Jest to bardziej przydatne w przypadku ukierunkowanego badania bazy danych niż zakładanie, że każde wdrożenie Synapse z dużą ilością pamięci ma tę samą przyczynę.
Podsumowanie
W przypadku Matrix Synapse w PostgreSQL wysokie zużycie pamięci bazy danych najbezpieczniej jest korygować warstwowo: należy udowodnić, że host jest pod rzeczywistym obciążeniem pamięci, zliczyć sesje bazy danych, odpowiednio dostosować rozmiar puli Synapse, zachować konserwatywne zużycie pamięci na operację w PostgreSQL i upewnić się, że automatyczne odkurzanie działa prawidłowo. Celem nie jest jak najmniejsze wykorzystanie pamięci PostgreSQL. Celem jest przewidywalne zużycie pamięci bez przekształcania normalnego buforowania i współbieżności bazy danych w zbędną wymianę, zdarzenia OOM (obecnie brak pamięci) lub powolne działanie klientów Matrix.









