Acasă
» ADMIN. REȚEA
»
Cum să monitorizezi metricile Jitsi Videobridge cu Prometheus și Grafana
Cum să monitorizezi metricile Jitsi Videobridge cu Prometheus și Grafana
Când o întâlnire Jitsi începe să se întrerupă, un administrator poate observa reclamații despre sunetul sacadat sau video blocat, dar nu are o modalitate rapidă de a spune dacă bridge-ul este supraîncărcat, inaccesibil sau pur și simplu transportă mai mult trafic decât de obicei. Jitsi Videobridge (JVB) expune indicatori operaționali pe care Prometheus îi poate colecta și Grafana îi poate afișa. Acest ghid prezintă o configurare practică, începând cu o verificare a endpoint-ului local și terminând cu un tablou de bord pe care îl puteți verifica.
Scenariu exemplu: Imaginați-vă o organizație mică care rulează un JVB pe o gazdă Linux și Prometheus și Grafana pe aceeași gazdă. Acesta este un exemplu ilustrativ, nu un raport al unei implementări sau testări reale. Dacă serviciile dvs. rulează în containere separate sau pe servere diferite, înlocuiți adresele lor interne accesibile și păstrați aceleași restricții de rețea.
Ce veți monitoriza
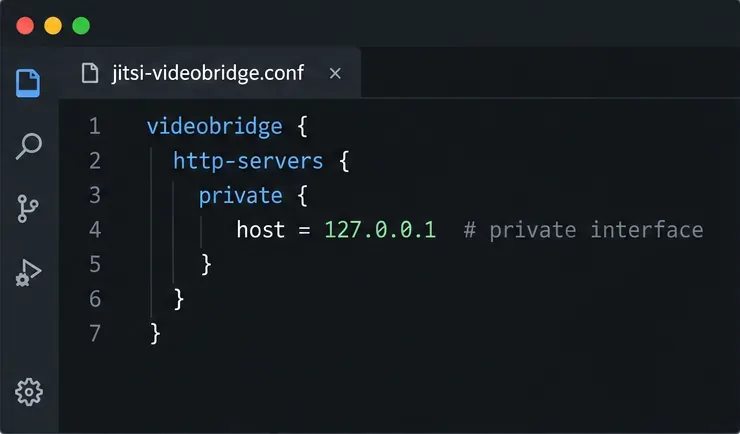
Documentația actuală a proiectului JVB descrie un punct final Prometheus/OpenMetrics încorporat pe /metricsinterfața HTTP privată a bridge-ului. Aceasta listează statistici precum conferințe active, puncte finale, rata de biți de intrare și ieșire, ratele pachetelor și stresul bridge-ului. Expunerea Prometheus nu conține neapărat toate statisticile disponibile prin celelalte formate de raportare JVB, așadar tratați punctul final furnizat de versiunea instalată ca sursă de adevăr. Configurația de referință activează în prezent resursa Prometheus REST și leagă interfața HTTP privată la loopback; portul HTTP privat implicit documentat este 8080. Pachetele și șabloanele de implementare mai vechi pot diferi.
Prometheus extrage și stochează seriile temporale. Grafana se conectează la Prometheus ca sursă de date și interoghează acele serii stocate. Nu este necesar un exportator Jitsi separat pentru această cale directă de metrici JVB. Consultați statisticile Jitsi și documentația endpoint-ului Prometheus , configurația interfeței HTTP private și configurația de referință . Aceste fișiere din amonte se pot modifica; verificați configurația și versiunea instalată pe propriul bridge înainte de a aplica valori exemplu.
Pasul 1: Confirmați că JVB furnizează valori de referință
Pe mașina JVB, identificați mai întâi configurația activă. Un pachet Debian sau Ubuntu obișnuit folosește /etc/jitsi/videobridge/jvb.conf, dar Jitsi notează că fișierul real este oricare cale este transmisă procesului bridge. Implementările de containere pot monta în schimb o configurație generată. Nu presupuneți că un fișier exemplu este cel citit de serviciul care rulează.
Exemplu: interfața HTTP JVB privată este legată de loopback, deci doar procesele locale o pot accesa.
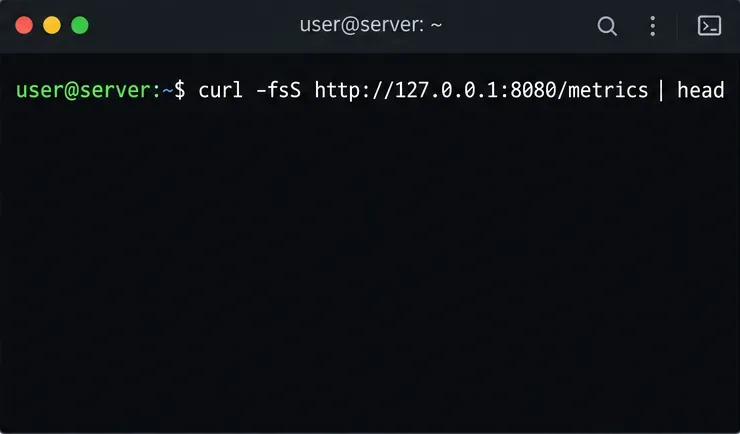
Cu portul implicit și legătura loopback din exemplu, executați această comandă pe gazda JVB:
curl -fsS http://127.0.0.1:8080/metrics | head
Verificați endpoint-ul local /metricsînainte de a configura Prometheus.
Un răspuns reușit este un text simplu care conține familii de metrici Prometheus, adesea cu linii # HELP`și` # TYPEurmate de exemple. Ilustrația prezintă doar comanda; nu este o dovadă a unui răspuns activ al serverului. Un refuz al conexiunii înseamnă de obicei că JVB este oprit, ascultă la o altă adresă sau port sau că configurația instalată dezactivează acel listener HTTP. Un mesaj HTTP 404 sugerează că serverul a răspuns, dar ruta nu este disponibilă în configurația de compilare sau API respectivă. Verificați jurnalele JVB și configurația versiunii instalate, în loc să activați API-ul de control Colibri, fără legătură, doar pentru a face calea Prometheus să funcționeze.
Puteți inspecta direct numele și tipurile de metrici cu:
JVB documentează faptul că metricile Prometheus disponibile nu sunt o oglindă completă a statisticilor sale JSON. De asemenea, documentează histogramele de dimensiunea conferinței disponibile numai în formatul Prometheus. Verificați ce returnează de fapt versiunea instalată înainte de a scrie interogări PromQL sau de a importa un tablou de bord care presupune anumite nume.
Pasul 2: Păstrați interfața privată privată
Când Prometheus rulează pe aceeași gazdă ca JVB, lăsați interfața privată activată 127.0.0.1. Aceasta evită deschiderea unui alt listener pentru rețeaua dvs. În configurația ipotetică cu aceeași gazdă, ținta 127.0.0.1:8080poate fi atinsă direct de Prometheus.
Dacă Prometheus rulează în altă parte, legătura implicită de loopback a JVB nu va accepta conexiuni de la aceasta. Puteți configura ascultătorul privat să se lege la o interfață internă accesibilă de Prometheus, apoi să restricționați firewall-ul sau rețeaua de containere astfel încât doar gazda Prometheus să se poată conecta la portul privat. Nu expuneți portul 8080 sau 8443 la internetul public: Jitsi descrie explicit această interfață ca fiind privată și spune că punctele sale finale nu sunt destinate accesului public. Dacă mediul necesită criptare în tranzit, interfața privată acceptă TLS atunci când este configurată cu un keystore; alternativ, utilizați un proxy TLS intern strict controlat. Evitați copierea unei legături publice largi, cum ar fi 0.0.0.0fără o restricție de acces însoțitoare.
După modificarea unei setări de ascultare, utilizați mecanismul de configurare acceptat de implementare și reporniți sau reîncărcați JVB doar conform cerințelor versiunii respective. O repornire poate întrerupe apelurile pe o implementare cu un singur pod, așadar programați-o corespunzător. În Docker, editați configurația persistentă pe partea gazdă sau mediul utilizat pentru a o genera, nu un fișier container tranzitoriu. Verificați ascultătorul de pe mașina Prometheus cu curlînainte de a continua.
Pasul 3: Adăugați o lucrare de scrape Prometheus
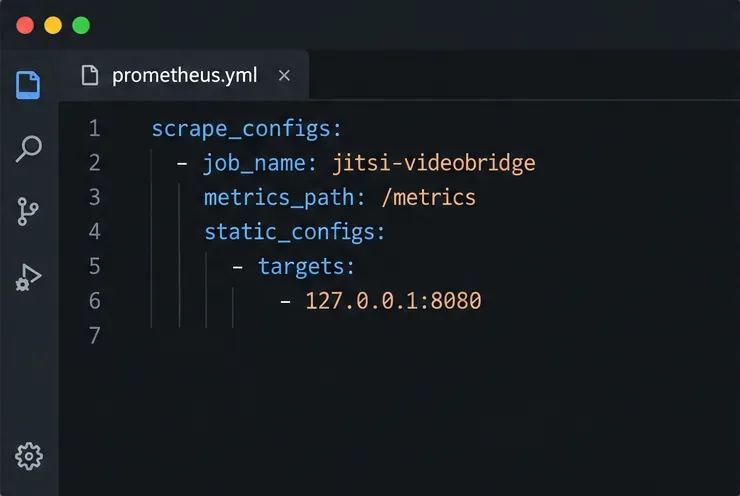
Adăugați o lucrare de scrape la fișierul de configurare Prometheus. Pentru exemplul cu aceeași gazdă, secțiunea relevantă este:
Ținta de scrape trebuie să fie accesibilă din procesul Prometheus; înlocuiți loopback-ul cu adresa privată atunci când serviciile se află pe gazde separate.
Configurația Prometheus utilizează scrape_configsși acceptă ținte statice pentru o implementare fixă de dimensiuni reduse. Dacă JVB-ul se află într-un container diferit, 127.0.0.1indică containerul Prometheus în sine; utilizați numele serviciului JVB și portul dintr-o rețea Docker privată partajată. Pentru o gazdă la distanță, utilizați numele sau adresa DNS privată și mențineți regula firewall restrânsă. Referința de configurare Prometheus explică joburile de scrape, țintele și setările de interval.
Înainte de a aplica o modificare, validați fișierul complet cu utilitarul Prometheus livrat odată cu instalarea:
Dacă validarea reușește, reîncărcați Prometheus folosind metoda configurată pentru serviciul dvs. sau reporniți-l dacă reîncărcările nu sunt activate. Nu deduceți succesul doar dintr-un fișier YAML valid; o țintă validă din punct de vedere sintactic poate fi totuși inaccesibilă.
Pasul 4: Conectați Grafana la Prometheus
În Grafana, adăugați sursa de date Prometheus încorporată și introduceți adresa URL la care Grafana poate ajunge. Pe o gazdă, aceasta ar putea fi http://localhost:9090dacă Grafana rulează direct pe acea gazdă. Când Grafana rulează într-un container, înseamnă containerul Grafana, nu gazda sau containerul Prometheus; utilizați numele serviciului Prometheus într-o rețea partajată. Salvați și testați sursa de date. Ghidul sursei de date Prometheuslocalhost al Grafana descrie setările de conexiune, iar documentația sursei de date explică modul în care Grafana interoghează un backend de metrici.
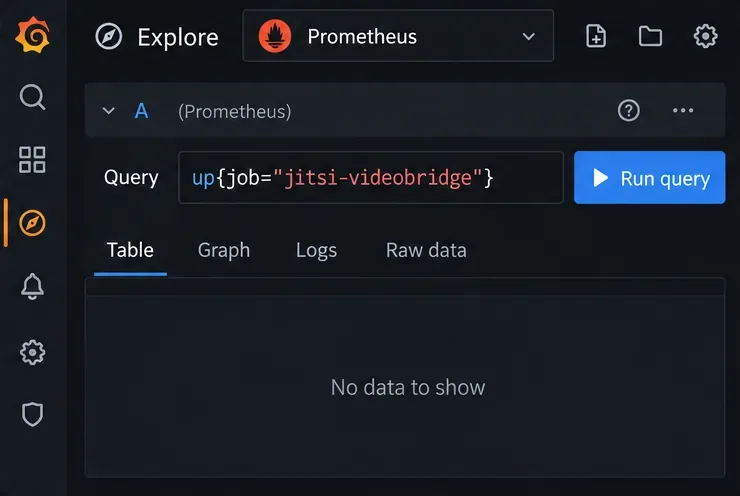
Deschideți Explore, selectați Prometheus și rulați up{job="jitsi-videobridge"}. Aceasta este o verificare a stării de funcționare prin extragerea datelor de către Prometheus, nu o metrică Jitsi. O valoare de 1 înseamnă că Prometheus a extras cu succes datele din țintă pentru evaluarea curentă; 0 înseamnă că o țintă configurată eșuează. Dacă interogarea nu returnează nicio serie, confirmați numele exact al jobului, reîncărcarea configurației, descoperirea țintei și intervalul de timp selectat.
Folosește seria generică Prometheus uppentru a verifica starea de funcționare a scrape-ului înainte de a interoga metricile specifice JVB.
Pasul 5: Construiți un tablou de bord util și verificați datele
Odată ce upfuncționalitatea este sănătoasă, utilizați browserul de metrici din Grafana Explore sau browserul de expresii din Prometheus pentru a găsi seria JVB expusă de versiunea dvs. Începeți cu un set mic de întrebări operaționale:
Câte conferințe și endpoint-uri sunt active și cum se modifică aceste număruri pe parcursul zilei?
Se modifică rata de biți RTP sau seria de rate de pachete de intrare și ieșire pe măsură ce crește sarcina întâlnirii?
Seria de solicitări ale punții crește odată cu numărul de puncte finale sau este deja ridicată la o sarcină modestă?
Sunt disponibile metrici pentru thread-uri și colectarea gunoiului JVM și se modifică acestea în funcție de rapoartele de apelare lentă?
Folosește numele metricilor și unitățile imprimate de propriul /metricsendpoint. Referința statistică Jitsi descrie exemple precum conferences, endpoints, bit_rate_download, bit_rate_upload, și stress_levelîn lista de statistici acceptate, dar avertizează că nu toate statisticile sunt expuse în prezent în format Prometheus. Nu lipește aceste nume într-o interogare până când nu confirmi că familia Prometheus există în versiunea ta. Pentru contoare cumulative, folosește funcții PromQL, cum ar fi rate()peste un interval; pentru indicatoare instantanee, cum ar fi numărul curent de conferințe, reprezintă grafic direct valoarea eșantionată. Păstrează unitățile documentate atunci când etichetezi panourile, deoarece câmpurile de rată de biți și ratele de pachete utilizează unități diferite.
Creați un tablou de bord cu câteva panouri de serii temporale, unități clare și un interval de timp care include extrageri recente. Evitați să tratați o serie lipsă ca fiind zero: lipsa datelor poate indica o nepotrivire ortografică, o metrică neacceptată sau o eroare de extragere. Pentru alerte, începeți cu disponibilitatea țintei și apoi adăugați praguri numai după ce ați observat trafic normal pentru propria implementare. Un număr universal de „stres ridicat” poate induce în eroare, deoarece capacitatea depinde de gazdă, mixul de media și configurație.
Verificați configurația finalizată
Rulați această secvență de la cea mai ușoară la cea mai specifică:
Pe gazda JVB, solicitați http://127.0.0.1:8080/metricsși confirmați că răspunsul conține textul metricii.
De la gazda sau containerul Prometheus, solicitați același punct final folosind adresa privată configurată. Un succes local nu dovedește accesibilitatea de la distanță.
În vizualizarea Ținte a lui Prometheus, confirmați că jitsi-videobridgeținta este activă și inspectați ultima eroare de scrape dacă este neactivă.
În Grafana Explore, confirmarea up{job="jitsi-videobridge"}returnează 1, apoi interogarea unui nume de metrică JVB copiat din endpoint-ul live.
Deschideți un tablou de bord pe un interval de timp care include mai multe intervale de extragere a datelor și verificați dacă unitățile, etichetele și marcajele temporale au sens.
Dacă endpoint-ul funcționează local, dar Prometheus raportează o eroare de conexiune, verificați din nou adresa de legare, portul, firewall-ul și rețeaua containerului. Dacă ținta este activă, dar interogările JVB sunt goale, verificați numele exact exportat, intervalul de timp selectat și dacă statistica respectivă este prezentă în rezultatul Prometheus. Dacă tablourile de bord afișează date, dar calitatea întâlnirii încă are de suferit, valorile metrice ajută la restrângerea investigației; acestea nu identifică singure problema rețelei Wi-Fi locale, a browserului sau a rețelei de ultim kilometru a unui participant.
Această configurație respectă documentația Jitsi, Prometheus și Grafana din amonte, revizuită pe 6 octombrie 2026. Deoarece configurația de referință Jitsi și ecranele Grafana evoluează, comparați exemplele cu documentația și fișierele pentru versiunile exacte pe care le utilizați.