Acasă
» ADMIN. REȚEA
»
Cum să remediați problema sinapselor matriceale care rămân fără memorie în timpul sincronizării
Cum să remediați problema sinapselor matriceale care rămân fără memorie în timpul sincronizării
Începând cu 6 octombrie 2026, cea mai recentă versiune stabilă de Matrix Synapse este 1.162.0, publicată pe 29 septembrie 2026. Dacă serverul dvs. de acasă rămâne fără memorie în timpul sincronizării clienților, actualizarea la o versiune curentă acceptată este o primă verificare înțeleaptă, dar soluția durabilă este de obicei operațională, mai degrabă decât o singură setare magică. Synapse păstrează în mod intenționat datele și metadatele recente ale camerei în memorie pentru a face solicitările comune mai rapide, iar documentația oficială a administratorului avertizează că reducerea prea agresivă a memoriei cache poate agrava presiunea asupra memoriei prin crearea unei acumulari de solicitări lente.
Acest ghid urmărește calea pe care un administrator nou o poate folosi în siguranță: să înțeleagă ce înseamnă „sincronizare”, să confirme că procesul atinge într-adevăr o limită de memorie, să reducă presiunea evitabilă din cache, să separe traficul inițial de sincronizare neobișnuit de intens atunci când este necesar și să monitorizeze rezultatul. Scopul nu este pur și simplu de a reduce dimensiunea setului rezident. Scopul este de a opri blocările cauzate de memorie insuficientă, menținând în același timp receptivitatea serverului de acasă.
Ce înseamnă „sincronizare” în sinapsa matriceală
Un client Matrix apelează în mod repetat API-ul Client-Server /_matrix/client/v3/syncpentru a primi evenimente noi, cum ar fi mesaje, starea camerei, date despre cont, informații despre prezență și actualizări ale dispozitivului. O sincronizare normală continuă include de obicei un sincetoken, astfel încât Synapse trebuie să returneze modificările doar după punctul de sincronizare anterior.
O sincronizare inițială este diferită. Este prima sincronizare pentru un dispozitiv sau o sesiune și nu are un sincetoken anterior. Documentația oficială Synapse worker descrie aceste solicitări ca fiind potențial foarte intensive în resurse. Pe serverele de acasă mai mari, Synapse acceptă rutarea sincronizării inițiale separat de sincronizarea continuă, astfel încât câteva sincronizări inițiale costisitoare să nu perturbe pe toți ceilalți.
Înregistrați versiunea Synapse și metoda de instalare.
Faceți o copie de rezervă homeserver.yamla fișierelor de configurare worker, a configurației reverse-proxy și a bazei de date PostgreSQL, conform procedurii normale de backup.
Rețineți dacă Synapse rulează ca un singur proces, în containere sau ca un proces principal plus workeri.
Găsiți limita reală de memorie. Un container, o unitate systemd, un pod Kubernetes sau o mașină virtuală poate avea o limită mai mică decât serverul fizic.
Confirmați că PostgreSQL este utilizat pentru producție. Documentația actuală de instalare a Synapse menționează că SQLite este destinat testării și are performanțe slabe pentru sarcini de lucru de producție, în special în încăperi mari.
Pasul 1: Confirmați că epuizarea memoriei este adevărata eroare
Nu începeți prin a schimba valorile memoriei cache. Mai întâi identificați care proces Synapse consumă memorie și dacă este închis de sistemul de operare sau de o limită a containerului.
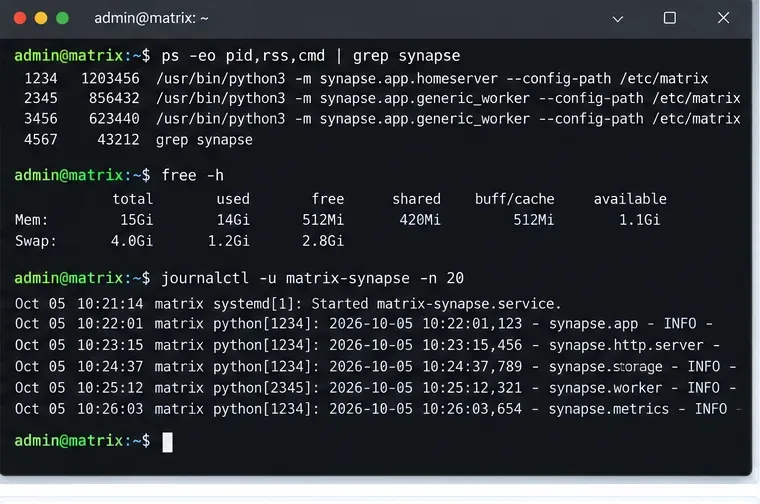
Începeți cu fluxul RSS al proceselor, memoria disponibilă, presiunea de swap și jurnalele recente ale serviciului Synapse, astfel încât să știți dacă problema este o epuizare reală a memoriei sau o altă eroare de sincronizare.
Pe o gazdă Linux, comenzi precum următoarele oferă o primă vedere rapidă:
Dacă folosești Docker, Podman, Kubernetes sau un alt planificator, verifică și limita de memorie a containerului sau a pod-ului. O gazdă cu câțiva gigabytes liberi poate totuși să oprească Synapse dacă procesul este restricționat la o limită mult mai mică a grupului de procesare (cgroup).
Căutați un model repetabil. Memoria crește doar atunci când un anumit utilizator se conectează pe un dispozitiv nou? Crește treptat pe parcursul zilei? Un proces generic crește în timp ce procesul principal rămâne stabil? Aceste observații disting un vârf de sincronizare inițială de creșterea generală a memoriei cache sau de restanțele la solicitări.
Pasul 2: Verificați setările cache înainte de a le reduce
O memorie cache reprezintă date pe care Synapse le păstrează în RAM, astfel încât să nu fie nevoie să recalculeze sau să reîncarce aceleași informații în mod repetat. Synapse are multe memorii cache, plus o memorie cache pentru evenimente. Referința de configurare documentează în prezent o valoare implicită caches.global_factorde 0,5, o event_cache_sizevaloare implicită de 10K înainte de aplicarea factorului global, o expirare a memoriei cache bazată pe timp și o sync_response_cache_durationvaloare implicită de 2 minute.
Soluția tentantă este să setați factorul global cât mai mic posibil. Nu faceți asta orbește. Întrebările frecvente pentru administratorii Synapse avertizează explicit că o memorie cache prea mică poate face un sistem lent și mai lent, permițând acumularea cererilor și provocând o explozie a utilizării memoriei din cauza întârzierilor în loc de intrări în memoria cache.
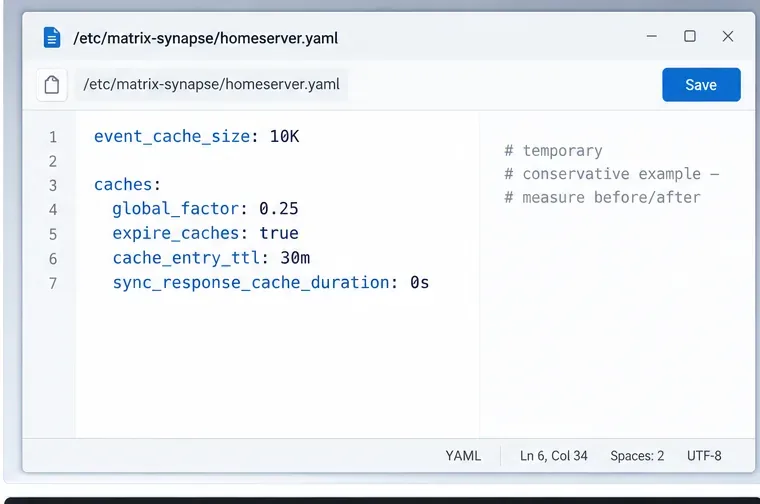
Efectuați modificările din memoria cache în mod conservator și măsurați rezultatul; exemplul ilustrează unde se află setările relevante, mai degrabă decât o valoare de producție universală.
Dacă profilarea arată că memoria cache este într-adevăr consumatorul dominant și debitul cererilor rămâne sănătos, încercați o reducere modestă, mai degrabă decât una drastică. De exemplu:
Acesta este un exemplu de depanare a problemelor, nu o valoare recomandată pentru fiecare server. Setarea sync_response_cache_durationla zero dezactivează memorarea în cache a /syncrăspunsurilor completate. Acest lucru poate economisi memorie atunci când sunt păstrate multe răspunsuri de sincronizare, dar poate face ca clienții care se reîntorc să depună mai mult efort. Testați-l în cadrul sarcinii de lucru reale.
Synapse oferă și reglare automată a memoriei cache cu max_cache_memory_usage, target_cache_memory_usage, și min_cache_ttl. Documentația oficială precizează că această funcție necesită jemalloc , un alocator alternativ de memorie, și că trebuie furnizate toate cele trei setări. Nu activați doar una sau două valori; documentația avertizează că o configurare incompletă poate cauza un comportament instabil.
Pasul 3: Asigurați-vă că baza de date nu creează o restanță a cererilor
Problemele de memorie în timpul sincronizării nu sunt întotdeauna cauzate de cantitatea de date stocate în cache. O bază de date lentă poate menține active mai multe solicitări simultan, iar fiecare solicitare în zbor consumă memorie. Acesta este motivul pentru care reducerea dimensiunii memoriei cache poate avea efecte inverse asupra spațiului de stocare deja lent.
Pentru producție, urmați ghidul oficial Synapse PostgreSQL . Verificați procesorul bazei de date, latența spațiului de stocare, saturația conexiunilor, interogările cu rulare lungă și dacă serverul PostgreSQL în sine se schimbă. Dacă latența sincronizării crește în același timp cu memoria rezidentă, investigați restanțele înainte de a reduce din nou memoria cache.
Dacă v-ați mutat recent în săli publice mari, v-ați unit în comunități mult mai mari sau ați adăugat mulți utilizatori activi, volumul de lucru ar putea pur și simplu să fi depășit o configurație care funcționa anterior. În acest caz, optimizarea bazei de date și izolarea lucrătorilor contează adesea mai mult decât eliminarea unei mici cantități din memoria cache.
Pasul 4: Izolați sincronizarea inițială pe serverele de acasă mai mari
Synapse poate rula ca un singur monolit , adică un proces principal pe serverul de acasă, sau poate împărți lucrul în workers , care sunt procese Synapse suplimentare care partajează aceeași bază de date PostgreSQL. Modelul worker este destinat instalațiilor mai mari care trebuie să scaleze independent sarcinile de lucru individuale.
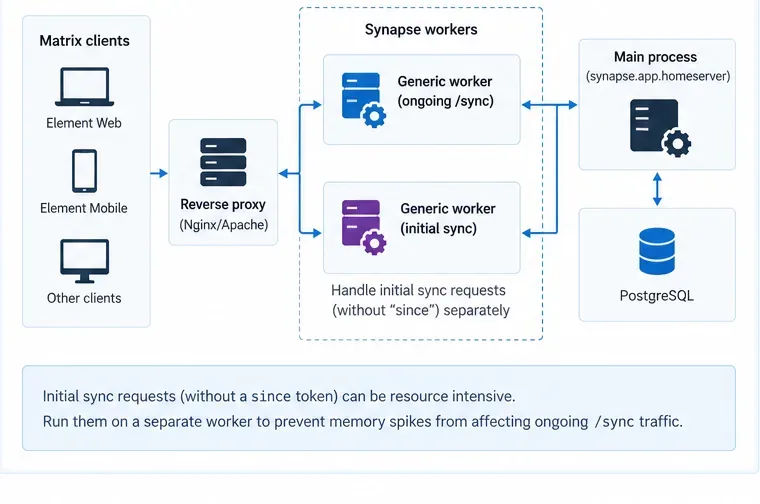
În implementările mai mari bazate pe PostgreSQL, rutați sincronizarea inițială costisitoare separat de sincronizarea continuă, astfel încât o primă conectare să nu consume același pool de lucrători ca actualizările normale ale clienților.
Documentația worker-ului precizează că un worker generic poate gestiona /syncși /initialSync. De asemenea, recomandă luarea în considerare a gestionării separate a cererilor de sincronizare fără un sinceparametru, deoarece aceste cereri de sincronizare inițială pot necesita multe resurse.
Cererile în curs de desfășurare /syncsunt trimise către unul sau mai mulți lucrători generici.
Cererile inițiale de sincronizare merg către un grup separat de lucrători generici.
Procesul principal continuă gestionând responsabilități care nu sunt delegate.
Toate procesele Synapse partajează PostgreSQL.
Nu expuneți listener-ul de replicare Synapse către internetul public. Documentația curentă a worker-ului avertizează că traficul de replicare este necriptat și neautentificat dacă nu este configurat un secret de replicare.
Adăugați workeri (workers) atunci când aveți dovezi că o anumită sarcină de lucru necesită izolare sau scalare orizontală.
Pasul 5: Reîncărcați factorii de cache în siguranță și observați rezultatul
Synapse permite reîncărcarea factorilor de cache cu SIGHUP. Referința de configurare oferă acest exemplu:
kill -HUP PID_OF_SYNAPSE_PROCESS
Dacă serviciul systemd inclus în pachet îl acceptă, systemctl reload matrix-synapsepoate efectua aceeași operațiune. Într-o implementare worker, documentația oficială precizează că configurația worker relevantă trebuie actualizată și fiecare worker trebuie să primească semnalul de reîncărcare individual.
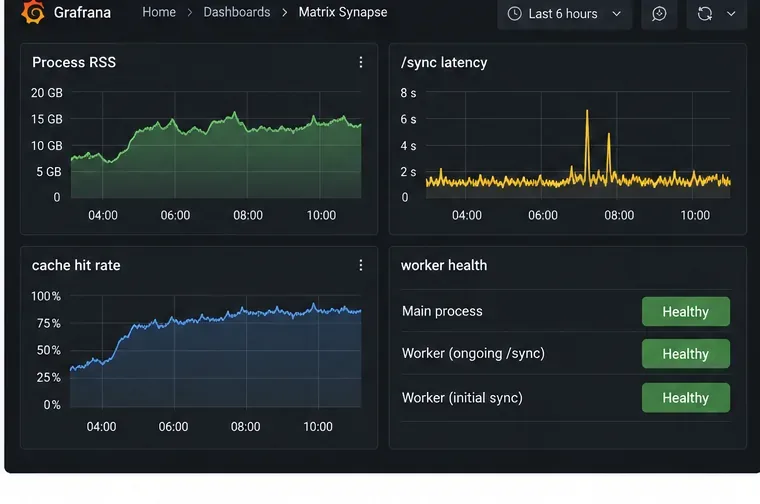
După fiecare modificare, acordați serverului suficient timp pentru a atinge un model de trafic normal. Monitorizați împreună memoria rezidentă, latența solicitărilor, încărcarea bazei de date și starea de sănătate a lucrătorilor activi. Un grafic de memorie care scade în timp ce latența sincronizării se dublează nu este o soluție eficientă.
Pasul 6: Activați valorile Prometheus pentru diagnosticare repetabilă
Pentru orice incident dincolo de un incident singular, activați metricile Synapse și colectați-le cu Prometheus. Ghidul oficial de monitorizare documentează enable_metrics: trueși un listener intern dedicat pentru metrici. Păstrați endpoint-ul metricilor pe o interfață internă sau protejați-l la proxy-ul invers; nu ar trebui expus inutil.
Urmărește memoria și latența sincronizării împreună. Rezultatul util este o memorie stabilă cu un timp de răspuns acceptabil, nu cea mai mică valoare RSS posibilă.
Folosește ghidul oficial de monitorizare Synapse Prometheus pentru sintaxa curentă a listener-ului. În implementările worker, monitorizează fiecare worker separat, deoarece metricile worker nu sunt agregate automat în procesul principal.
Greșeli frecvente de evitat
Se reduce SYNAPSE_CACHE_FACTOR până când serverul devine mai lent
O memorie cache mai mică utilizează mai puțină memorie per intrare, dar crește volumul de muncă în baza de date și în calcul. Dacă acest volum de muncă suplimentar creează o coadă de cereri neterminate, memoria totală poate crește în loc să scadă. Reduceți factorul în pași mici și urmăriți întotdeauna latența.
Presupunând că fiecare cerere /sync costă la fel
O sincronizare continuă cu un sincetoken și o sincronizare inițială fără unul au profiluri de resurse foarte diferite. Separați-le în diagnosticare înainte de a scala întregul server.
Utilizarea workerilor în timp ce încă folosești SQLite
Workerii sinapselor partajează o bază de date PostgreSQL. Documentația workerului precizează că SQLite este destinat utilizării demonstrative sau de testare și nu reprezintă baza pentru o implementare de producție bazată pe workeri.
Folosirea swap-ului ca soluție principală
O cantitate mică de swap-uri poate preveni o întrerupere bruscă a procesului, dar swap-urile masive încetinesc dramatic sincronizarea și pot crea aceeași buclă de feedback pentru restanțe. Tratați swap-urile ca pe o protecție împotriva unui vârf scurt de timp, nu ca pe o planificare a capacității.
Modificarea simultană a mai multor setări de memorie
Dacă reduceți simultan memoria cache, modificați rutarea worker-ilor, modificați setările PostgreSQL și creșteți o limită de containere, nu veți ști care modificare a rezolvat problema. Faceți câte o modificare controlată pe rând și comparați aceleași metrici.
O cale practică de decizie
Ceea ce observi
Următoarea acțiune probabilă
Creșteri mari de memorie atunci când utilizatorii se conectează pe dispozitive noi
Identificați sincronizarea inițială și luați în considerare izolarea acesteia pe un worker pentru implementări mai mari.
Memoria crește constant, în timp ce rata de accesare a memoriei cache este mare, iar latența este normală
Reduceți capacitatea memoriei cache în mod conservator și testați din nou.
Latența memoriei și a sincronizării cresc împreună
Investigați restanțele din baza de date sau din spațiul de stocare înainte de a reduce și mai mult memoria cache.
Doar un lucrător își atinge limita
Ajustați bugetul de memorie al acelui lucrător sau scalați grupul de lucrători respectiv, în loc de întregul server de acasă.
Gazda are RAM liberă, dar Synapse este întreruptă.
Inspectați limitele de memorie ale containerului, cgroup-ului, systemd-ului sau Kubernetes.
Listă de verificare finală
Rulați o versiune Synapse acceptată în prezent; versiunea 1.162.0 este cea mai recentă versiune stabilă din 6 octombrie 2026.
Folosește PostgreSQL pentru producție.
Confirmați care proces consumă de fapt RSS și ce limită de memorie i se aplică.
Distingeți sincronizarea incrementală normală de sincronizarea inițială.
Mențineți activată expirarea memoriei cache și ajustați treptat factorii de memorie cache.
Nu activați reglarea automată a memoriei cache decât dacă jemalloc este în uz și toate valorile necesare sunt configurate.
Pentru implementări mai mari, izolați sincronizarea inițială sau adăugați lucrători de sincronizare generici atunci când măsurătorile justifică acest lucru.
Monitorizați memoria și latența împreună după fiecare modificare.
Synapse consumă în mod deliberat multă memorie, deoarece memorarea în cache face parte din strategia sa de performanță. Prin urmare, soluția corectă pentru erorile OOM legate de sincronizare este un echilibru: eliminarea retenției inutile în cache, eliminarea restanțelor din baza de date sau din cereri și izolarea sarcinilor de lucru excepționale fără a priva memoria cache care menține sincronizarea normală rapidă. Această abordare este mai fiabilă decât tratarea celui mai mare număr RSS ca fiind problema în sine.