A Matrix Synapse homeserver can look healthy for days and then suddenly leave PostgreSQL consuming most of the machine's available RAM. The usual symptoms are familiar: swap starts growing, client syncs slow down, federation jobs queue up, and an otherwise modest server becomes difficult to administer. The important first step is not to assume that PostgreSQL has a leak. High memory use can come from several independent sources, including the shared buffer cache, per-query work memory, many database backends, maintenance workers, and inefficient queries caused by stale statistics or table churn.
Synapse's own documentation recommends PostgreSQL for production and exposes database connection-pool controls such as cp_min and cp_max. PostgreSQL, meanwhile, warns that settings such as work_mem can be used by multiple operations inside one query and by many sessions at the same time. That combination is why a setting that looks harmless in isolation can become expensive during a busy period. The safest fix is to measure first, reduce unnecessary concurrency second, then tune memory and maintenance behavior only where the evidence points.
Step 1: Confirm that PostgreSQL is really the memory pressure source
Start at the operating-system level. On Linux, compare total memory, available memory, swap, and the largest processes:
free -h
ps aux --sort=-%mem | head -n 15
Do not judge the server from a single process line. PostgreSQL uses shared memory as well as private memory in backend processes, so the useful question is whether the host is actually under pressure: low available memory, growing swap, OOM kills, or sustained latency. Record the numbers during a quiet period and again during a busy period. That baseline makes later changes measurable instead of guesswork.
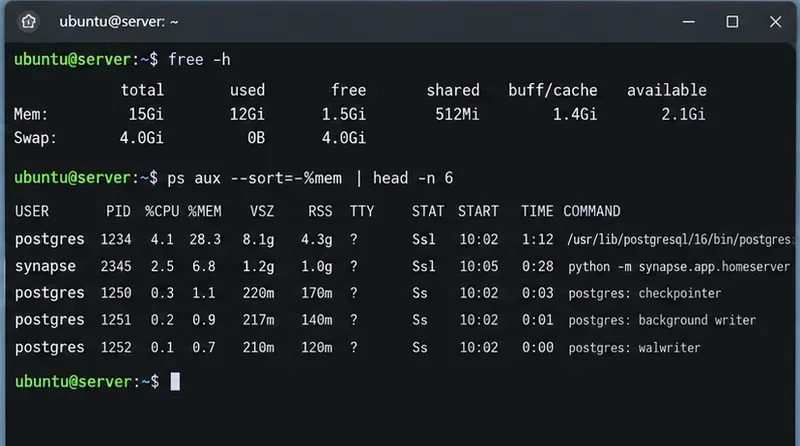
Caption: A first-pass memory check compares host-level available RAM with the PostgreSQL and Synapse processes before any configuration is changed.
Next, inspect the PostgreSQL settings most likely to affect memory:
SHOW shared_buffers;
SHOW work_mem;
SHOW maintenance_work_mem;
SHOW autovacuum_work_mem;
SHOW max_connections;
The PostgreSQL resource-consumption documentation describes the key distinction. shared_buffers is a server-wide shared cache. By contrast, work_mem is a limit for individual sort or hash operations before they spill to temporary files; a complex query can have several such operations, and many sessions can run them concurrently. PostgreSQL currently documents 4 MB as the default work_mem value and notes that total use may be many times that value.
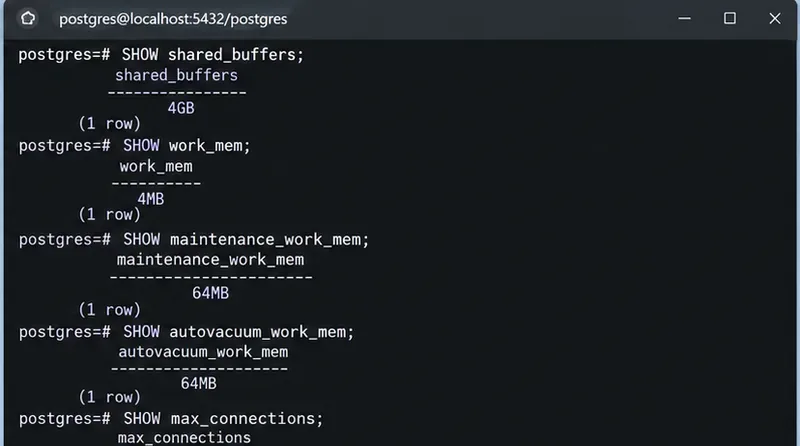
Caption: Read the active PostgreSQL memory-related settings before changing them; the dangerous value is often the combination of settings and concurrency rather than one number alone.
Step 2: Count Synapse database connections and find active work
Un pool mare de conexiuni nu consumă automat spațiu work_mempentru fiecare conexiune, dar fiecare backend PostgreSQL are propriul proces și memorie privată, iar mai multe interogări simultane creează mai multe oportunități pentru alocări de memorie per operație. Verificați câte conexiuni sunt de fapt deschise și în ce stare se află:
SELECT state,
       usename,
       application_name,
       count(*) AS connections
FROM pg_stat_activity
GROUP BY state, usename, application_name
ORDER BY connections DESC;
Apoi inspectați interogările active cu rulare lungă:
SELECT pid,
       usename,
       state,
       now() - query_start AS running_for,
       wait_event_type,
       wait_event,
       left(query, 180) AS query
FROM pg_stat_activity
WHERE state <> 'idle'
ORDER BY query_start;
Documentația oficială explică câmpurile de sesiune și activitate. Un număr mare de sesiuni inactive este diferit de un număr mic de interogări active costisitoare, așa pg_stat_activitycă și remediul ar trebui să fie diferit. Dacă problema este numărul de conexiuni, abordați dimensiunea pool-ului. Dacă problema constă în câteva interogări care consumă multă memorie, reducerea pool-ului poate doar să ascundă simptomul.
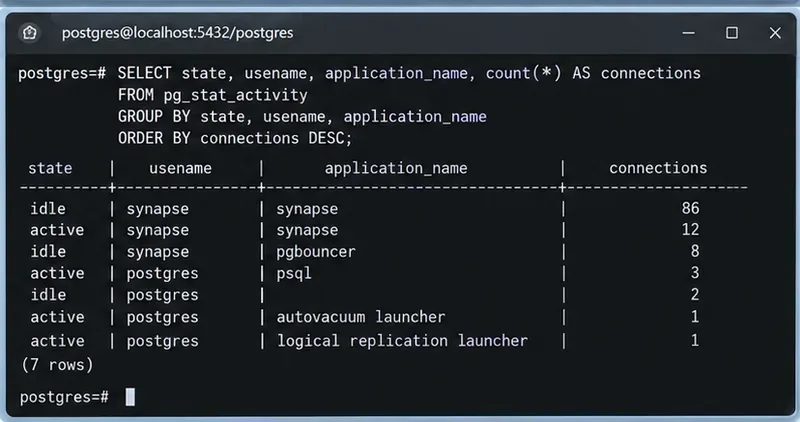
Legendă: Gruparea pg_stat_activityfacilitează distingerea mai multor backend-uri inactive de un set mai mic de sesiuni active ale bazei de date.
Pasul 3: Dimensionați corect pool-ul de conexiuni PostgreSQL Synapse
Synapse transmite majoritatea argumentelor bazei de date către PostgreSQL, consumând opțiuni care încep cu pentru pool-ul său de conexiuni Twisted. Ghidul Synapse PostgreSQLcp_ actual prezintă un exemplu cu și . Tratați-le ca valori exemplu, nu ca o țintă universală.cp_min: 5cp_max: 10
Verificați databaseblocul în homeserver.yaml:
database:
  name: psycopg2
  args:
    user: synapse_user
    password: "your-secret"
    dbname: synapse
    host: 127.0.0.1
    cp_min: 5
    cp_max: 10
Dacă anterior ați ridicat cp_maxagresiv codul și pg_stat_activityafișați un număr mare de conexiuni Synapse în mare parte inactive, reduceți-l treptat și urmăriți latența cererilor. Într-o implementare Synapse bazată pe worker, rețineți că cererea bazei de date provine din mai multe procese Synapse, așadar evaluați numărul combinat de conexiuni, mai degrabă decât un worker izolat. Manualul de configurare Synapse confirmă că cp_opțiunile configurează pool-ul de conexiuni.
După editarea configurației, reporniți procesul sau procesele Synapse afectate în funcție de metoda de implementare, apoi rulați din nou interogarea numărului de conexiuni. Nu reduceți pool-ul până când solicitările nu încep să fie puse în coadă doar pentru a economisi câțiva megaocteți. Un pool prea mic poate transforma concurența bazei de date în latență a aplicației.
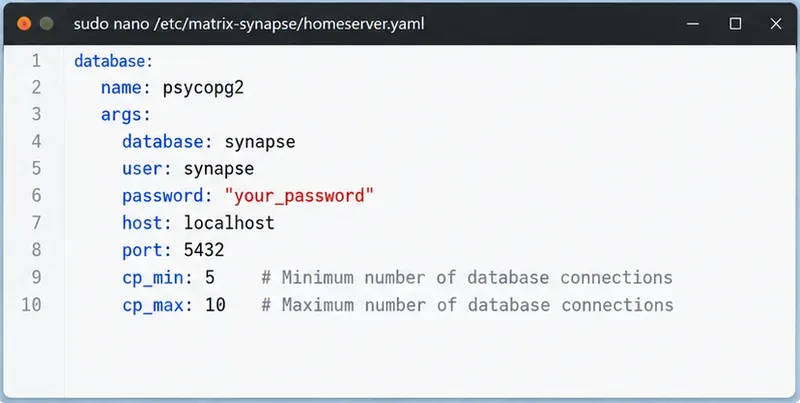
Legendă: Synapse expune cp_minși cp_maxîn configurația bazei de date PostgreSQL, permițând administratorilor să limiteze concurența inutilă din backend.
Pasul 4: Ajustați memoria PostgreSQL conservativ
Odată ce numărul de conexiuni este rezonabil, verificați setările de memorie PostgreSQL în contextul memoriei RAM disponibile efectiv pentru baza de date. PostgreSQL spune că, pe un server de baze de date dedicat cu cel puțin 1 GB de RAM, aproximativ 25% din memoria sistemului este un punct de plecare rezonabil pentru shared_buffers. Această îndrumare este explicit pentru un server de baze de date dedicat. Dacă Synapse, proxy-ul invers, Redis, monitorizarea și PostgreSQL partajează o singură mașină virtuală mică, PostgreSQL nu deține întreaga mașină, așa că bugetați în consecință.
Setarea care îi va surprinde cel mai probabil pe administratori este work_mem. Evitați înmulțirea work_memcu max_connectionsși tratarea acesteia ca pe o rezervare rigidă; PostgreSQL nu o prealocă în acest fel. În schimb, gândiți-vă în termeni de operațiuni de interogare concurente. O singură interogare poate utiliza mai multe noduri de sortare sau hash, iar operațiunile de hash pot utiliza un multiplu de work_mem. Dacă setați work_memla un număr foarte mare la nivel global deoarece un raport a fost lent, o explozie de federație sau o perioadă cu sincronizare intensă poate produce un vârf de memorie mult mai mare decât se aștepta.
Un model rezonabil este să păstrați valoarea globală conservatoare și să o creșteți doar pentru o anumită sesiune administrativă, atunci când o interogare cunoscută beneficiază de mai multă memorie. Înainte de a modifica valorile, păstrați configurația existentă și notați ce parametri necesită o repornire PostgreSQL. shared_buffers, de exemplu, este o setare de pornire a serverului. Modificările ar trebui programate astfel încât să puteți compara memoria, latența și comportamentul fișierelor temporare înainte și după.
Verificați maintenance_work_memși autovacuum_work_mem. PostgreSQL notează că funcționarea worker-ului autovacuum poate aloca memorie de întreținere concurent. Dacă autovacuum_work_memeste lăsată la comportamentul său moștenit, o valoare neobișnuit de mare maintenance_work_mempoate face ca mai mulți worker-i autovacuum simultani să fie scumpi. Nu dezactivați autovacuum pentru a economisi RAM; acest lucru schimbă de obicei un simptom de memorie pe termen scurt cu supraîncărcarea tabelului, statistici învechite și performanțe mai slabe.
Pasul 5: Verificați starea vidului, apoi verificați remedierea sub sarcină reală
Synapse scrie și actualizează cantități mari de date despre evenimente și stări. PostgreSQL necesită o curățare automată a rutinelor pentru a recupera tuplurile nefuncționale pentru reutilizare și pentru a menține statisticile planificatorului actualizate. Ghidul de curățare automată a rutinelor PostgreSQL recomandă utilizarea autovacuum pentru majoritatea instalărilor.
Căutați tabele cu multe tupluri estimate moarte sau timestamp-uri de întreținere învechite:
SELECT relname,
       n_live_tup,
       n_dead_tup,
       last_autovacuum,
       last_autoanalyze
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;
Dacă un anumit tabel necesită în mod clar atenție, un tabel normal VACUUM (ANALYZE)este de obicei primul instrument manual de luat în considerare:
VACUUM (ANALYZE) your_table_name;
Evitați să treceți direct la VACUUM FULL. Referința oficială VACUUM explică faptul că citirea și scrierea normală VACUUMpoate rula alături de citirile și scrierile normale, în timp ce VACUUM FULLrescrie tabelul și primește un ACCESS EXCLUSIVEblocaj. Folosiți-l pe acesta din urmă doar atunci când recuperarea spațiului pe disc merită întreruperea planificată.
Cum să știi dacă schimbarea a funcționat cu adevărat
Verificați rezultatul pentru același tip de sarcină de lucru care a cauzat problema. O soluție eficientă nu este pur și simplu „Postgres folosește mai puțină RAM imediat”. Cache-urile bazelor de date ar trebui să utilizeze memorie. În schimb, căutați memorie disponibilă stabilă, o creștere neașteptată a swap-urilor puțină sau deloc, fără evenimente OOM, un număr de conexiuni care corespunde concurenței așteptate și timpi de răspuns acceptabili pentru Synapse.
- Executare
free -hși lista de procese la același nivel de trafic utilizat pentru linia de bază.
- Repetați
pg_stat_activityinterogarea de conexiune și confirmați că numărul de backend-uri inactive a scăzut dacă ați modificat pool-ul de sinapse.
- Urmăriți latența interogărilor și sincronizării după reducere
cp_max; anulați modificarea dacă așteptările bazei de date cresc considerabil.
- Verifică
pg_stat_user_tablesîn timp pentru a confirma că Autovacuum vizitează într-adevăr mesele ocupate.
- Dacă ați coborât
work_mem, monitorizați dacă sortările mari se revarsă excesiv în fișierele temporare înainte de a-l coborî și mai mult.
Dacă PostgreSQL continuă să crească până când gazda se schimbă semnificativ după aceste verificări, capturați lista de interogări active în timpul vârfului de sarcină și investigați volumul de lucru, în loc să micșorați în mod repetat limitele globale de memorie. Pe versiunile PostgreSQL acceptate, pg_backend_memory_contextsse pot inspecta contextele de memorie pentru backend-ul curent; documentația vizualizării sistemului PostgreSQL descrie vizualizarea și permisiunile acesteia. Acest lucru este mai util pentru o investigație specifică a bazei de date decât presupunând că fiecare implementare Synapse cu memorie mare are aceeași cauză.
Concluzie
Pentru Matrix Synapse pe PostgreSQL, utilizarea ridicată a memoriei bazei de date este cel mai sigur rezolvată în straturi: demonstrați că gazda se află sub o presiune reală a memoriei, numărați sesiunile bazei de date, dimensionați corect pool-ul Synapse, mențineți memoria per operație a PostgreSQL conservatoare și asigurați-vă că autovacuum-ul este sănătos. Scopul nu este cea mai mică amprentă posibilă a PostgreSQL. Scopul este utilizarea previzibilă a memoriei fără a transforma memorarea normală în cache și concurența bazei de date în evenimente de swap, OOM sau clienți Matrix lenți care pot fi evitați.









