الرئيسية
» مكتب MS
»
كيفية إصلاح مشكلة ارتفاع استهلاك وحدة المعالجة المركزية في Collabora Online من خلال loolwsd / coolwsd
كيفية إصلاح مشكلة ارتفاع استهلاك وحدة المعالجة المركزية في Collabora Online من خلال loolwsd / coolwsd
عندما يستهلك Collabora Online فجأةً معظم موارد المعالج في الخادم، فإن أهم خطوة أولى هي عدم إعادة تشغيله بشكل متكرر أو فرض حد منخفض جدًا على موارد المعالج فورًا. يجب أولًا تحديد ما إذا كان الحمل ناتجًا عن عمل عادي على المستندات، أو جلسة معالجة مستندات واحدة غير طبيعية، أو كثرة العمليات المتوازية، أو جلسة خاملة لا يتم تنظيفها، أو خلل خاص بالإصدار. قد يختلف اسم العملية coolwsdفي الإصدارات الحالية loolwsdوالإصدارات القديمة.
سيناريو توضيحي: تخيل خادمًا بثمانية معالجات افتراضية (vCPU) يعمل عليه Collabora Online خلف Nextcloud. يبدو أن عددًا قليلًا من المستخدمين يقومون بتحرير المستندات، لكن حاوية Collabora تستهلك ما بين 250% و350% من موارد المعالج لعدة دقائق. هذا مثال افتراضي يُستخدم في هذا الدليل، وليس قياسًا معياريًا أو تقريرًا من بيئة تشغيل حقيقية.
اعتبارًا من أكتوبر 2026، كان الإصدار المستقر الحالي من Collabora هو 26.04، وتشير ملاحظات الإصدار الرسمية إلى أن Collabora Online 26.04.3.3 قد صدر في 14 سبتمبر 2026. وتستخدم قوالب التكوين الحالية هذا coolwsdالاسم. لا تزال أدوات ترحيل Collabora توثق /etc/loolwsd/loolwsd.xmlالمسار الأقدم لعمليات التثبيت من الإصدار 6.4 أو ما قبله، ولهذا السبب قد يواجه المسؤولون كلا الاسمين.
1. تأكد من العملية التي تستهلك وحدة المعالجة المركزية فعليًا
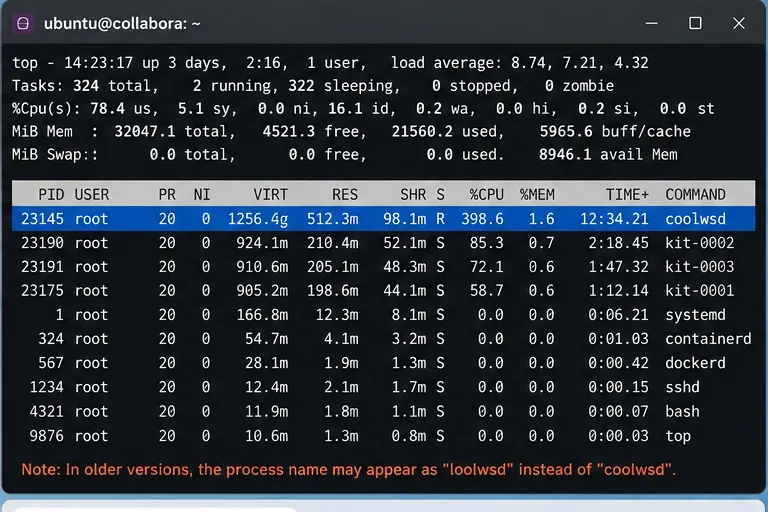
ابدأ من مستوى نظام التشغيل أو الحاوية. coolwsdلا يعني الرقم المرتفع بجانبه بالضرورة أن البرنامج الخفي المنسق يقوم بكل عمليات معالجة المستندات المكلفة. يُشغّل Collabora أيضًا عمليات kit/forkit لجلسات المستندات، لذا ستحتاج إلى شجرة العمليات واستخدام وحدة المعالجة المركزية لكل عملية قبل تغيير الإعدادات.
ps -eo pid,ppid,pcpu,pmem,etime,cmd --sort=-pcpu | head -n 25
top -H -p $(pgrep -d, -f 'coolwsd|loolwsd|coolkit|loolkit|forkit')
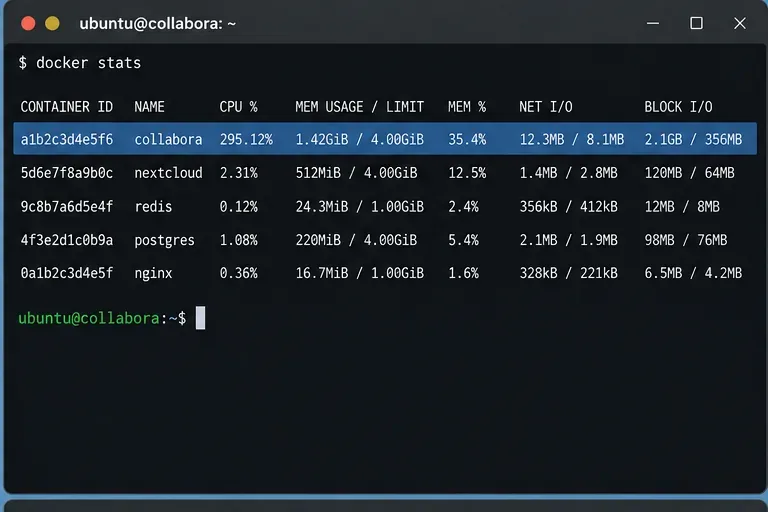
بالنسبة لـ Docker، تحقق أيضًا من الحاوية ككل:
docker stats --no-stream
تساعد نظرة على مستوى العملية في فصل برنامج Collabora الرئيسي عن عمليات مجموعة الأدوات المتعلقة بالمستندات قبل محاولة إجراء أي تعديل.تُعد وحدة المعالجة المركزية على مستوى الحاوية مفيدة لتأكيد أن Collabora هي مصدر حمل المضيف، لكنها لا تحدد المستند أو العملية الفرعية المسؤولة.
في السيناريو التوضيحي، لنفترض أن الحاوية تستهلك ما يقارب 300% من وحدة المعالجة المركزية، وأن عملية واحدة من عمليات مجموعة الأدوات تتصدر قائمة العمليات باستمرار. هذا يشير إلى جلسة مستند نشطة محددة، وليس إلى افتراض عام بأن الخادم بأكمله مُثقل.
2. تحقق من مقاييس Collabora الخاصة بدلاً من الاعتماد فقط على المقاييس الأعلى.
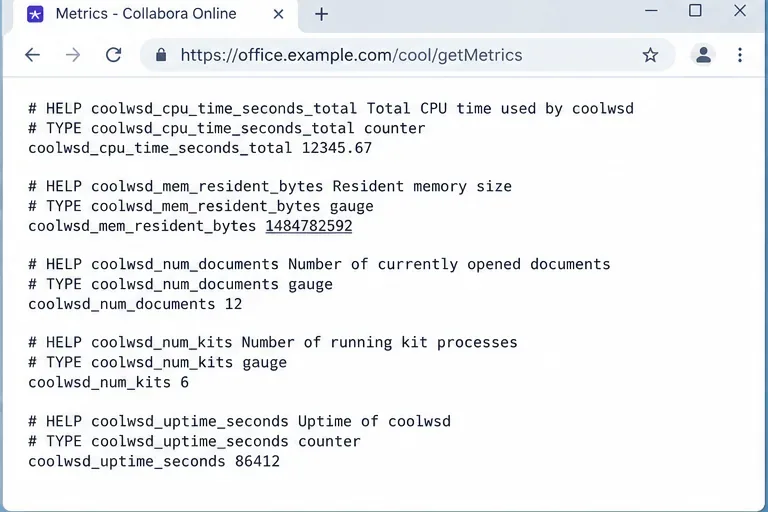
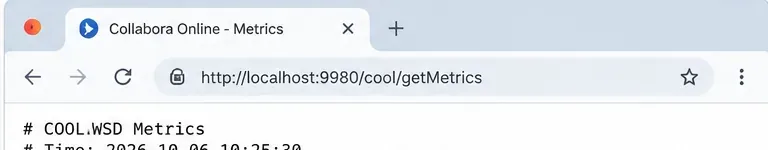
يُتيح Collabora Online الوصول إلى مقاييس متوافقة مع Prometheus /cool/getMetrics. ويشير دليل SDK الحالي إلى أن هذه النقطة الطرفية قادرة على الإبلاغ عن استخدام وحدة المعالجة المركزية والذاكرة، وعمليات Kit قيد التشغيل، والعروض، وبيانات استخدام الخادم الأخرى. وتستخدم نفس آلية المصادقة المستخدمة في لوحة تحكم المسؤول، ما لم يتم تكوين المقاييس صراحةً للسماح بالوصول غير المصادق عليه.
لا تُعرّض نقطة نهاية المقاييس للعموم لمجرد تبسيط عملية استكشاف الأخطاء وإصلاحها. يتضمن تكوين Helm الرسمي أمثلةً لحظر /cool/getMetricsعناوين URL الإدارية عند نقطة الدخول. استخدم مسارًا داخليًا موثقًا كلما أمكن ذلك.
توفر نقطة نهاية مقاييس Collabora سياقًا من جانب الخادم يكمل قياسات وحدة المعالجة المركزية لنظام Linux أو Docker.
ابحث عن علاقة بين استخدام وحدة المعالجة المركزية (CPU) والمستندات أو طرق العرض النشطة. إذا ارتفع استخدام وحدة المعالجة المركزية وانخفض مع عمليات التحرير المشروعة، فقد يكون لديك مشكلة في السعة أو التزامن. أما إذا ظل استخدام وحدة المعالجة المركزية مرتفعًا دون وجود أي عمل تفاعلي، فابحث عن الجلسات القديمة، أو مستند به مشكلة، أو عمليات متكررة في الخلفية، أو مشكلة في البرنامج.
3. اقرأ سجلات النظام في الوقت الذي يرتفع فيه استخدام وحدة المعالجة المركزية (CPU) تحديدًا
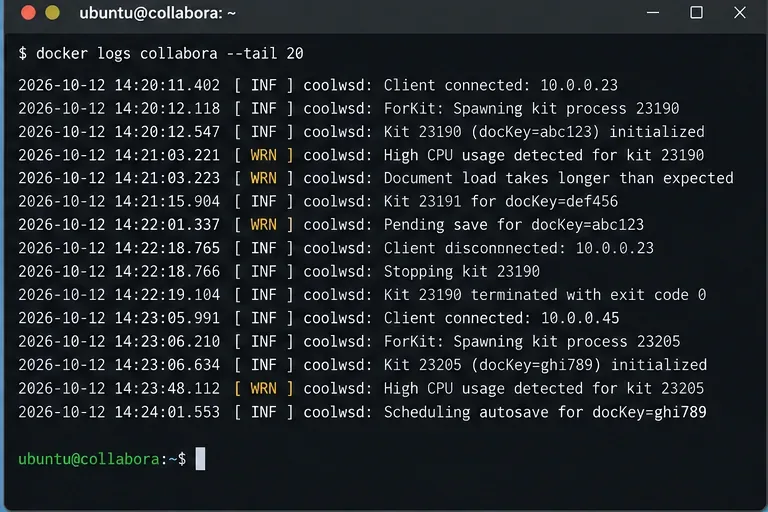
إذا كان لخدمتك أو حاويتك اسم مختلف، فاستبدله. ابحث عن عمليات تحميل المستندات المتكررة، أو إنشاء مجموعات الأدوات المتكررة، أو عمليات الحفظ الفاشلة، أو الأعطال، أو حلقات إعادة الاتصال، أو ظهور مفتاح المستند نفسه مرارًا وتكرارًا. قد يكون ارتفاع استهلاك وحدة المعالجة المركزية لفترة وجيزة أثناء فتح المستند أو إعادة حسابه أو عرضه أو تحويله أو تصديره أمرًا طبيعيًا. أما علامة التحذير الأقوى فهي استمرار ارتفاع استهلاك وحدة المعالجة المركزية دون إحراز أي تقدم مفيد أو تكرار نفس الخطأ.
قم بربط السجلات بوقت ارتفاع استخدام وحدة المعالجة المركزية حتى تتمكن من التمييز بين نشاط المستند الطبيعي والعمل المتكرر أو المتوقف.
4. إعادة إنتاج الارتفاع المفاجئ باستخدام مستند واحد في كل مرة
ارجع إلى الخادم الافتراضي. إذا كانت إحدى عمليات مجموعة الأدوات تستهلك موارد كثيرة، فأغلق المستند المشتبه به أو اعزله، وراقب ما إذا كان استهلاك وحدة المعالجة المركزية ينخفض. ثم افتح الملف نفسه خلال فترة هدوء مع مراقبة قائمة العمليات ومؤشرات الأداء. كرر العملية مع مستند اختبار بسيط.
تُعد هذه المقارنة أكثر فائدة من إعادة تشغيل الخدمة بأكملها على الفور:
إذا كان ملف واحد فقط هو الذي يتسبب في حدوث الارتفاع المفاجئ بشكل موثوق، فإن محتوى الملف أو الصيغ أو الكائنات المضمنة أو عبء العمل الخاص بالعرض أو خطأ خاص بالمستند هو المشتبه به الأقوى.
إذا تسبب كل ملف في تشبع مماثل بمجرد أن يصبح العديد من المستخدمين نشطين، فقم بالتحقق من سعة الخادم والتزامن.
إذا ظل استهلاك وحدة المعالجة المركزية مرتفعًا بعد توقف جميع أنشطة المستخدم، فركز على عمليات التنظيف، أو الأدوات القديمة، أو مهام الخلفية المتكررة، أو حدوث تراجع في الأداء.
إذا بدأت المشكلة مباشرة بعد الترقية، فقم بتسجيل الإصدارات القديمة والجديدة قبل تغيير العديد من المتغيرات الأخرى.
5. تقليل التزامن لكل مستند عندما يستطيع مستند واحد احتكار النوى
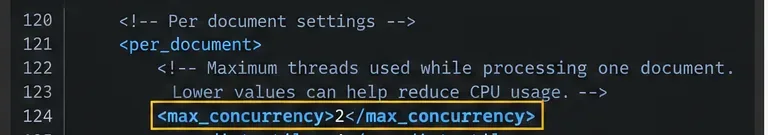
تُحدد وثائق نموذج تكوين Collabora الحالي per_document.max_concurrencyالحد الأقصى لعدد الخيوط المستخدمة أثناء معالجة المستند. القيمة الافتراضية للنموذج هي 4. على جهاز ذي سعة تخزينية محدودة، أو عندما يستحوذ مستند واحد معقد على معظم موارد الجهاز، فإن تقليل هذه القيمة يُحسّن من إمكانية التنبؤ باستخدام وحدة المعالجة المركزية.
إن خفض التزامن لكل مستند هو مقايضة: يمكن أن يقلل من مدى استخدام المستند الواحد لوحدة المعالجة المركزية، ولكن العمليات الثقيلة قد تستغرق وقتًا أطول.
لا تقم بنسخ الرقم 2 بشكل أعمى. إذا كان المستخدمون يتعاملون بشكل روتيني مع جداول بيانات أو عروض تقديمية كبيرة، وكان الخادم مزودًا بعدد كافٍ من النوى، فقد يؤدي استخدام قيمة أقل إلى إبطاء العمل. غيّر إعدادًا واحدًا، وأعد إنتاج نفس عبء العمل، وقارن بين استخدام وحدة المعالجة المركزية، وسرعة الاستجابة، ووقت الإنجاز.
6. تحقق من إعدادات التنظيف وإعدادات الجلسة الخاملة قبل تفعيلها بشكل مفرط
يتضمن القالب الحالي coolwsd.xmlمنطقًا لتنظيف المستندات الخاملة التي تستهلك موارد النظام. عند كتابة هذا التقرير، يُظهر القالب فاصلًا زمنيًا لفحص التنظيف يبلغ 10000 مللي ثانية، وفترة سلوك غير طبيعي مدتها 60 ثانية، وعتبة خمول مدتها 300 ثانية، وعتبة استخدام وحدة المعالجة المركزية بنسبة 85% ليصبح المستند مرشحًا للتنظيف. كما يتضمن مهلة خمول لكل مستند تبلغ 3600 ثانية.
يتضمن القالب نفسه مهلات زمنية لكل عرض. تُظهر القيم الحالية 300 ثانية قبل أن يتم تعتيم عرض المتصفح غير النشط وإيقاف التحديثات، و900 ثانية قبل التعامل مع العرض غير النشط بنفس الطريقة. لا تُعادل هذه المهلات الزمنية للعرض إلغاء تحميل جلسة المستند بالكامل فورًا.
يمكن لعناصر التحكم في التنظيف والعرض الخامل أن تقلل من العمل الضائع، ولكن يجب ضبطها بشكل متحفظ حتى لا تتعطل جلسات التحرير الطويلة العادية.
تجنب خفض عتبة وحدة المعالجة المركزية إلى مستوى منخفض للغاية لمجرد تحسين مظهر الرسم البياني. تهدف عملية التنظيف إلى رصد المستندات التالفة أو الخاملة التي تستهلك موارد النظام، وليس إلى إنهاء عمليات التحرير النشطة العادية كلما أصبحت مكلفة حسابيًا.
7. أعد التشغيل فقط بعد حفظ تغيير مُتحكم به في التكوين
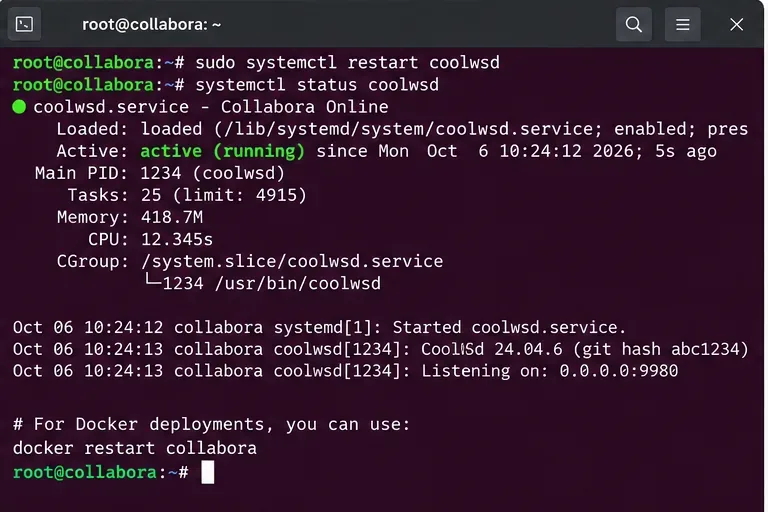
قم بعمل نسخة احتياطية من الإعدادات النشطة أولاً. عادةً ما تستخدم عمليات تثبيت الحزم ملفات التكوين /etc/coolwsd/coolwsd.xml. قد تُمرر عمليات نشر Docker خيارات كمتغيرات بيئية أو كتجاوزات في سطر الأوامر، أو قد تقوم بتحميل ملف تكوين داخل الحاوية. تأكد من المصدر النشط فعليًا قبل إجراء أي تعديلات.
أعد التشغيل فقط بعد إجراء تغيير متعمد في التكوين مع وجود نسخة احتياطية منه، ثم تحقق من أن الخدمة سليمة قبل أن يستأنف المستخدمون الاختبار.
إذا أدى إعادة التشغيل وحدها إلى إصلاح وحدة المعالجة المركزية مؤقتًا، ولكن المشكلة تعود باستمرار، فهذه معلومات تشخيصية وليست حلاً دائمًا. استمر في المحاولة حتى تتمكن من تحديد نوع الحمل أو الحالة التي تسبب تكرار المشكلة.
8. قارن الوضع قبل وبعد في ظل نفس عبء العمل
استخدم نفس المستند، ونفس عدد المستخدمين تقريبًا، ونفس تسلسل العمليات. قِس الأداء لعدة دقائق بدلًا من مقارنة لحظة واحدة. في هذا السيناريو التوضيحي، يُعتبر الأداء ناجحًا إذا لم يعد الخادم مُثقلًا أثناء تكرار عبء العمل، مع استمرار عمليات فتح المستند وتحريره وحفظه والتعاون عليه بسلاسة.
استخدم نفس نقطة نهاية المقاييس بعد كل تغيير مُتحكم فيه بحيث تستند المقارنة قبل وبعد التغيير إلى بيانات خادم قابلة للمقارنة.
ملاحظة
الخطوة التالية المحتملة
تبقى وثيقة واحدة أو مجموعة أدوات ساخنة
قم بإعادة إنتاج المشكلة باستخدام هذا الملف، واحتفظ بالسجلات، واختبرها على الإصدار المصغر المستقر الحالي.
يتتبع المعالج عدد المستخدمين النشطين
قم بمراجعة السعة والتزامن وحجم النشر بدلاً من التعامل مع الحمل على أنه تسريب.
يظل استهلاك وحدة المعالجة المركزية مرتفعًا بعد مغادرة المستخدمين.
افحص المستندات الخاملة، وسلوك التنظيف، والمهام المتكررة في الخلفية، والمجموعات اليتيمة أو التي يتم إعادة تشغيلها.
بدأ سبايك العمل فورًا بعد الترقية
سجل الإصدارات الدقيقة وتحقق من ملاحظات الإصدار الحالية والمشاكل المعروفة قبل تغيير العديد من قيم الضبط.
يؤدي خفض قيمة max_concurrency إلى تقليل استهلاك وحدة المعالجة المركزية، لكن عملية التحرير تصبح أبطأ.
قم بزيادته تدريجياً أو أضف سعة وحدة المعالجة المركزية؛ الإعداد هو حل وسط وليس حلاً شاملاً.
متى يجب عليك التحديث بدلاً من الضبط؟
إذا بدأ هذا السلوك مع إصدار معين من Collabora، وكان بالإمكان إعادة إنتاجه باستخدام ملف أو عملية محددة، فقد يؤدي ضبط الإعدادات إلى إخفاء عيب برمجي فقط. توصي Collabora باستخدام أحدث إصدار من الفرع المستقر الحالي. اعتبارًا من 7 أكتوبر 2026، تُشير صفحة ملاحظات الإصدار الرسمية 26.04 إلى أن الإصدار 26.04.3.3 هو أحدث إصدار من Collabora Online مُدرج هناك.
بالنسبة لمستخدمي CODE، تذكروا أن Collabora تصف إصدار التطوير بأنه مناسب للفرق الصغيرة، والاستخدام المنزلي، والتطوير، وتجربة الوظائف الجديدة، مع التأكيد على أنه غير مخصص لبيئات الإنتاج. لذا، قد يكون من الأنسب الانتقال إلى منتج Collabora Online المدعوم في حال حدوث مشكلة في بيئة الإنتاج، بدلاً من الاستمرار في محاولة ضبط سلوك إصدار التطوير.
ما لا يجب فعله
لا تفترض أن coolwsdالرقم المرتفع يثبت وجود تسرب للذاكرة أو حلقة لا نهائية.
لا تقم بتعيين تسجيل التصحيح أو التتبع بشكل دائم أثناء حادثة وحدة المعالجة المركزية إلا إذا كنت بحاجة إليه بالفعل؛ فالتسجيل المطول يضيف عبئًا إضافيًا وضغطًا على مساحة التخزين.
لا تعرض لوحة تحكم المسؤول أو نقطة نهاية المقاييس للإنترنت العام لمجرد تسهيل المراقبة.
لا تقم بتخفيض عتبات التنظيف حتى يتم إنهاء الجلسات النشطة العادية.
لا تستخدم حصص وحدة المعالجة المركزية كخطوة تشخيصية أولى. قد يحمي الحد الأقصى الصارم المستخدمين الآخرين على المضيف المشترك، ولكنه قد يحوّل مشكلة وحدة المعالجة المركزية إلى بطء في عرض المستندات وانقطاعات في الاتصال دون الكشف عن السبب.
ترتيب استكشاف الأخطاء وإصلاحها الموصى به
تأكد مما إذا كانت العملية المشغولة هي coolwsdعملية قديمة loolwsdأو عملية مجموعة أدوات فرعية/مجموعة أدوات فرعية.
سجل بيانات وحدة المعالجة المركزية (CPU) والذاكرة والمستندات النشطة والعروض الخاصة بـ Docker أو المضيف.
قم بربط السجلات بفترة الذروة الدقيقة.
قم بإعادة إنتاج المشكلة باستخدام مستند واحد مشتبه به، ثم باستخدام مستند تحكم بسيط.
اختبر per_document.max_concurrencyفقط ما إذا كان أحد المستندات يستخدم الكثير من وحدة المعالجة المركزية المتوازية.
راجع إعدادات التنظيف والتشغيل الخامل دون جعلها عدوانية بلا داعٍ.
أعد تشغيل النظام بعد كل تغيير مُتحكم به في الإعدادات، وتحقق من سلامة الخدمة.
قارن نفس عبء العمل قبل وبعد، ثم تحقق من الإصدار المستقر الحالي إذا بدا السلوك خاصًا بالإصدار.
الهدف العملي ليس إجبار Collabora Online على استخدام أقل قدر ممكن من وحدة المعالجة المركزية، بل جعل استهلاك وحدة المعالجة المركزية قابلاً للتفسير ومتناسباً مع العمل المفيد، مع الحفاظ على أداء مقبول للتحرير والتعاون.