Un servidor doméstico Matrix Synapse puede funcionar correctamente durante días y, de repente, dejar que PostgreSQL consuma la mayor parte de la RAM disponible. Los síntomas habituales son conocidos: el espacio de intercambio empieza a crecer, las sincronizaciones de clientes se ralentizan, las tareas de federación se acumulan y un servidor que, en principio, era modesto, se vuelve difícil de administrar. El primer paso importante es no asumir que PostgreSQL tiene una fuga de memoria. El alto consumo de memoria puede provenir de varias fuentes independientes, como la caché de búfer compartida, la memoria de trabajo por consulta, múltiples procesos de base de datos, procesos de mantenimiento y consultas ineficientes causadas por estadísticas obsoletas o cambios en las tablas.
La propia documentación de Synapse recomienda PostgreSQL para producción y expone controles de pool de conexiones de base de datos como cp_miny cp_max. PostgreSQL, por su parte, advierte que configuraciones como work_mempueden ser utilizadas por múltiples operaciones dentro de una misma consulta y por muchas sesiones simultáneamente. Esta combinación explica por qué una configuración que parece inofensiva de forma aislada puede resultar costosa durante un período de alta actividad. La solución más segura consiste en medir primero, reducir la concurrencia innecesaria en segundo lugar y, finalmente, ajustar el comportamiento de la memoria y el mantenimiento solo donde la evidencia lo indique.
Paso 1: Confirmar que PostgreSQL es realmente la fuente de la presión de memoria.
Comience por el nivel del sistema operativo. En Linux, compare la memoria total, la memoria disponible, el espacio de intercambio y los procesos más grandes:
free -h
ps aux --sort=-%mem | head -n 15
No juzgue el servidor basándose en una sola línea de proceso. PostgreSQL utiliza memoria compartida y privada en los procesos de backend, por lo que la pregunta clave es si el host está realmente bajo presión: poca memoria disponible, aumento del espacio de intercambio, errores de memoria insuficiente o latencia sostenida. Registre los datos durante un período de baja actividad y nuevamente durante un período de alta actividad. Esta base de referencia permite medir los cambios posteriores en lugar de basarse en conjeturas.
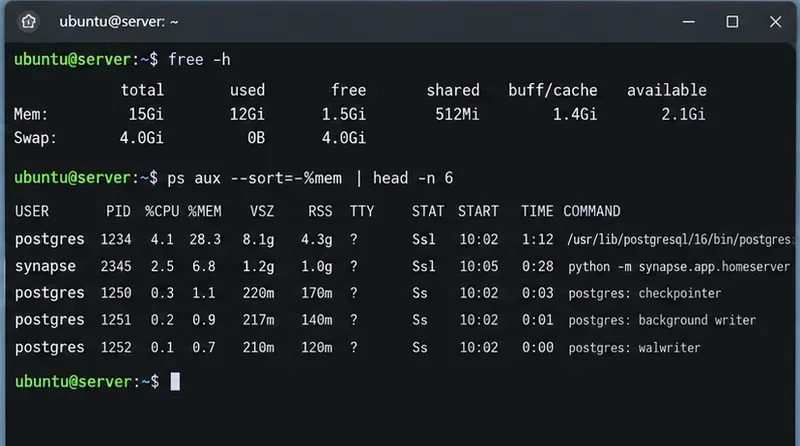
Leyenda: Una primera comprobación de memoria compara la RAM disponible a nivel del host con los procesos de PostgreSQL y Synapse antes de que se modifique cualquier configuración.
A continuación, inspeccione la configuración de PostgreSQL que tenga más probabilidades de afectar la memoria:
SHOW shared_buffers;
SHOW work_mem;
SHOW maintenance_work_mem;
SHOW autovacuum_work_mem;
SHOW max_connections;
La documentación sobre el consumo de recursos de PostgreSQL describe la distinción clave. shared_bufferses una caché compartida a nivel de servidor. Por el contrario, work_memes un límite para las operaciones individuales de ordenación o hash antes de que se guarden en archivos temporales; una consulta compleja puede tener varias de estas operaciones, y muchas sesiones pueden ejecutarlas simultáneamente. Actualmente, PostgreSQL documenta 4 MB como work_memvalor predeterminado e indica que el uso total puede ser muchas veces superior a ese valor.
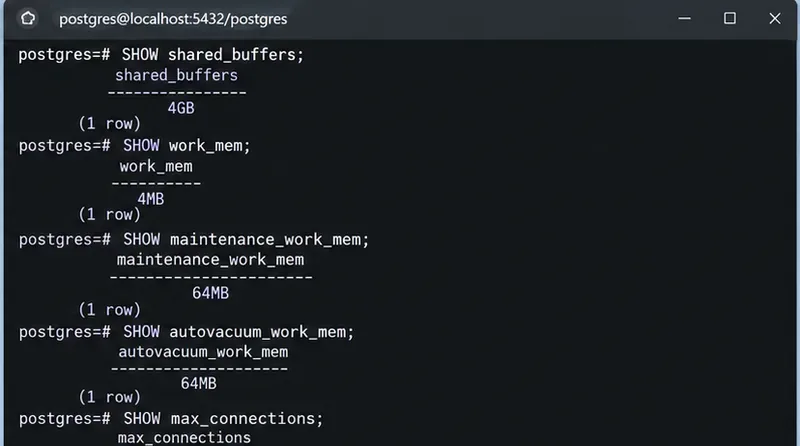
Leyenda: Lea la configuración activa relacionada con la memoria de PostgreSQL antes de modificarla; el valor peligroso suele ser la combinación de la configuración y la concurrencia, en lugar de un solo número.
Paso 2: Contar las conexiones de la base de datos Synapse y encontrar el trabajo activo.
Un grupo de conexiones grande no consume automáticamente memoria work_mempara cada conexión, pero cada backend de PostgreSQL tiene su propio proceso y memoria privada, y un mayor número de consultas concurrentes genera más oportunidades para la asignación de memoria por operación. Compruebe cuántas conexiones están realmente abiertas y en qué estado se encuentran:
SELECT state,
       usename,
       application_name,
       count(*) AS connections
FROM pg_stat_activity
GROUP BY state, usename, application_name
ORDER BY connections DESC;
A continuación, inspeccione las consultas activas de larga duración:
SELECT pid,
       usename,
       state,
       now() - query_start AS running_for,
       wait_event_type,
       wait_event,
       left(query, 180) AS query
FROM pg_stat_activity
WHERE state <> 'idle'
ORDER BY query_start;
La documentación oficialpg_stat_activity explica los campos de sesión y actividad. Un número elevado de sesiones inactivas es diferente de un número reducido de consultas activas que consumen muchos recursos, por lo que la solución también debería ser diferente. Si el problema radica en el número de conexiones, se debe considerar el tamaño del grupo de conexiones. Si el problema se debe a unas pocas consultas que consumen mucha memoria, reducir el tamaño del grupo de conexiones podría simplemente ocultar el síntoma.
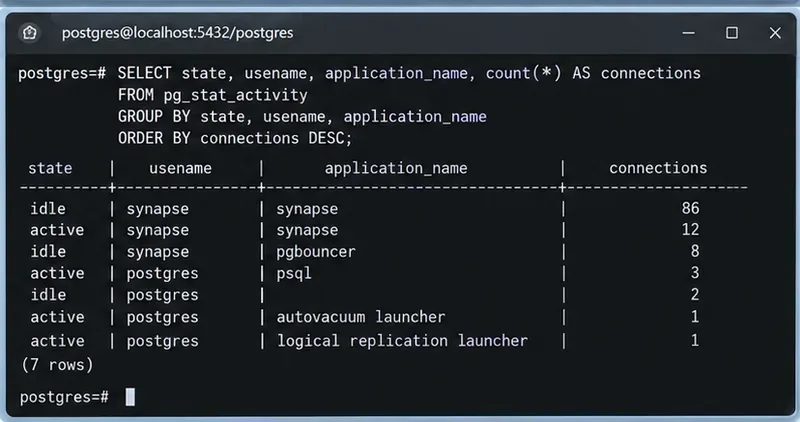
Leyenda: La agrupación pg_stat_activityfacilita la distinción entre muchos procesos backend inactivos y un conjunto más pequeño de sesiones de base de datos activas.
Paso 3: Ajustar el tamaño del grupo de conexiones de Synapse PostgreSQL
Synapse pasa la mayoría de los argumentos de la base de datos a PostgreSQL, consumiendo las opciones que comienzan con para su grupo de conexiones Twisted. La guíacp_ actual de Synapse para PostgreSQL muestra un ejemplo con y . Considere estos valores como ejemplos, no como un objetivo universal.cp_min: 5cp_max: 10
Compruebe el databasebloque en homeserver.yaml:
database:
  name: psycopg2
  args:
    user: synapse_user
    password: "your-secret"
    dbname: synapse
    host: 127.0.0.1
    cp_min: 5
    cp_max: 10
Si anteriormente aumentó el número de conexiones Synapse cp_maxde forma agresiva y pg_stat_activityobserva una gran cantidad de conexiones inactivas, redúzcalo gradualmente y observe la latencia de las solicitudes. En una implementación de Synapse basada en procesos de trabajo, recuerde que la demanda de la base de datos proviene de múltiples procesos Synapse, por lo que debe evaluar el número total de conexiones en lugar de un solo proceso de trabajo de forma aislada. El manual de configuración de Synapse confirma que cp_las opciones configuran el grupo de conexiones.
Tras editar la configuración, reinicie el proceso o los procesos de Synapse afectados según su método de implementación y, a continuación, vuelva a ejecutar la consulta de recuento de conexiones. No reduzca el tamaño del pool hasta que las solicitudes comiencen a ponerse en cola solo para ahorrar unos pocos megabytes. Un pool demasiado pequeño puede convertir la concurrencia de la base de datos en latencia de la aplicación.
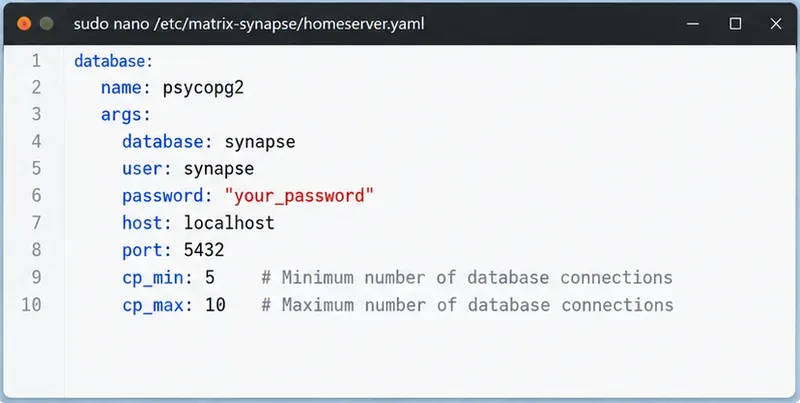
Leyenda: Synapse expone cp_miny cp_maxen la configuración de la base de datos PostgreSQL, lo que permite a los administradores limitar la concurrencia innecesaria del backend.
Paso 4: Ajuste la memoria de PostgreSQL de forma conservadora.
Una vez que el número de conexiones sea razonable, revise la configuración de memoria de PostgreSQL en función de la RAM disponible para la base de datos. PostgreSQL indica que, en un servidor de base de datos dedicado con al menos 1 GB de RAM, aproximadamente el 25 % de la memoria del sistema es un punto de partida razonable shared_buffers. Esta recomendación se aplica específicamente a un servidor de base de datos dedicado. Si Synapse, el proxy inverso, Redis, la monitorización y PostgreSQL comparten una máquina virtual pequeña, PostgreSQL no es propietario de toda la máquina, así que ajuste el presupuesto en consecuencia.
La configuración que probablemente sorprenda a los administradores es work_mem. Evite multiplicar work_mempor max_connectionsy tratarlo como una reserva estricta; PostgreSQL no la preasigna de esa manera. En cambio, piense en términos de operaciones de consulta concurrentes. Una sola consulta puede usar varios nodos de ordenación o hash, y las operaciones de hash pueden usar un múltiplo de work_mem. Si establece work_memen un número muy grande globalmente porque un informe fue lento, un pico de federación o un período de sincronización intensa puede producir un pico de memoria mucho mayor de lo esperado.
Una práctica recomendable es mantener el valor global conservador y aumentarlo solo para una sesión administrativa específica cuando una consulta conocida se beneficie de mayor memoria. Antes de modificar los valores, conserve la configuración existente y anote qué parámetros requieren reiniciar PostgreSQL. shared_buffersPor ejemplo, es una configuración de inicio del servidor. Los cambios deben programarse para poder comparar el uso de memoria, la latencia y el comportamiento de los archivos temporales antes y después.
También verifique maintenance_work_memy autovacuum_work_mem. PostgreSQL indica que los trabajadores de autovacuum pueden asignar memoria de mantenimiento simultáneamente. Si autovacuum_work_memse deja con su comportamiento predeterminado, un valor inusualmente grande maintenance_work_mempuede hacer que varios trabajadores de autovacuum simultáneos resulten costosos. No desactive autovacuum para ahorrar RAM; esto generalmente implica un problema de memoria a corto plazo a cambio de tablas infladas, estadísticas obsoletas y un peor rendimiento.
Paso 5: Compruebe el estado del sistema de vacío y, a continuación, verifique la reparación bajo carga real.
Synapse escribe y actualiza grandes cantidades de datos de eventos y estados. PostgreSQL requiere una limpieza rutinaria para recuperar tuplas obsoletas y reutilizarlas, así como para mantener actualizadas las estadísticas del planificador. La guía de limpieza rutinaria de PostgreSQL recomienda usar autovacuum para la mayoría de las instalaciones.
Busque tablas con muchas tuplas muertas estimadas o marcas de tiempo de mantenimiento obsoletas:
SELECT relname,
       n_live_tup,
       n_dead_tup,
       last_autovacuum,
       last_autoanalyze
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;
Si una tabla específica necesita atención, VACUUM (ANALYZE)la primera herramienta manual a considerar suele ser una tabla normal:
VACUUM (ANALYZE) your_table_name;
Evite pasar directamente a VACUUM FULL. La documentación oficial de VACUUM explica que regular VACUUMpuede ejecutarse junto con lecturas y escrituras normales, mientras que VACUUM FULLreescribe la tabla y toma un ACCESS EXCLUSIVEbloqueo. Use este último solo cuando recuperar espacio en disco justifique la interrupción planificada.
Cómo saber si el cambio realmente funcionó.
Verifique el resultado con el mismo tipo de carga de trabajo que causó el problema. Una solución exitosa no se reduce simplemente a que "Postgres use menos RAM de inmediato". Se supone que las cachés de la base de datos deben usar memoria. En cambio, busque memoria disponible estable, poco o ningún crecimiento inesperado de la memoria de intercambio, ausencia de errores de memoria insuficiente (OOM), un número de conexiones que coincida con la concurrencia esperada y tiempos de respuesta aceptables de Synapse.
- Ejecuta
free -hla lista de procesos al mismo nivel de tráfico utilizado para tu línea base.
- Repita la
pg_stat_activityconsulta de conexión y confirme que el número de procesos backend inactivos disminuyó si cambió el grupo de Synapse.
- Observe la latencia de consulta y sincronización después de reducirla
cp_max; revierta el cambio si los tiempos de espera de la base de datos aumentan notablemente.
- Compruebe
pg_stat_user_tablesperiódicamente que la función de autovacío esté visitando realmente las mesas con mayor actividad.
- Si lo ha reducido
work_mem, supervise si los tipos de datos grandes ahora se desbordan excesivamente a archivos temporales antes de reducirlo aún más.
Si PostgreSQL sigue aumentando su consumo de memoria hasta que el host realiza un uso intensivo de la memoria virtual tras estas comprobaciones, capture la lista de consultas activas durante el pico de actividad e investigue la carga de trabajo en lugar de reducir repetidamente los límites de memoria global. En las versiones de PostgreSQL compatibles, pg_backend_memory_contextspuede inspeccionar los contextos de memoria del backend actual; la documentación de la vista del sistema de PostgreSQL describe la vista y sus permisos. Esto resulta más útil para una investigación específica de la base de datos que asumir que todas las implementaciones de Synapse con alto consumo de memoria tienen la misma causa.
En resumen
Para Matrix Synapse en PostgreSQL, el alto consumo de memoria de la base de datos se soluciona de forma más segura mediante un enfoque por capas: comprobar que el host está bajo una presión real de memoria, contabilizar las sesiones de la base de datos, ajustar el tamaño del pool de Synapse, mantener un consumo de memoria por operación conservador en PostgreSQL y garantizar el correcto funcionamiento de la limpieza automática de la base de datos (autovacuum). El objetivo no es minimizar el consumo de memoria de PostgreSQL, sino lograr un uso predecible de la memoria sin convertir el almacenamiento en caché y la concurrencia normales de la base de datos en intercambios innecesarios, errores de memoria insuficiente (OOM) o clientes de Matrix lentos.