L'intégration d'Elasticsearch à Nextcloud reste active en 2026, mais un point de compatibilité important est à vérifier avant de commencer : l'application « Recherche plein texte - Plateforme Elasticsearch » prend en charge Elasticsearch 8, et non Elasticsearch 9. Le dépôt officiel du projet indique que les versions 26.0.0 et ultérieures sont compatibles uniquement avec Elasticsearch 8. Par ailleurs, Nextcloud 35 dispose désormais d'une version 35.0.0 de la plateforme Elasticsearch, publiée le 18 septembre 2026. Si vous mettez à niveau un serveur existant, vérifiez que la version de l'application correspond à votre version majeure de Nextcloud avant de modifier l'index de recherche.
Ce guide présente une configuration pratique pour l'indexation du contenu de fichiers dans Nextcloud avec Elasticsearch 8. Il se concentre sur la pile standard de trois applications : le framework de recherche plein texte, le connecteur de plateforme Elasticsearch et le fournisseur de fichiers. Les commandes utilisent l'interface de ligne de commande occ(CLI) de Nextcloud, car elle facilite la validation et l'automatisation par rapport à l'utilisation exclusive de l'interface web.
Références officielles : Nextcloud Full text search - Elasticsearch Platform app , Nextcloud Elasticsearch platform repository , Nextcloud Full text search framework , Nextcloud Files full text search provider , et Elastic's single-node Docker installation guide .
Que contient réellement la pile de recherche plein texte de Nextcloud ?
La recherche plein texte de Nextcloud n'est pas une application unique. L'application principale de recherche plein texte fournit l'infrastructure. Une application de plateforme connecte cette infrastructure à un moteur de recherche, et une ou plusieurs applications fournisseurs extraient le contenu indexable. Pour le contenu de fichiers, le fournisseur est « Recherche plein texte - Fichiers ». Elasticsearch stocke l'index résultant et répond aux requêtes.
- Recherche en texte intégral : le cadre de base et la couche d’orchestration de la recherche.
- Recherche en texte intégral - Plateforme Elasticsearch : le connecteur qui envoie les documents et les requêtes à Elasticsearch.
- Recherche en texte intégral - Fichiers : le fournisseur qui expose les fichiers des utilisateurs au framework pour l’indexation.
- Elasticsearch 8 : le moteur de recherche externe qui stocke l’index.
Cette distinction est importante lors du dépannage. Un point de terminaison HTTP Elasticsearch fonctionnel ne prouve pas que Nextcloud peut extraire le contenu des fichiers, et un fournisseur de fichiers activé ne prouve pas que le connecteur de plateforme peut accéder à Elasticsearch. La commande intégrée fulltextsearch:testest utile car elle vérifie la chaîne configurée et non un seul composant.
Avant de commencer
Vous avez besoin d'un accès administrateur à Nextcloud, d'un accès shell au serveur ou au conteneur exécutant Nextcloud, et d'une instance Elasticsearch 8 accessible depuis cet environnement. Les exemples ci-dessous supposent l'utilisation d'un serveur Linux et de Docker pour Elasticsearch, car cela permet d'isoler le service de recherche. Si vous utilisez déjà un cluster Elasticsearch 8 géré ou dédié, utilisez plutôt son point de terminaison HTTPS existant.
En production, n'exposez pas le port 9200 directement sur Internet. La documentation Docker d'Elastic recommande de lier ce port HTTP à une interface contrôlée et de conserver les paramètres de sécurité. Elastic documente également les exigences relatives à l'hôte pour vm.max_map_countles déploiements Docker en production. Toute commande Docker mono-nœud désactivée doit être considérée comme un raccourci pour un environnement de test local et non comme un modèle de production.
Étape 1 : Installez les trois applications Nextcloud requises
Depuis la page des applications Nextcloud, installez et activez la recherche en texte intégral , la recherche en texte intégral - Elasticsearch Platform et la recherche en texte intégral - Fichiers . Vous pouvez également les installer via `npm install` occ, ce qui est souvent plus simple sur les serveurs sans interface graphique.
sudo -u www-data php /var/www/nextcloud/occ app:install fulltextsearch
sudo -u www-data php /var/www/nextcloud/occ app:install fulltextsearch_elasticsearch
sudo -u www-data php /var/www/nextcloud/occ app:install files_fulltextsearch
Si vos fichiers Nextcloud se trouvent ailleurs, modifiez le chemin d'accès occ. Dans l'image Docker officielle de Nextcloud, ce chemin est généralement `/etc/nextcloud/` /var/www/html/occ. Après l'installation, utilisez `docker ps` occ app:listpour vérifier que les trois applications apparaissent bien sous « Activées ».
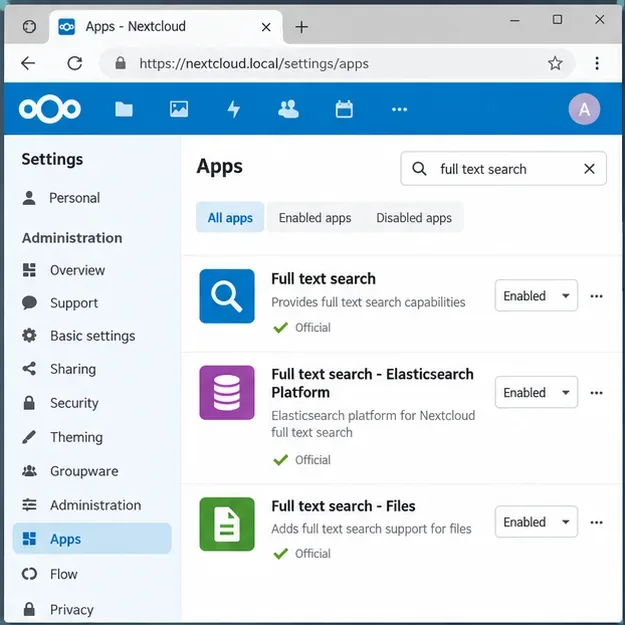
Légende : Page des applications Nextcloud avec le framework de recherche plein texte principal, le connecteur de plateforme Elasticsearch et le fournisseur de fichiers activés.
Étape 2 : Démarrez Elasticsearch 8 et vérifiez que Nextcloud peut y accéder.
Le connecteur Elasticsearch requiert Elasticsearch 8 depuis la version 26.0.0 de l'application Nextcloud. N'utilisez pas Elasticsearch 9 à la place, sauf si la déclaration de compatibilité officielle a changé pour la version de l'application que vous utilisez.
Pour un environnement de test local, Elastic propose une approche Docker mono-nœud. Une instance de test minimale peut être lancée sur une interface privée. En production, il est recommandé de conserver l'authentification et le protocole TLS activés et de suivre les instructions d'installation d'Elastic plutôt que de désactiver la sécurité.
docker run --name es01 --net elastic -p 127.0.0.1:9200:9200 -it -m 6GB docker.elastic.co/elasticsearch/elasticsearch:<ELASTICSEARCH_8_VERSION>
Le démarrage sécurisé par défaut d'Elastic affiche le mot de passe de l'utilisateur intégré elasticet crée des certificats HTTP TLS. Vous pouvez ensuite vérifier le nœud à l'aide du certificat et des informations d'identification de l'autorité de certification, comme indiqué dans le guide officiel. Si Nextcloud est exécuté dans un autre conteneur Docker, n'oubliez pas que la 127.0.0.1configuration pointe vers le conteneur Nextcloud lui-même, et non vers le conteneur Elasticsearch. Placez les deux services sur un réseau Docker partagé et utilisez le nom du service Elasticsearch, par exemple `http://localhost:8080` https://elasticsearch:9200, ou acheminez-le via une adresse privée.
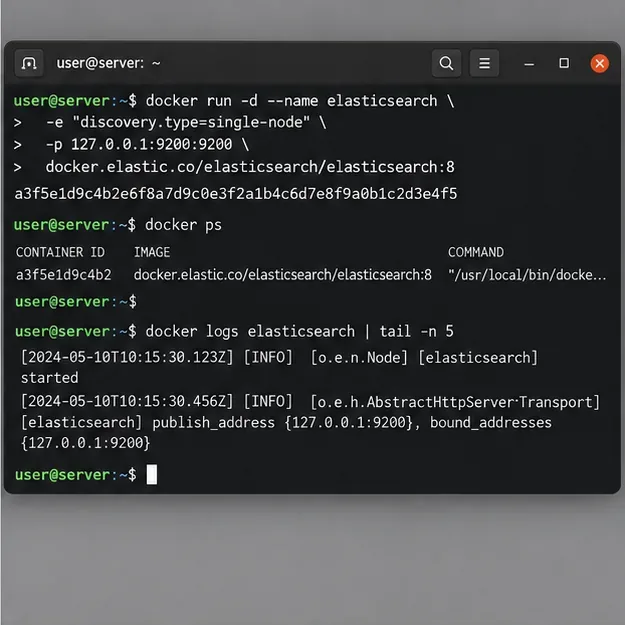
Légende : Vue terminale d’un service Elasticsearch à nœud unique en cours de démarrage et de vérification ; pour la production, conservez l’authentification et le protocole TLS activés plutôt que d’utiliser une configuration de laboratoire non sécurisée.
Étape 3 : Configurer Nextcloud pour utiliser Elasticsearch
Vous pouvez configurer la plateforme via l'interface d'administration, mais la commande en ligne de commande (CLI) est plus précise et garantit la reproductibilité. L'intégration tout-en-un de Nextcloud configure le framework en sélectionnant la classe de plateforme Elasticsearch, puis transmet l'hôte Elasticsearch et le nom de l'index au connecteur.
sudo -u www-data php /var/www/nextcloud/occ fulltextsearch:configure '{"search_platform":"OCA\\FullTextSearch_Elasticsearch\\Platform\\ElasticSearchPlatform"}'

sudo -u www-data php /var/www/nextcloud/occ fulltextsearch_elasticsearch:configure '{"elastic_host":"https://elastic:YOUR_PASSWORD@elasticsearch:9200","elastic_index":"nextcloud_index"}'
Utilisez une URL d'hôte accessible depuis le processus PHP de Nextcloud. Si votre point de terminaison Elasticsearch utilise une autorité de certification privée, assurez-vous que l'environnement Nextcloud lui fasse confiance plutôt que de désactiver la vérification des certificats. Évitez de consigner les informations d'identification dans l'historique du shell sur les systèmes partagés ; utilisez une méthode de configuration sécurisée adaptée à votre déploiement.
Le nom de l'index doit être en minuscules et spécifique à cette instance Nextcloud. Un nom comme `/etc/ nextcloud_indexnextcloud` permet de l'identifier facilement. Si plusieurs instances Nextcloud partagent un même cluster Elasticsearch, attribuez à chaque instance un nom d'index unique.
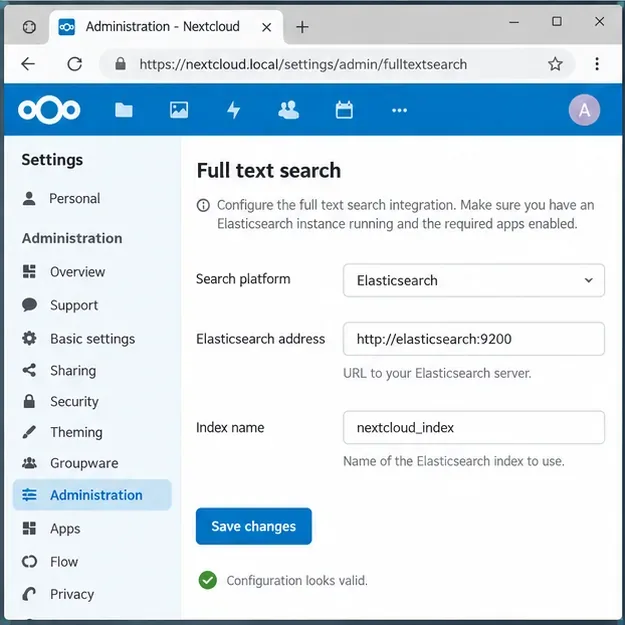
Légende : Écran d’administration de la recherche en texte intégral avec Elasticsearch sélectionné comme plateforme de recherche et un nom d’index dédié configuré.
Étape 4 : Choisir le contenu des fichiers à indexer
Le fournisseur de fichiers contrôle les catégories de contenu de fichiers envoyées pour indexation. L'initialisation tout-en-un de Nextcloud permet actuellement l'extraction de fichiers PDF et de documents bureautiques avec cette commande :
sudo -u www-data php /var/www/nextcloud/occ files_fulltextsearch:configure '{"files_pdf":true,"files_office":true}'
Les options de fournisseur disponibles peuvent varier selon la version de l'application. Vérifiez donc la configuration actuelle avant de copier les paramètres d'un tutoriel plus ancien. N'oubliez pas non plus que la qualité de l'extraction de texte dépend du fichier source. Un PDF classique contenant du texte intégré est beaucoup plus facile à indexer qu'un PDF contenant uniquement une image scannée. La recherche en texte intégral ne corrige pas automatiquement les erreurs de reconnaissance optique de caractères (OCR) de mauvaise qualité.
Étape 5 : Tester la configuration de recherche complète
Avant d'indexer une grande bibliothèque, exécutez le test du framework :
sudo -u www-data php /var/www/nextcloud/occ fulltextsearch:test
Un test réussi doit démontrer que la plateforme est accessible et que la combinaison fournisseur/plateforme configurée est fonctionnelle. En cas d'échec, corrigez la connexion avant de démarrer l'indexation initiale. Les causes fréquentes incluent l'utilisation localhostd'un conteneur incorrect, des problèmes de confiance des certificats, des échecs d'authentification, une version majeure d'Elasticsearch incompatible ou une configuration d'index rejetée par Elasticsearch.
Étape 6 : Construire l’index initial
Une fois le test réussi, créez l'index initial :
sudo -u www-data php /var/www/nextcloud/occ fulltextsearch:index
Sur un serveur de grande capacité, cette opération peut prendre du temps et consommer des ressources CPU, mémoire, E/S de stockage et de mémoire Elasticsearch. Lancez la première analyse pendant une période de faible trafic et surveillez les journaux de Nextcloud et d'Elasticsearch. Le framework prend également en charge un formulaire de réinitialisation des erreurs utilisé par Nextcloud All-in-One lors de la configuration initiale.
sudo -u www-data php /var/www/nextcloud/occ fulltextsearch:index '{"errors":"reset"}' --no-readline
Ne réinitialisez et ne reconstruisez pas sans raison un index déjà fonctionnel. Avant toute mise à jour, consultez les notes de version des trois applications de recherche afin de vérifier si une réindexation est réellement nécessaire.
Étape 7 : Maintenir l’index à jour
L'index initial n'est qu'un instantané. Les nouveaux fichiers importés et les modifications nécessitent une indexation continue. Le système de recherche plein texte inclut une fulltextsearch:livecommande pour le traitement continu. Si vous l'utilisez, exécutez-le sous un superviseur de processus ou un autre gestionnaire de services afin qu'il redémarre après une panne ou un redémarrage de l'hôte.
sudo -u www-data php /var/www/nextcloud/occ fulltextsearch:live
Ne lancez pas un processus non géré au premier plan dans une session SSH en supposant que l'indexation se poursuivra après la déconnexion. Les déploiements conteneurisés peuvent exécuter le processus de travail en direct comme un processus supervisé dédié ; les serveurs traditionnels peuvent utiliser systemd ou un superviseur. Surveillez-le comme n'importe quel autre service d'arrière-plan.
Étape 8 : Vérifiez la recherche à la fois depuis l’interface de ligne de commande et l’interface Nextcloud.
Une fois l'exploration initiale terminée, recherchez une expression figurant dans un document connu, et non seulement dans son nom de fichier. Cela confirme que l'extraction et l'indexation du contenu fonctionnent correctement. Les versions récentes de la recherche plein texte prennent également en charge la recherche par index occ, ce qui est utile pour distinguer un problème d'indexation côté serveur d'un problème lié au navigateur ou à la recherche unifiée.
Dans l'interface web, utilisez le champ de recherche de Nextcloud et recherchez une expression spécifique dans un fichier PDF, DOCX ou texte indexé. Si la recherche par nom de fichier fonctionne mais pas la recherche dans le corps du document, vérifiez les paramètres du fournisseur de fichiers et le type de document source.
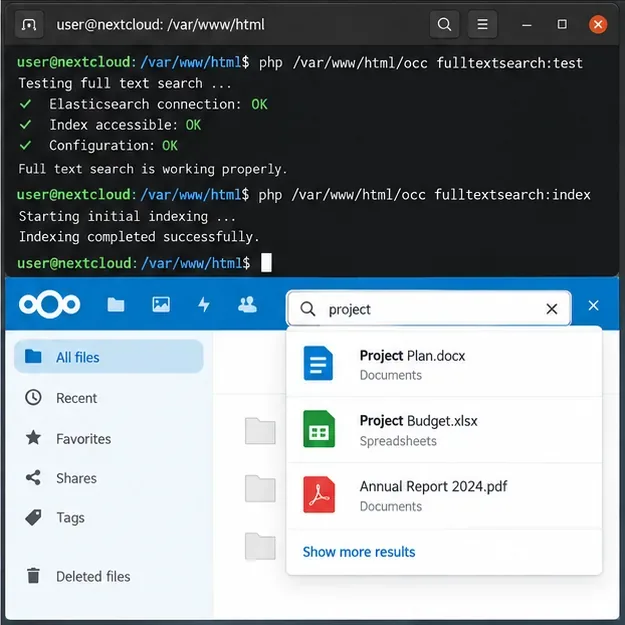
Légende : Test réussi du framework et indexation initiale, suivis d’une recherche Nextcloud qui renvoie les documents indexés.
Dépannage des pannes courantes
Elasticsearch fonctionne avec curl, mais Nextcloud ne parvient pas à se connecter.
Effectuez le test depuis le même espace de noms réseau que le processus PHP de Nextcloud. Dans Docker, une requête réussie depuis l'hôte ne garantit pas que le conteneur Nextcloud puisse résoudre ou accéder au service Elasticsearch. Vérifiez la configuration DNS, les réseaux des conteneurs, les règles de pare-feu, la confiance TLS et le schéma exact de l'URL configurée.
Le connecteur signale un problème de version d'Elasticsearch
Vérifiez la version majeure réelle d'Elasticsearch, et non pas seulement l'étiquette de l'image que vous souhaitez déployer. Le dépôt officiel du connecteur indique toujours une compatibilité avec Elasticsearch 8 pour la version 26.0.0 et les versions ultérieures. À l'heure actuelle, une demande d'intégration avec Elasticsearch 9 est en cours ; par conséquent, la compatibilité avec Elasticsearch 9 n'est pas garantie.
L'indexation utilise trop de mémoire
Surveillez simultanément la mémoire allouée à Elasticsearch, les limites de mémoire des conteneurs et la mémoire de l'hôte. La documentation de production Docker d'Elastic mentionne également les paramètres au niveau de l'hôte vm.max_map_count. Si la JVM est arrêtée, augmenter uniquement la limite de mémoire PHP de Nextcloud ne résoudra pas le problème côté Elasticsearch.
Certains fichiers partagés ou externes sont manquants.
Le comportement de la recherche peut varier selon le fournisseur et la version de l'application. Le projet du fournisseur de fichiers continue de suivre les problèmes liés aux dossiers partagés, aux dossiers de groupe et au stockage externe. Si un type de stockage se comporte différemment des fichiers locaux ordinaires, reproduisez le problème avec un exemple simple et contrôlé, puis consultez l'outil de suivi des problèmes officiel du fournisseur avant de reconstruire l'index complet.
Comment savoir si l'installation est terminée
Un déploiement réussi présente quatre signes observables : Elasticsearch 8 est accessible depuis Nextcloud, fulltextsearch:testréussit les tests, l’installation initiale fulltextsearch:indexse termine sans erreur non résolue et la recherche de texte dans un document connu renvoie ce fichier pour un utilisateur autorisé. Maintenez le point de terminaison de l’index privé, préservez la sécurité d’Elasticsearch en production et mettez à jour les trois applications de recherche Nextcloud en fonction de votre nouvelle version majeure de Nextcloud.
Pour les détails liés aux versions, consultez la liste des versions officielles de la plateforme Nextcloud Elasticsearch et le guide officiel d'utilisation de Docker en production pour Elastic . Ces sources sont les plus fiables pour vérifier la compatibilité et la configuration requise avant une mise à niveau majeure.









