Comment configurer le stockage d'objets S3 pour ownCloud Infinite Scale
ownCloud Infinite Scale peut utiliser le stockage objet compatible S3 pour les fichiers binaires tout en conservant les métadonnées sur un système de fichiers conforme à la norme POSIX. Cette distinction est essentielle : S3 ne remplace pas directement tous les répertoires de données locaux. Dans la s3ngconfiguration prise en charge, le stockage objet contient le contenu binaire des fichiers, tandis que les métadonnées restent sur un stockage POSIX, tel qu'un système de fichiers local ou NFS.
Ce guide suit la documentation actuelle sur le stockage ownCloud Infinite Scale disponible en octobre 2026. Il est destiné aux administrateurs qui découvrent le s3ngpilote et souhaitent une configuration qu'ils peuvent comprendre avant de l'adapter à Docker Compose, systemd, Kubernetes ou à une autre méthode de déploiement.
S3 est une API de stockage d'objets initialement proposée par Amazon. Un service compatible S3 stocke les données sous forme d'objets dans un compartiment et expose des opérations via des API HTTP. ownCloud Infinite Scale utilise le s3ngpilote de stockage pour placer des fichiers binaires (blobs) dans un tel compartiment.
Le stockage POSIX désigne un système de fichiers offrant le comportement attendu par Infinite Scale pour les métadonnées. Dans ce cas s3ng, les métadonnées ne sont pas déplacées vers le compartiment S3. ownCloud indique clairement que les objets blob sont transférés vers S3 tandis que les métadonnées restent sur le stockage POSIX.
Cette distinction permet d'éviter une erreur fréquente : configurer Infinite Scale pour qu'il pointe vers un compartiment et supposer que l'intégralité de l'état du serveur s'y trouve. Ce n'est pas le cas. Votre plan de sauvegarde et de restauration doit couvrir à la fois les métadonnées côté POSIX et les objets blob côté S3.
Étape 1 : Préparer le compartiment, le stockage des métadonnées, les informations d’identification et le chemin réseau
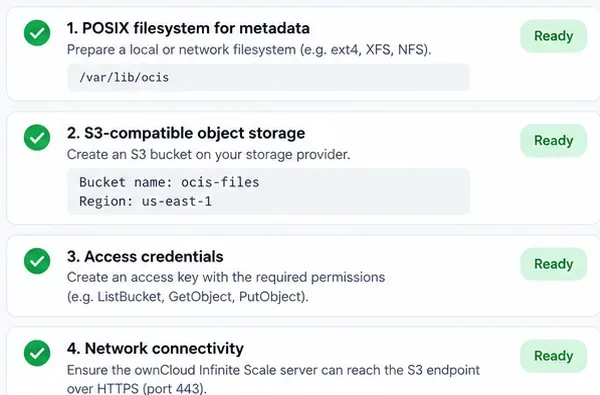
Avant de modifier Infinite Scale, préparez quatre éléments :
Un compartiment S3 dédié.
Un chemin conforme à la norme POSIX pour s3ngles métadonnées. Pour un déploiement multi-nœuds, ownCloud recommande de bien réfléchir au stockage partagé ; NFS est généralement utilisé lorsque plusieurs instances Infinite Scale doivent accéder au chemin des métadonnées.
Une clé d'accès et une clé secrète contenant uniquement les autorisations de compartiment requises par Infinite Scale.
Accessibilité réseau depuis l'hôte ou le conteneur Infinite Scale jusqu'au point de terminaison S3, normalement via HTTPS.
Avant de modifier la configuration Infinite Scale, préparez le chemin des métadonnées POSIX, le compartiment S3, les informations d'identification et la connectivité réseau.
Ne rendez pas le compartiment public. Infinite Scale s'authentifie auprès du compartiment à l'aide d'identifiants ; un accès public n'est ni requis ni souhaitable. Évitez également de réutiliser des identifiants d'administrateur généraux lorsqu'il est possible de créer une identité de service dédiée.
Si vous utilisez Amazon S3, le point de terminaison et la région suivent les conventions AWS. Si vous utilisez un autre fournisseur compatible S3, veuillez vérifier le format de son point de terminaison, le comportement des régions, les exigences TLS et la syntaxe de sa politique dans sa documentation. ownCloud signale expressément que le comportement, notamment les détails du chiffrement, peut varier d'un fournisseur à l'autre.
Étape 2 : Activez le pilote s3ng et fournissez les paramètres de connexion S3
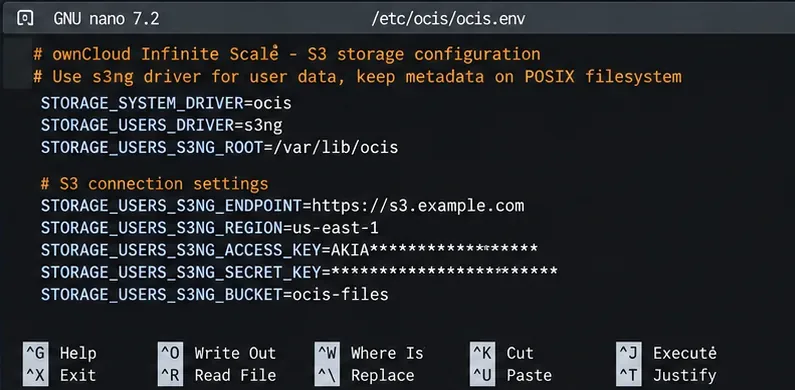
Le paramètre de stockage principal est défini STORAGE_USERS_DRIVER=s3ng. Le service Storage-Users est le composant Infinite Scale responsable du stockage des fichiers utilisateur. La configuration officielle conserve également le pilote de stockage système sur le ocisbackend normal.
Un ensemble minimal de variables d'environnement ressemble à ceci :
Les variables d'environnement essentielles s3ng connectent le service Storage-Users à S3 tout en préservant les métadonnées sur le stockage POSIX.
Les valeurs indiquées en exemple sont des espaces réservés. Utilisez le point de terminaison, la région, le compartiment et les informations d'identification fournis par votre fournisseur. Ne stockez pas la clé secrète dans un dépôt Git public. Pour l'orchestration de conteneurs, privilégiez le mécanisme de gestion des secrets de la plateforme plutôt que d'intégrer directement les informations d'identification dans un fichier Compose ou un manifeste.
Votre méthode de déploiement détermine l'emplacement de ces variables. Un déploiement Docker Compose peut les placer dans la environmentsection du service Infinite Scale ou les charger depuis un fichier d'environnement. Un déploiement systemd peut utiliser un fichier d'environnement ou une configuration d'unité. Kubernetes les injecte généralement via un Secret et un Deployment ou un StatefulSet. Seuls les noms des variables importent ; la syntaxe qui les entoure dépend de votre plateforme.
Étape 3 : Accorder au compartiment les autorisations nécessaires à Infinite Scale
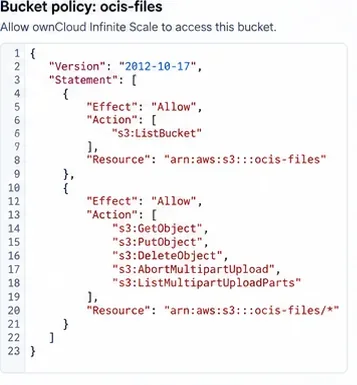
Une politique de compartiment est une règle de gestion des identités et des accès (IAM) qui contrôle les actions qu'une identité authentifiée peut effectuer sur un compartiment et ses objets. ownCloud publie un modèle de politique requis pour le s3ngpilote.
Remplacez bucket-namedans la politique suivante par le nom réel de votre compartiment :
La structure de la politique doit autoriser le listage des compartiments ainsi que les opérations d'envoi d'objets et de chargement multipart requises par le pilote s3ng. Utilisez la politique exacte décrite dans la documentation officielle pour votre déploiement.
Ne résolvez pas une erreur d'accès refusé en accordant les autorisations s3:*à tous les compartiments du compte. Commencez par les autorisations documentées au niveau du compartiment, puis adaptez-les uniquement si votre fournisseur S3 exige des autorisations équivalentes.
Étape 4 : Redémarrez Infinite Scale et vérifiez le chemin de stockage
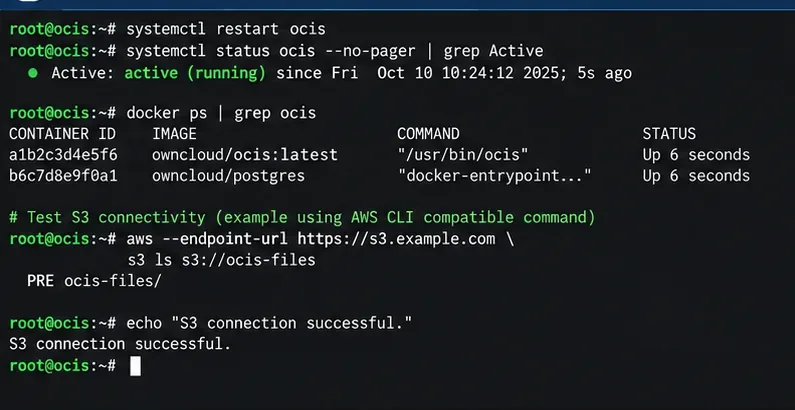
Appliquez la configuration en suivant la procédure de redémarrage habituelle de votre déploiement. Par exemple, une installation systemd peut utiliser la commande `restart` systemctl restart ocis, tandis qu'un déploiement Compose recréera ou redémarrera les conteneurs de service concernés. Consultez les journaux immédiatement après le démarrage pour détecter les erreurs d'authentification, de DNS, de TLS, de région ou d'autorisation.
Après avoir appliqué la configuration, redémarrez les services Infinite Scale concernés et vérifiez que l'hôte peut accéder au compartiment prévu et s'y authentifier.
L'exécution d'une requête de liste de compartiment avec l'interface de ligne de commande de votre fournisseur S3 prouve que l'hôte et les identifiants permettent d'accéder au compartiment, mais ne prouve pas à elle seule qu'Infinite Scale écrit correctement les blobs. Le test de bout en bout le plus fiable consiste à démarrer Infinite Scale, à téléverser un petit fichier via l'interface web d'ownCloud, à le télécharger à nouveau et à consulter les journaux du service pour détecter d'éventuelles erreurs.
Si votre version d'Infinite Scale installée inclut la commande de maintenance du blobstore documentée par ownCloud, vous pouvez également l'utiliser ocis storage-users blobstore check. ownCloud décrit cette commande comme un aller-retour entre le chargement, le téléchargement et la suppression de données sur le blobstore configuré. Consultez la documentation officielle de vérification du blobstore pour connaître la syntaxe spécifique à votre version.
Ne vous attendez pas à ce que les noms de fichiers d'origine apparaissent comme des objets S3 normaux
L'une des erreurs les plus fréquentes consiste à parcourir le compartiment et à s'attendre à retrouver une arborescence de dossiers utilisateur classique Documents/report.pdf. Infinite Scale considère S3 comme un espace de stockage d'objets blob, et non comme un système de fichiers accessible à l'utilisateur. Le format de clé documenté s3ngrepose sur les identifiants d'espace et d'objet blob, tandis que l'espace de noms lisible par l'utilisateur est reconstruit à partir des métadonnées.
Cela signifie que vous ne devez pas renommer, réorganiser ou supprimer manuellement des objets dans le bucket simplement parce que leurs clés semblent inconnues. Gérez les fichiers utilisateur via ownCloud. Toute manipulation directe du bucket peut rompre le lien entre les métadonnées et les blobs.
Fichiers volumineux : vérifiez la taille des pièces multiparties avant la production.
S3 utilise le chargement multipart pour diviser les objets volumineux en plusieurs parties. La documentation ownCloud STORAGE_USERS_S3NG_PUT_OBJECT_PART_SIZEexplique comment contrôler la taille des parties. La valeur par défaut, lorsqu'aucune valeur explicite n'est fournie, est de 16 Mio.
Amazon S3 autorise un maximum de 10 000 parties par chargement multipart. Avec une taille de partie de 16 Mio, cela correspond à environ 160 Gio avant que la limite du nombre de parties ne pose problème. Si vos utilisateurs chargent régulièrement des fichiers volumineux, calculez la taille de partie requise avant la mise en production plutôt que d'attendre qu'un transfert important échoue.
Le compromis est simple : des compartiments plus grands permettent de gérer des fichiers plus volumineux avec moins de requêtes, mais ils modifient également les caractéristiques de mémoire, de mise en mémoire tampon, de nouvelle tentative et de transfert. ownCloud précise également que les données des fichiers entrants nécessitent un stockage temporaire pendant leur mise en mémoire tampon ; la planification de la capacité doit donc prendre en compte davantage que le seul compartiment distant.
Problèmes courants et points à vérifier en premier
Symptôme
Zone probable
Premier contrôle
Accès refusé
politique d'identification ou de compartiment
Confirmez la clé d'accès, la clé secrète, l'ARN du compartiment et les actions requises.
Seau introuvable
Nom du compartiment, point de terminaison ou région
Vérifiez le nom exact du compartiment et la combinaison point de terminaison/région spécifique au fournisseur.
Erreur TLS ou de certificat
confiance HTTPS
Vérifiez que le certificat du point de terminaison est valide et approuvé au sein de l'hôte/conteneur Infinite Scale.
Les petits fichiers fonctionnent, mais les très gros fichiers échouent.
dimensionnement en plusieurs parties
Vérifiez STORAGE_USERS_S3NG_PUT_OBJECT_PART_SIZEles limites de votre fournisseur pour les paiements en plusieurs parties.
Les fichiers disparaissent après la restauration du seul S3.
Sauvegarde incomplète
Restaurez les métadonnées POSIX et les blobs S3 sous forme d'un seul ensemble de données cohérent.
Sauvegardez simultanément les blobs S3 et les métadonnées POSIX
Avec s3ngownCloud, le bucket ne représente que la moitié de l'état de stockage. La documentation de sauvegarde d'ownCloud indique qu'une configuration S3 distribuée doit inclure la configuration, les données système, les métadonnées et les blobs. La documentation de restauration exige également que ces ensembles de données soient restaurés de manière cohérente.
Pour un service de production, documentez le montage des métadonnées, le compartiment, les identifiants ou le rôle, les fichiers de configuration et la procédure de sauvegarde dans le même manuel d'exploitation. Testez la restauration avant de vous fier à la conception. Les références officielles pertinentes sont le guide de sauvegarde et les considérations relatives à la restauration d'ownCloud .
Point de départ recommandé
Pour un premier déploiement, privilégiez une conception simple : utilisez un compartiment S3 dédié aux objets blob, un chemin de métadonnées POSIX persistant, une identité de service dédiée avec les autorisations de compartiment documentées, HTTPS vers le point de terminaison de stockage d’objets et les paramètres multipart par défaut, sauf si la taille de vos fichiers prévus nécessite une modification.
Après la configuration, validez trois niveaux séparément : l’accès réseau et l’authentification au bucket, le démarrage d’Infinite Scale sans erreur de stockage et un transfert effectif (téléchargement/chargement) via ownCloud. Une fois ces vérifications réussies, passez à la surveillance, aux sauvegardes, aux règles de cycle de vie et à l’optimisation des performances. Cette méthode facilite grandement le dépannage, car chaque test répond à une question différente au lieu de considérer le bon fonctionnement de S3 comme un simple résultat binaire.