Accueil
» ADMINISTRATEUR RÉSEAU
»
Comment résoudre le problème de mémoire insuffisante de Matrix Synapse pendant la synchronisation ?
Comment résoudre le problème de mémoire insuffisante de Matrix Synapse pendant la synchronisation ?
Au 6 octobre 2026, la dernière version stable de Matrix Synapse est la 1.162.0, publiée le 29 septembre 2026. Si votre serveur domestique manque de mémoire lors de la synchronisation des clients, la mise à jour vers une version compatible est une première étape judicieuse. Cependant, la solution durable réside généralement dans une modification du fonctionnement global plutôt que dans un simple paramètre. Synapse conserve intentionnellement en mémoire les données et métadonnées récentes des salles afin d'accélérer les requêtes fréquentes. La documentation officielle pour les administrateurs met en garde contre une réduction trop drastique des caches, qui peut aggraver la saturation de la mémoire en créant un arriéré de requêtes lentes.
Ce guide décrit la procédure à suivre en toute sécurité pour un nouvel administrateur : comprendre le fonctionnement de la synchronisation, vérifier que le processus atteint bien la limite de mémoire, réduire la pression inutile sur le cache, isoler le trafic de synchronisation initial exceptionnellement important si nécessaire, et surveiller le résultat. L’objectif n’est pas simplement de réduire la taille de l’ensemble résident, mais d’éviter les plantages dus à une insuffisance de mémoire tout en maintenant la réactivité du serveur.
Que signifie « sync » dans Matrix Synapse ?
Un client Matrix appelle régulièrement l'API client-serveur /_matrix/client/v3/syncpour recevoir les nouveaux événements tels que les messages, l'état des salles, les données de compte, les informations de présence et les mises à jour des appareils. Une synchronisation régulière inclut généralement un sincejeton, ce qui permet à Synapse de ne renvoyer que les modifications postérieures à la dernière synchronisation.
La synchronisation initiale est différente. Il s'agit de la première synchronisation pour un appareil ou une session et elle ne dispose d'aucun sincejeton précédent. La documentation officielle du worker Synapse indique que ces requêtes peuvent être très gourmandes en ressources. Sur les serveurs domestiques de grande capacité, Synapse permet de séparer le routage de la synchronisation initiale de celui des synchronisations en cours afin que quelques synchronisations initiales coûteuses ne perturbent pas les autres utilisateurs.
Notez votre version de Synapse et sa méthode d'installation.
Sauvegardez homeserver.yamlles fichiers de configuration du worker, la configuration du proxy inverse et la base de données PostgreSQL conformément à votre procédure de sauvegarde habituelle.
Notez si Synapse s'exécute comme un seul processus, dans des conteneurs, ou comme un processus principal avec des processus de travail.
Déterminez la limite de mémoire réelle. Un conteneur, une unité systemd, un pod Kubernetes ou une machine virtuelle peut avoir une limite inférieure à celle du serveur physique.
Veuillez confirmer que PostgreSQL est bien utilisé en production. La documentation d'installation actuelle de Synapse indique que SQLite est destiné aux tests et présente de faibles performances pour les charges de travail en production, notamment pour les grands volumes de données.
Étape 1 : Confirmer que la défaillance réelle est bien l’épuisement de la mémoire
Ne commencez pas par modifier les valeurs du cache. Identifiez d'abord quel processus Synapse consomme de la mémoire et déterminez s'il est arrêté par le système d'exploitation ou par une limite de conteneur.
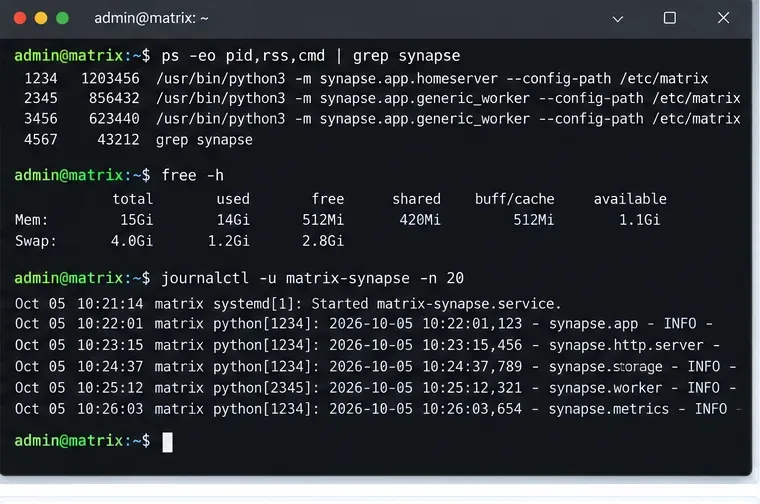
Commencez par examiner le flux RSS du processus, la mémoire disponible, la pression sur l'espace d'échange et les journaux récents du service Synapse afin de déterminer s'il s'agit d'une véritable saturation de la mémoire ou d'une autre défaillance de synchronisation.
Sur un hôte Linux, des commandes telles que les suivantes permettent d'obtenir un premier aperçu rapide :
Si vous utilisez Docker, Podman, Kubernetes ou un autre système de planification, vérifiez également la limite de mémoire du conteneur ou du pod. Un hôte disposant de plusieurs gigaoctets d'espace libre peut tout de même interrompre Synapse si le processus est limité par un cgroup beaucoup plus restreint.
Recherchez un schéma récurrent. La mémoire augmente-t-elle uniquement lorsqu'un utilisateur spécifique se connecte sur un nouvel appareil ? Augmente-t-elle progressivement tout au long de la journée ? Un processus générique voit-il sa consommation augmenter tandis que le processus principal reste stable ? Ces observations permettent de distinguer un pic de synchronisation initial d'une croissance générale du cache ou d'un engorgement des requêtes.
Étape 2 : Vérifiez les paramètres du cache avant de les réduire.
Un cache est une zone de données que Synapse conserve en mémoire vive (RAM) afin d'éviter de recalculer ou de recharger constamment les mêmes informations. Synapse utilise plusieurs caches, ainsi qu'un cache d'événements. La documentation de configuration indique actuellement une valeur par défaut caches.global_factorde 0,5 pour le cache, une event_cache_sizetaille de cache par défaut de 10 000 avant l'application du facteur global, une expiration du cache basée sur le temps et une durée de sync_response_cache_durationvie par défaut de 2 minutes.
La solution tentante consiste à réduire au maximum le facteur global. Ne le faites pas sans réfléchir. La FAQ de l'administrateur Synapse avertit explicitement qu'un cache trop petit peut ralentir davantage un système déjà lent, entraînant une accumulation de requêtes et une explosion de la consommation de mémoire due à l'encombrement plutôt qu'aux entrées du cache.
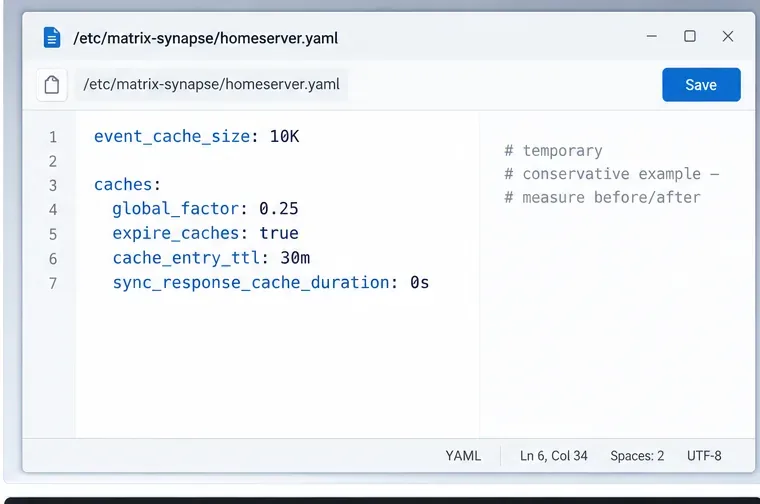
Modifiez le cache avec prudence et mesurez le résultat ; cet exemple illustre l’emplacement des paramètres pertinents plutôt qu’une valeur de production universelle.
Si l'analyse des données montre que la mémoire cache est effectivement le principal consommateur de ressources et que le débit des requêtes reste satisfaisant, essayez une réduction modérée plutôt qu'une réduction drastique. Par exemple :
Il s'agit d'un exemple de dépannage, et non d'une valeur recommandée pour tous les serveurs. La valeur sync_response_cache_durationzéro désactive la mise en cache des /syncréponses complètes. Cela peut économiser de la mémoire lorsque de nombreuses réponses de synchronisation sont conservées, mais risque d'alourdir la charge de travail des clients se reconnectant. Testez cette configuration avec votre charge de travail réelle.
Synapse propose également un réglage automatique du cache avec les options `cache_autotuning` max_cache_memory_usage, target_cache_memory_usage`cache_autotuning` et `cache_autotuning` min_cache_ttl. La documentation officielle indique que cette fonctionnalité nécessite `jemalloc` , un allocateur de mémoire alternatif, et que les trois options doivent être renseignées. Il est déconseillé d'activer seulement une ou deux valeurs ; la documentation avertit qu'une configuration incomplète peut entraîner un comportement instable.
Étape 3 : Assurez-vous que la base de données ne génère pas d’accumulation de requêtes.
Les problèmes de mémoire lors de la synchronisation ne sont pas toujours dus à la quantité de données mises en cache. Une base de données lente peut gérer simultanément de nombreuses requêtes, et chaque requête en cours consomme de la mémoire. C'est pourquoi réduire la taille du cache peut s'avérer contre-productif pour un système de stockage déjà lent.
Pour la production, suivez le guide officiel Synapse PostgreSQL . Vérifiez l'utilisation du processeur, la latence de stockage, la saturation des connexions, les requêtes longues et l'utilisation de la mémoire virtuelle par le serveur PostgreSQL. Si la latence de synchronisation augmente simultanément à l'utilisation de la mémoire résidente, examinez le backlog avant de réduire à nouveau la taille des caches.
Si vous avez récemment migré vers de grands espaces publics, intégré des communautés beaucoup plus vastes ou ajouté de nombreux utilisateurs actifs, la charge de travail a peut-être tout simplement dépassé les capacités d'une configuration auparavant adaptée. Dans ce cas, l'optimisation de la base de données et l'isolation des processus sont souvent plus importantes que la simple réduction de la taille d'un cache.
Étape 4 : Isoler la synchronisation initiale sur les serveurs domestiques les plus importants
Synapse peut fonctionner comme un monolithe unique , c'est-à-dire avec un seul processus serveur principal, ou répartir la charge de travail sur des processus Synapse supplémentaires partageant la même base de données PostgreSQL. Le modèle avec processus secondaires est destiné aux installations de grande envergure nécessitant une mise à l'échelle indépendante des charges de travail individuelles.
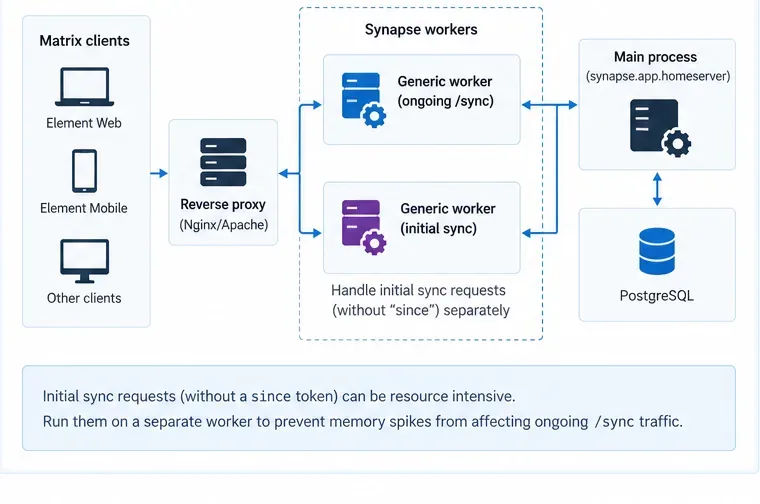
Sur les déploiements plus importants utilisant PostgreSQL, acheminez la synchronisation initiale coûteuse séparément de la synchronisation continue afin que la première connexion ne consomme pas le même pool de travailleurs que les mises à jour normales du client.
La documentation du worker indique qu'un worker générique peut gérer /syncles /initialSyncrequêtes de synchronisation sans paramètre. Elle recommande également d'envisager un traitement séparé pour sinceces requêtes initiales, car elles peuvent être très gourmandes en ressources.
Une architecture pratique est :
Le proxy inverse reçoit le trafic du client Matrix.
Les requêtes en cours /syncsont acheminées vers un ou plusieurs processus génériques.
Les requêtes de synchronisation initiales sont envoyées à un groupe de travailleurs génériques distinct.
Le processus principal continue de traiter les responsabilités qui ne sont pas déléguées.
Tous les processus Synapse partagent PostgreSQL.
Ne pas exposer l'écouteur de réplication Synapse à Internet. La documentation actuelle du worker indique que le trafic de réplication n'est ni chiffré ni authentifié, sauf si un secret de réplication est configuré.
L'ajout de workers n'est pas la solution idéale pour un petit serveur domestique. Synapse recommande d'ailleurs le mode monolithe pour les instances de petite taille. N'ajoutez des workers que lorsque vous avez la preuve qu'une charge de travail particulière nécessite une isolation ou une mise à l'échelle horizontale.
Étape 5 : Rechargez les facteurs de cache en toute sécurité et observez le résultat.
Synapse permet de recharger les facteurs de cache SIGHUP. La documentation de configuration donne cet exemple :
kill -HUP PID_OF_SYNAPSE_PROCESS
Si le service systemd inclus le prend en charge, systemctl reload matrix-synapseil peut effectuer la même opération. Dans un déploiement en mode worker, la documentation officielle indique que la configuration du worker concerné doit être mise à jour et que chaque worker doit recevoir individuellement le signal de rechargement.
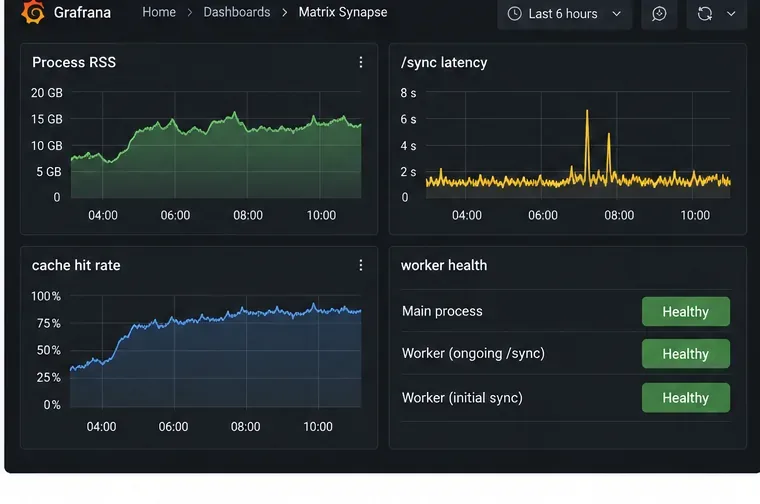
Après chaque modification, laissez au serveur le temps de retrouver un trafic normal. Surveillez simultanément la mémoire résidente, la latence des requêtes, la charge de la base de données et l'état des processus actifs. Une chute de la mémoire et un doublement de la latence de synchronisation indiquent que la correction n'est pas efficace.
Étape 6 : Activer les indicateurs Prometheus pour un diagnostic reproductible
Pour tout incident récurrent, activez les métriques Synapse et collectez-les avec Prometheus. Consultez le guide de surveillance officiel enable_metrics: trueet configurez un écouteur de métriques interne dédié. Placez le point de terminaison des métriques sur une interface interne ou protégez-le au niveau du proxy inverse ; il ne doit pas être exposé inutilement.
Surveillez simultanément la mémoire et la latence de synchronisation. L'objectif est d'obtenir une mémoire stable avec un temps de réponse acceptable, et non la valeur RSS la plus faible possible.
Diminuer la valeur de SYNAPSE_CACHE_FACTOR jusqu'à ce que le serveur devienne plus lent
Un cache plus petit utilise moins de mémoire par entrée, mais augmente la charge de calcul et le travail de la base de données. Si ce travail supplémentaire engendre une file d'attente de requêtes non traitées, la mémoire totale utilisée peut augmenter au lieu de diminuer. Réduisez donc le facteur par petites étapes et surveillez toujours la latence.
En supposant que chaque requête /sync coûte le même prix
Une synchronisation en cours avec un sincejeton et une synchronisation initiale sans jeton présentent des profils de ressources très différents. Distinguez-les dans votre diagnostic avant de dimensionner l'ensemble du serveur.
Utilisation des workers tout en étant encore sur SQLite
Les nœuds de calcul Synapse partagent une base de données PostgreSQL. La documentation précise que SQLite est réservé aux démonstrations et aux tests et ne constitue pas la base d'un déploiement en production basé sur les nœuds de calcul.
Utiliser l'échange comme solution principale
Un faible volume d'espace d'échange peut éviter l'arrêt brutal d'un processus, mais un volume important d'espace d'échange ralentit considérablement la synchronisation et peut engendrer le même cercle vicieux de saturation. Il convient de considérer l'espace d'échange comme une protection contre un pic de charge ponctuel, et non comme un outil de planification de la capacité.
Modifier plusieurs paramètres de mémoire simultanément
Si vous réduisez simultanément la taille des caches, modifiez le routage des workers, ajustez les paramètres de PostgreSQL et augmentez la limite d'un conteneur, vous ne saurez pas quelle modification a résolu le problème. Procédez par étapes, en effectuant une seule modification contrôlée à la fois, et comparez les résultats.
Un chemin de décision pratique
Ce que vous observez
Prochaine action probable
Pics de mémoire lorsque les utilisateurs se connectent sur de nouveaux appareils
Identifiez la synchronisation initiale et envisagez de l'isoler sur un nœud de calcul pour les déploiements de grande envergure.
La mémoire augmente régulièrement tandis que le taux d'accès au cache est élevé et que la latence est normale.
Réduisez la capacité du cache par précaution et effectuez un nouveau test.
La latence de la mémoire et de la synchronisation augmente simultanément.
Examinez l'encombrement des bases de données ou du stockage avant de réduire davantage les caches.
Un seul travailleur atteint sa limite
Ajustez le budget mémoire de ce nœud de calcul ou dimensionnez ce groupe de nœuds plutôt que l'ensemble du serveur principal.
L'hôte dispose de RAM libre, mais Synapse est arrêté.
Vérifiez les limites de mémoire des conteneurs, cgroups, systemd ou Kubernetes.
Liste de vérification finale
Utilisez une version actuelle de Synapse prise en charge ; la version 1.162.0 est la dernière version stable au 6 octobre 2026.
Utilisez PostgreSQL en production.
Vérifiez quel processus consomme réellement le flux RSS et quelle limite de mémoire lui est applicable.
Distinguer la synchronisation incrémentale normale de la synchronisation initiale.
Laissez l'expiration du cache activée et ajustez progressivement les facteurs de cache.
N’activez pas le réglage automatique du cache sauf si jemalloc est utilisé et que toutes les valeurs requises sont configurées.
Pour les déploiements de grande envergure, isolez la synchronisation initiale ou ajoutez des processus de synchronisation génériques lorsque les mesures le justifient.
Surveillez simultanément la mémoire et la latence après chaque modification.
Synapse est volontairement gourmand en mémoire car la mise en cache fait partie intégrante de sa stratégie de performance. La solution appropriée aux erreurs de mémoire insuffisante liées à la synchronisation consiste donc à trouver un juste équilibre : supprimer la conservation inutile du cache, éliminer l’encombrement des bases de données ou des requêtes, et isoler les charges de travail exceptionnelles sans pour autant saturer les caches qui assurent la rapidité de la synchronisation normale. Cette approche est plus fiable que de considérer le nombre RSS le plus élevé comme la seule cause du problème.