Un serveur Matrix Synapse peut fonctionner correctement pendant plusieurs jours, puis soudainement laisser PostgreSQL consommer la majeure partie de la RAM disponible. Les symptômes habituels sont bien connus : la mémoire d'échange augmente, la synchronisation des clients ralentit, les tâches de fédération s'accumulent et un serveur pourtant modeste devient difficile à administrer. La première étape cruciale est de ne pas supposer que PostgreSQL présente une fuite de mémoire. Une forte consommation de mémoire peut provenir de plusieurs sources indépendantes, notamment le cache de mémoire partagée, la mémoire de travail allouée aux requêtes, la présence de nombreux backends de base de données, les processus de maintenance et les requêtes inefficaces dues à des statistiques obsolètes ou à une forte activité des tables.
La documentation de Synapse recommande PostgreSQL pour la production et propose des options de contrôle du pool de connexions, comme ` cp_minrequire` et `password` cp_max. PostgreSQL, de son côté, avertit que des paramètres tels que `require` work_mempeuvent être utilisés par plusieurs opérations au sein d'une même requête et par de nombreuses sessions simultanément. C'est pourquoi un paramètre apparemment inoffensif pris isolément peut s'avérer coûteux en période de forte activité. La solution la plus sûre consiste à mesurer d'abord la consommation de mémoire, puis à réduire la concurrence inutile, et enfin à optimiser le comportement en matière de gestion de la mémoire et de maintenance uniquement lorsque cela s'avère nécessaire.
Étape 1 : Confirmer que PostgreSQL est bien la source de la pression sur la mémoire
Commencez par examiner le système d'exploitation. Sous Linux, comparez la mémoire totale, la mémoire disponible, le swap et les processus les plus gourmands en ressources :
free -h
ps aux --sort=-%mem | head -n 15
Ne jugez pas le serveur à partir d'une seule ligne de processus. PostgreSQL utilise la mémoire partagée et la mémoire privée dans ses processus backend ; il est donc pertinent de se demander si le serveur est réellement sous pression : mémoire disponible insuffisante, augmentation de la mémoire d'échange, interruptions dues à un manque de mémoire (OOM) ou latence persistante. Relevez les données pendant une période creuse, puis à nouveau pendant une période de forte activité. Cette base de référence permettra de mesurer les modifications ultérieures au lieu de les considérer comme de simples conjectures.
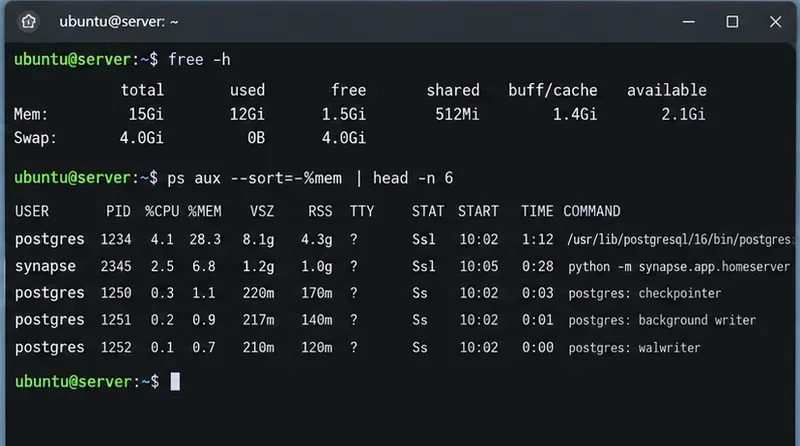
Légende : Une première vérification de la mémoire compare la RAM disponible au niveau de l’hôte avec les processus PostgreSQL et Synapse avant toute modification de la configuration.
Ensuite, examinez les paramètres PostgreSQL les plus susceptibles d'affecter la mémoire :
SHOW shared_buffers;
SHOW work_mem;
SHOW maintenance_work_mem;
SHOW autovacuum_work_mem;
SHOW max_connections;
La documentation de PostgreSQL sur la consommation des ressources décrit la distinction essentielle. shared_buffersLe cache partagé est utilisé à l'échelle du serveur. En revanche, work_memle cache temporaire limite la taille des opérations de tri ou de hachage individuelles avant qu'elles ne soient écrites dans des fichiers temporaires ; une requête complexe peut comporter plusieurs de ces opérations, et plusieurs sessions peuvent les exécuter simultanément. PostgreSQL indique actuellement 4 Mo comme work_memvaleur par défaut et précise que l'utilisation totale peut être bien supérieure.
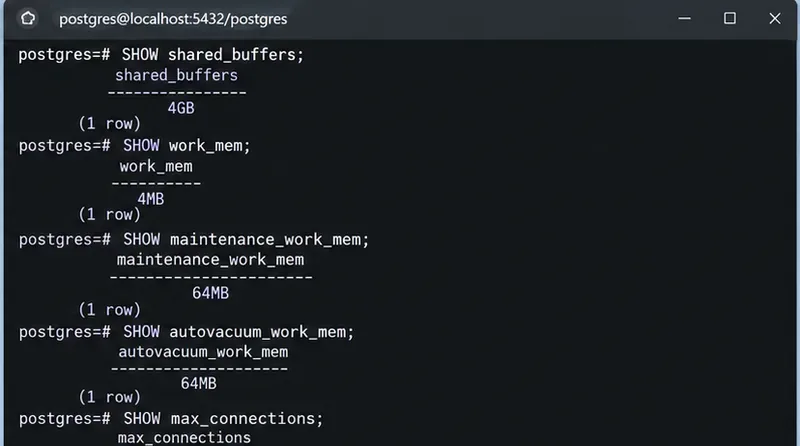
Légende : Lisez les paramètres de mémoire actifs de PostgreSQL avant de les modifier ; la valeur dangereuse est souvent la combinaison des paramètres et de la concurrence plutôt qu’un seul chiffre.
Étape 2 : Compter les connexions à la base de données Synapse et identifier les tâches actives
Un grand pool de connexions ne consomme pas automatiquement de mémoire work_mempour chaque connexion, mais chaque serveur PostgreSQL possède son propre processus et sa propre mémoire privée. Plus il y a de requêtes simultanées, plus les possibilités d'allocation de mémoire par opération augmentent. Vérifiez le nombre de connexions ouvertes et leur état :
SELECT state,
       usename,
       application_name,
       count(*) AS connections
FROM pg_stat_activity
GROUP BY state, usename, application_name
ORDER BY connections DESC;
Examinez ensuite les requêtes actives de longue durée :
SELECT pid,
       usename,
       state,
       now() - query_start AS running_for,
       wait_event_type,
       wait_event,
       left(query, 180) AS query
FROM pg_stat_activity
WHERE state <> 'idle'
ORDER BY query_start;
La documentation officiellepg_stat_activity explique les champs session et activité. Un grand nombre de sessions inactives est différent d'un petit nombre de requêtes actives gourmandes en mémoire ; la solution doit donc être différente également. Si le problème provient du nombre de connexions, il faut ajuster la taille du pool d'adresses. Si le problème provient de quelques requêtes gourmandes en mémoire, réduire la taille du pool risque de masquer le symptôme.
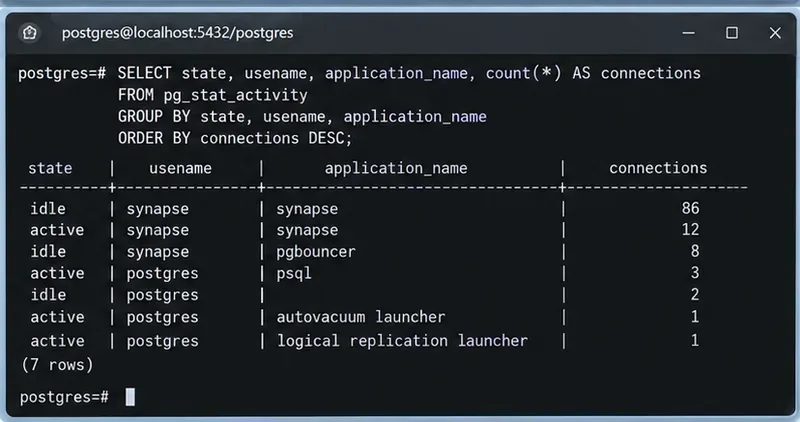
Légende : Le regroupement pg_stat_activityfacilite la distinction entre de nombreux processus inactifs et un ensemble plus restreint de sessions de base de données actives.
Étape 3 : Dimensionner correctement le pool de connexions Synapse PostgreSQL
Synapse transmet la plupart des arguments de base de données à PostgreSQL tout en utilisant les options commençant par `--twisted` cp_pour son pool de connexions Twisted. Le guide Synapse PostgreSQL actuel présente un exemple avec `--twisted` cp_min: 5et ` cp_max: 10--twisted`. Ces valeurs sont données à titre d'exemple et ne constituent pas une cible universelle.
Vérifiez le databasebloc dans homeserver.yaml:
database:
  name: psycopg2
  args:
    user: synapse_user
    password: "your-secret"
    dbname: synapse
    host: 127.0.0.1
    cp_min: 5
    cp_max: 10
Si vous avez précédemment augmenté le nombre de connexions Synapse cp_maxde manière excessive et pg_stat_activityque cela entraîne un grand nombre de connexions majoritairement inactives, réduisez-le progressivement et surveillez la latence des requêtes. Dans un déploiement Synapse basé sur plusieurs processus, n'oubliez pas que la demande de base de données provient de plusieurs processus Synapse ; évaluez donc le nombre total de connexions plutôt que celui d'un seul processus. Le manuel de configuration de Synapse confirme que cp_les options permettent de configurer le pool de connexions.
Après avoir modifié la configuration, redémarrez le ou les processus Synapse concernés selon votre méthode de déploiement, puis exécutez à nouveau la requête de comptage des connexions. Ne réduisez pas la taille du pool tant que les requêtes ne commencent pas à s'accumuler, même pour économiser quelques mégaoctets. Un pool trop petit peut entraîner une latence applicative due à la concurrence au niveau de la base de données.
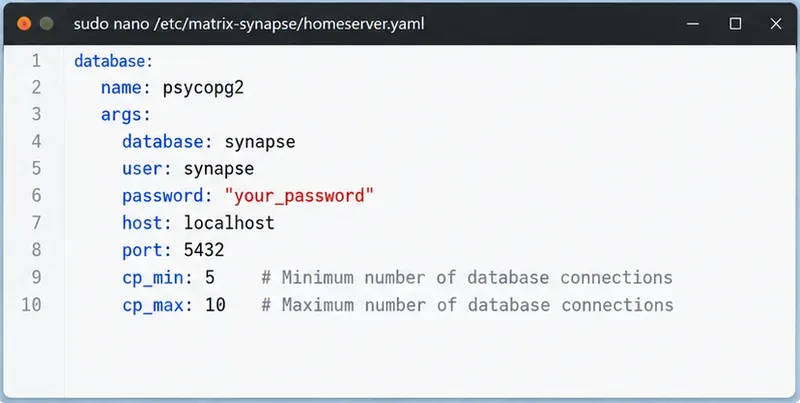
Légende : Synapse expose cp_minet cp_maxdans la configuration de la base de données PostgreSQL, permettant aux administrateurs de limiter la concurrence inutile du backend.
Étape 4 : Optimiser la mémoire de PostgreSQL de manière prudente
Une fois le nombre de connexions raisonnable, examinez les paramètres de mémoire de PostgreSQL en fonction de la RAM réellement disponible pour la base de données. PostgreSQL indique que sur un serveur de base de données dédié doté d'au moins 1 Go de RAM, environ 25 % de la mémoire système constituent un point de départ raisonnable shared_buffers. Cette recommandation s'applique spécifiquement à un serveur de base de données dédié. Si Synapse, le proxy inverse, Redis, la supervision et PostgreSQL partagent une même machine virtuelle, PostgreSQL n'occupe pas la totalité de la machine ; adaptez donc votre budget en conséquence.
Le paramètre le plus susceptible de surprendre les administrateurs est `<valeur>` work_mem. Évitez de multiplier work_mempar ` max_connections<valeur>` et de considérer cela comme une réservation ferme ; PostgreSQL ne pré-alloue pas la mémoire de cette manière. Il est préférable de raisonner en termes d'opérations de requêtes simultanées. Une seule requête peut utiliser plusieurs nœuds de tri ou de hachage, et les opérations de hachage peuvent utiliser un multiple de `<valeur>` work_mem. Si vous définissez `<valeur>` work_memsur une valeur très élevée globalement parce qu'un rapport était lent, un pic de fédération ou une période de synchronisation intense peut générer un pic de mémoire bien plus important que prévu.
Il est judicieux de conserver une valeur globale prudente et de l'augmenter uniquement pour une session d'administration spécifique, lorsqu'une requête connue nécessite davantage de mémoire. Avant toute modification, conservez votre configuration actuelle et notez les paramètres qui requièrent un redémarrage de PostgreSQL. shared_buffersPar exemple, `restart_file` est un paramètre de démarrage du serveur. Planifiez les modifications afin de pouvoir comparer la consommation de mémoire, la latence et le comportement des fichiers temporaires avant et après.
Vérifiez également ` autovacuum` maintenance_work_memet ` autovacuum_work_memautovacuum`. PostgreSQL indique que les processus d'autovacuum peuvent allouer de la mémoire de maintenance simultanément. Si ` autovacuum` conserve autovacuum_work_memson comportement par défaut, une valeur anormalement élevée maintenance_work_mempeut rendre l'exécution simultanée de plusieurs processus d'autovacuum coûteuse. Ne désactivez pas l'autovacuum pour économiser de la RAM ; cela se traduit généralement par une augmentation de la taille des tables, des statistiques obsolètes et une baisse des performances, au détriment d'un problème de mémoire à court terme.
Étape 5 : Vérifier l’état du système d’aspiration, puis tester la correction en conditions réelles de charge.
Synapse écrit et met à jour d'importantes quantités de données d'événements et d'état. PostgreSQL nécessite un nettoyage régulier pour récupérer les tuples obsolètes et maintenir à jour les statistiques du planificateur. Le guide de nettoyage régulier de PostgreSQL recommande l'utilisation d'autovacuum pour la plupart des installations.
Recherchez les tables comportant de nombreux tuples morts estimés ou des horodatages de maintenance obsolètes :
SELECT relname,
       n_live_tup,
       n_dead_tup,
       last_autovacuum,
       last_autoanalyze
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;
Si un tableau spécifique nécessite clairement une attention particulière, une analyse VACUUM (ANALYZE)manuelle est généralement le premier outil à envisager :
VACUUM (ANALYZE) your_table_name;
Évitez de passer directement à VACUUM VACUUM FULL. La documentation officielle explique que VACUUM VACUUMpeut fonctionner en parallèle des opérations de lecture et d'écriture normales, tandis que VACUUM FULLVACUUM réécrit la table et verrouille la ACCESS EXCLUSIVEmémoire. N'utilisez cette dernière que si la récupération d'espace disque justifie l'interruption de service prévue.
Comment savoir si le changement a réellement fonctionné ?
Vérifiez le résultat avec le même type de charge de travail que celle à l'origine du problème. Une solution efficace ne se résume pas à une simple réduction immédiate de la consommation de RAM par Postgres. Les caches de base de données sont conçus pour utiliser de la mémoire. Il convient plutôt de vérifier la stabilité de la mémoire disponible, l'absence ou la faible augmentation inattendue de la mémoire d'échange, l'absence d'erreurs de mémoire insuffisante (OOM), un nombre de connexions correspondant à la concurrence attendue et des temps de réponse acceptables pour Synapse.
- Exécutez
free -hla liste des processus au même niveau de trafic que celui utilisé pour votre référence.
- Répétez la
pg_stat_activityrequête de connexion et vérifiez que le nombre de serveurs backend inactifs a diminué si vous avez modifié le pool Synapse.
- Surveillez la latence des requêtes et de la synchronisation après la réduction
cp_max ; annulez la modification si les temps d’attente de la base de données augmentent sensiblement.
- Vérifiez
pg_stat_user_tablesrégulièrement que l'aspirateur automatique passe bien les tables occupées.
- Si vous avez abaissé cette valeur
work_mem, vérifiez si les fichiers volumineux débordent maintenant excessivement vers les fichiers temporaires avant de la réduire davantage.
Si la charge de PostgreSQL continue d'augmenter jusqu'à ce que l'hôte soit fortement sollicité par le swap après ces vérifications, capturez la liste des requêtes actives pendant le pic et analysez la charge de travail plutôt que de réduire sans cesse les limites de mémoire globales. Sur les versions de PostgreSQL prises en charge, pg_backend_memory_contextsvous pouvez examiner les contextes mémoire du backend actuel ; la documentation de la vue système PostgreSQL décrit cette vue et ses permissions. Cette approche est plus pertinente pour une analyse ciblée de la base de données que de supposer que tous les déploiements Synapse à forte consommation de mémoire ont la même cause.
En résumé
Pour Matrix Synapse sur PostgreSQL, la gestion d'une utilisation élevée de la mémoire de la base de données se fait de manière plus sûre par étapes : vérifier que l'hôte est réellement soumis à une forte pression sur la mémoire, comptabiliser les sessions de base de données, dimensionner correctement le pool de Synapse, limiter la mémoire allouée par opération à PostgreSQL et s'assurer du bon fonctionnement de l'autovacuum. L'objectif n'est pas de minimiser l'empreinte mémoire de PostgreSQL, mais d'obtenir une utilisation prévisible de la mémoire sans que la mise en cache et la concurrence normales de la base de données ne génèrent des échanges mémoire inutiles, des erreurs de type « mémoire insuffisante » ou des ralentissements des clients Matrix.









