Jak naprawić problem braku pamięci w Matrix Synapse podczas synchronizacji
Najnowsza stabilna wersja Matrix Synapse z 6 października 2026 roku to 1.162.0, opublikowana 29 września 2026 roku. Jeśli na serwerze domowym brakuje pamięci podczas synchronizacji klienta, warto najpierw sprawdzić aktualną, obsługiwaną wersję, ale zazwyczaj działa trwałe rozwiązanie, a nie pojedyncze, magiczne ustawienie. Synapse celowo przechowuje w pamięci ostatnie dane i metadane dotyczące pomieszczeń, aby przyspieszyć obsługę typowych żądań. Oficjalna dokumentacja administratora ostrzega, że zbyt agresywne zmniejszanie pamięci podręcznej może w rzeczywistości zwiększyć obciążenie pamięci, tworząc zaległości w postaci powolnych żądań.
Ten przewodnik przedstawia ścieżkę, którą nowy administrator może bezpiecznie obrać: zrozumieć znaczenie słowa „synchronizacja”, potwierdzić, czy proces rzeczywiście osiąga limit pamięci, zmniejszyć niepotrzebne obciążenie pamięci podręcznej, w razie potrzeby oddzielić nietypowo duży ruch synchronizacji początkowej oraz monitorować wynik. Celem nie jest jedynie zmniejszenie rozmiaru zestawu rezydentnego. Celem jest zapobieganie awariom z powodu braku pamięci przy jednoczesnym zachowaniu responsywności serwera domowego.
Co oznacza „synchronizacja” w Matrix Synapse
Klient Matrix wielokrotnie wywołuje API klient-serwer /_matrix/client/v3/sync, aby odbierać nowe zdarzenia, takie jak wiadomości, stan pokoju, dane konta, informacje o obecności i aktualizacje urządzenia. Standardowa synchronizacja zazwyczaj obejmuje sincetoken, więc Synapse musi zwrócić zmiany tylko po poprzednim punkcie synchronizacji.
Synchronizacja początkowa jest inna. Jest to pierwsza synchronizacja urządzenia lub sesji i nie posiada poprzedniego sincetokena. Oficjalna dokumentacja serwera Synapse opisuje te żądania jako potencjalnie bardzo zasobochłonne. Na większych serwerach domowych Synapse obsługuje routing synchronizacji początkowej oddzielnie od bieżącej synchronizacji, dzięki czemu kilka kosztownych synchronizacji za pierwszym razem nie zakłóca pracy pozostałych.
Wykonaj kopię zapasową homeserver.yamlplików konfiguracji pracownika, konfiguracji odwrotnego serwera proxy i bazy danych PostgreSQL zgodnie ze standardową procedurą tworzenia kopii zapasowych.
Zwróć uwagę, czy Synapse działa jako jeden proces, w kontenerach czy jako proces główny i procesy robocze.
Znajdź rzeczywisty limit pamięci. Kontener, jednostka systemd, kontener Kubernetes lub maszyna wirtualna mogą mieć niższy limit niż serwer fizyczny.
Sprawdź, czy PostgreSQL jest używany w środowisku produkcyjnym. Aktualna dokumentacja instalacyjna Synapse podaje, że SQLite jest przeznaczony do testowania i słabo sprawdza się w przypadku obciążeń produkcyjnych, szczególnie w dużych pomieszczeniach.
Krok 1: Sprawdź, czy przyczyną awarii jest wyczerpanie pamięci
Nie zaczynaj od zmiany wartości pamięci podręcznej. Najpierw zidentyfikuj, który proces Synapse zużywa pamięć i czy jest on zamykany przez system operacyjny, czy przez limit kontenera.
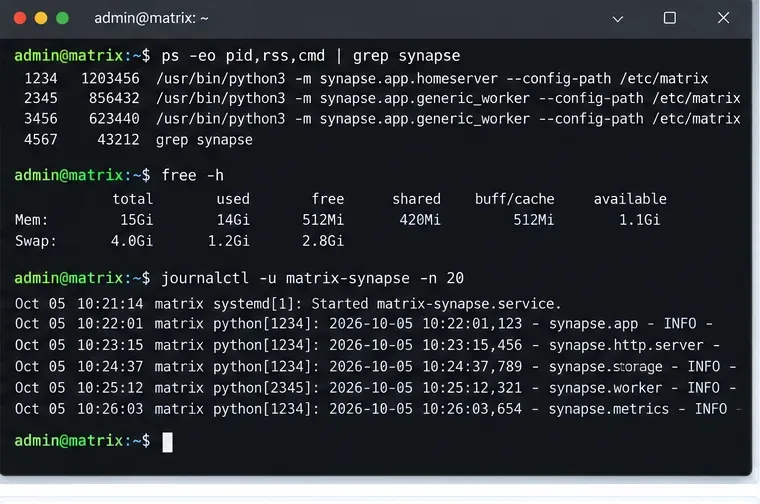
Zacznij od sprawdzenia RSS procesu, dostępnej pamięci, obciążenia pamięci wymiany i ostatnich logów usługi Synapse, aby dowiedzieć się, czy problem wynika faktycznie z wyczerpania pamięci czy z innego błędu synchronizacji.
Na hoście Linux polecenia takie jak poniższe umożliwiają szybki podgląd pierwszego kroku:
Jeśli używasz Dockera, Podmana, Kubernetesa lub innego harmonogramu, sprawdź również limit pamięci kontenera lub kontenera. Host z kilkoma gigabajtami wolnej pamięci nadal może wyłączyć Synapse, jeśli proces jest ograniczony do znacznie mniejszego limitu cgroup.
Poszukaj powtarzalnego wzorca. Czy pamięć rośnie tylko wtedy, gdy konkretny użytkownik loguje się na nowym urządzeniu? Czy rośnie stopniowo przez cały dzień? Czy jeden ogólny proces roboczy rośnie, podczas gdy główny proces pozostaje stabilny? Te obserwacje pozwalają odróżnić skokowe zmiany w początkowej synchronizacji od ogólnego wzrostu pamięci podręcznej lub zaległości w żądaniach.
Krok 2: Sprawdź ustawienia pamięci podręcznej przed ich obniżeniem
Pamięć podręczna to dane, które Synapse przechowuje w pamięci RAM, dzięki czemu nie musi wielokrotnie przeliczać ani ładować tych samych informacji. Synapse posiada wiele pamięci podręcznych, a także pamięć podręczną zdarzeń. Dokumentacja konfiguracji dokumentuje obecnie domyślną wartość caches.global_factor0,5, event_cache_sizedomyślną wartość 10 KB przed zastosowaniem współczynnika globalnego, wygaśnięcie pamięci podręcznej w oparciu o czas oraz sync_response_cache_durationdomyślną wartość 2 minut.
Kuszącym rozwiązaniem jest ustawienie współczynnika globalnego na jak najniższym poziomie. Nie rób tego bezmyślnie. W FAQ administratora Synapse wyraźnie ostrzega się, że zbyt mała pamięć podręczna może jeszcze bardziej spowolnić powolny system, co doprowadzi do kumulacji żądań i gwałtownego wzrostu zużycia pamięci z powodu zaległości, a nie wpisów w pamięci podręcznej.
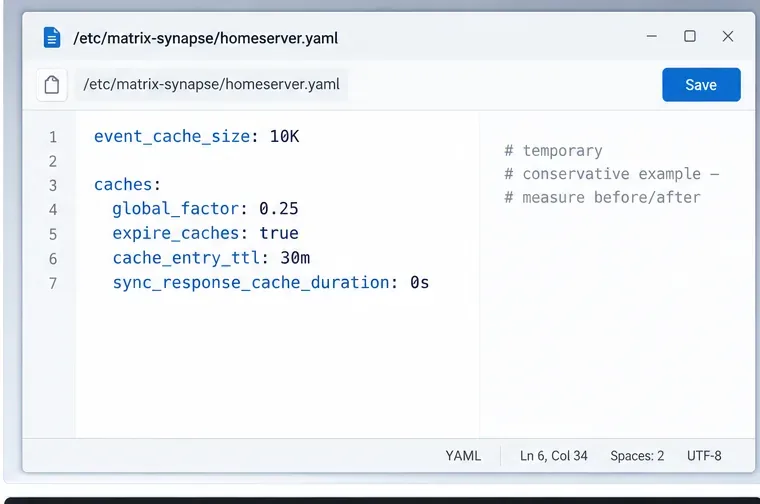
Wprowadzaj zmiany w pamięci podręcznej ostrożnie i mierz rezultaty; przykład ilustruje, gdzie znajdują się odpowiednie ustawienia, a nie uniwersalną wartość produkcyjną.
Jeśli profilowanie wykaże, że pamięć podręczna jest rzeczywiście dominującym konsumentem, a przepustowość żądań pozostaje na stabilnym poziomie, spróbuj zmniejszyć ją nieznacznie, a nie drastycznie. Na przykład:
To przykład rozwiązywania problemów, a nie zalecana wartość dla każdego serwera. Ustawienie sync_response_cache_durationwartości zero wyłącza buforowanie ukończonych /syncodpowiedzi. Może to zaoszczędzić pamięć, gdy przechowywanych jest wiele odpowiedzi synchronizacji, ale może spowodować, że ponowne łączenie się klientów będzie wymagało więcej pracy. Przetestuj to przy rzeczywistym obciążeniu.
Synapse oferuje również automatyczne dostrajanie pamięci podręcznej za pomocą max_cache_memory_usage, target_cache_memory_usage, i min_cache_ttl. Oficjalna dokumentacja podaje, że ta funkcja wymaga jemalloc , alternatywnego alokatora pamięci, i wszystkie trzy ustawienia muszą być podane. Nie należy włączać tylko jednej lub dwóch wartości; dokumentacja ostrzega, że niepełna konfiguracja może powodować niestabilne działanie.
Krok 3: Upewnij się, że baza danych nie tworzy zaległości w żądaniach
Problemy z pamięcią podczas synchronizacji nie zawsze wynikają z ilości danych w pamięci podręcznej. Wolna baza danych może obsługiwać wiele żądań jednocześnie, a każde żądanie w trakcie realizacji zużywa pamięć. Dlatego zmniejszenie rozmiaru pamięci podręcznej może przynieść odwrotny skutek w przypadku i tak już powolnej pamięci masowej.
W środowisku produkcyjnym należy postępować zgodnie z oficjalnym przewodnikiem Synapse PostgreSQL . Sprawdź obciążenie procesora bazy danych, opóźnienie pamięci masowej, nasycenie połączenia, długotrwałe zapytania oraz to, czy sam serwer PostgreSQL wykonuje wymianę. Jeśli opóźnienie synchronizacji rośnie w tym samym czasie, co pamięć rezydentna, sprawdź zaległości przed ponownym zmniejszeniem pamięci podręcznej.
Jeśli niedawno przeniosłeś się do dużych pokoi publicznych, zjednoczyłeś się w znacznie większych społecznościach lub dodałeś wielu aktywnych użytkowników, obciążenie mogło po prostu przekroczyć konfigurację, która wcześniej działała. W takim przypadku dostrojenie bazy danych i izolacja pracowników często mają większe znaczenie niż niewielkie zmniejszenie pamięci podręcznej.
Krok 4: Izolowanie początkowej synchronizacji na większych serwerach domowych
Synapse może działać jako pojedynczy monolit , co oznacza jeden główny proces serwera domowego, lub może dzielić pracę na procesy robocze , czyli dodatkowe procesy Synapse współdzielące tę samą bazę danych PostgreSQL. Model roboczy jest przeznaczony dla większych instalacji, które wymagają niezależnego skalowania poszczególnych obciążeń.
W przypadku większych wdrożeń opartych na bazie danych PostgreSQL należy oddzielnie kierować kosztowną synchronizację początkową od bieżącej synchronizacji, aby pierwsze logowanie nie zużywało tej samej puli zasobów roboczych, co normalne aktualizacje klienta.
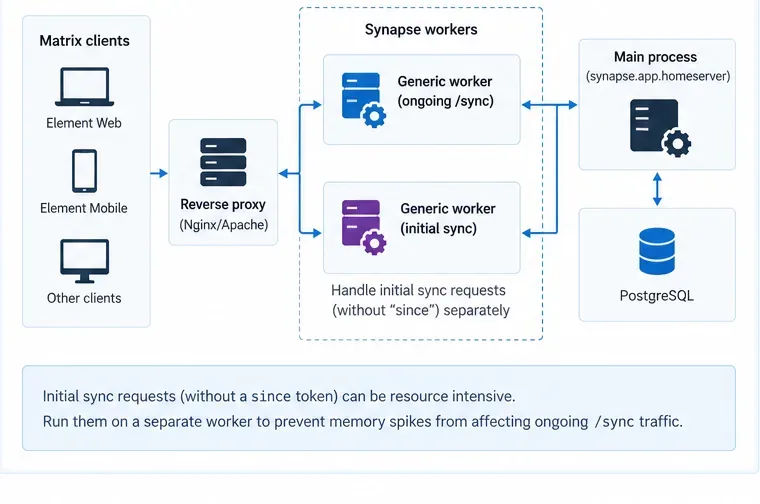
Dokumentacja pracownika stwierdza, że ogólny pracownik może obsługiwać /synci /initialSync. Zaleca również rozważenie oddzielnej obsługi żądań synchronizacji bez sinceparametrów, ponieważ te żądania synchronizacji początkowej mogą być bardzo zasobochłonne.
Praktyczna architektura to:
Serwer proxy odwrotny odbiera ruch klienta Matrix.
Bieżące /syncżądania trafiają do jednego lub większej liczby pracowników ogólnych.
Początkowe żądania synchronizacji są kierowane do osobnej grupy pracowników ogólnych.
Główny proces kontynuuje obsługę obowiązków, które nie zostały delegowane.
Wszystkie procesy Synapse współdzielą bazę danych PostgreSQL.
Nie udostępniaj nasłuchiwacza replikacji Synapse w publicznym Internecie. Aktualna dokumentacja procesu roboczego ostrzega, że ruch replikacji jest nieszyfrowany i nieuwierzytelniany, chyba że skonfigurowano tajny klucz replikacji.
Pracownicy nie są właściwym pierwszym krokiem w przypadku małego serwera domowego. Wytyczne Synapse zalecają tryb monolityczny dla mniejszych instancji. Dodaj pracowników, gdy masz dowody na to, że dane obciążenie wymaga izolacji lub skalowania poziomego.
Krok 5: Bezpiecznie przeładuj czynniki pamięci podręcznej i obserwuj wynik
Synapse umożliwia ponowne załadowanie współczynników pamięci podręcznej za pomocą SIGHUP. Referencja konfiguracji podaje następujący przykład:
kill -HUP PID_OF_SYNAPSE_PROCESS
Jeśli usługa systemd w pakiecie to obsługuje, systemctl reload matrix-synapsemożna wykonać tę samą operację. W przypadku wdrożenia z wykorzystaniem procesu roboczego, oficjalna dokumentacja mówi, że odpowiednia konfiguracja procesu roboczego musi zostać zaktualizowana, a każdy proces roboczy musi indywidualnie odebrać sygnał przeładowania.
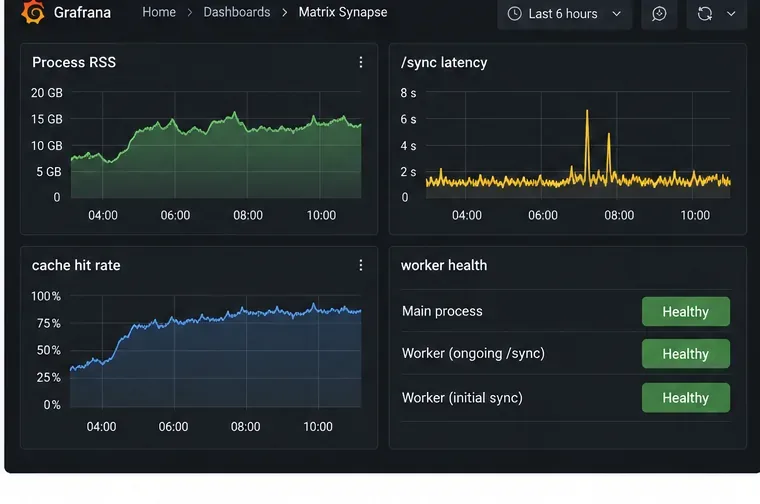
Po każdej zmianie należy dać serwerowi wystarczająco dużo czasu na osiągnięcie normalnego wzorca ruchu. Należy monitorować pamięć rezydentną, opóźnienie żądań, obciążenie bazy danych i kondycję aktywnych procesów roboczych. Spadek wykresu pamięci podczas podwojenia opóźnienia synchronizacji nie jest rozwiązaniem problemu.
Krok 6: Włącz metryki Prometheusa w celu powtarzalnej diagnostyki
W przypadku zdarzeń wykraczających poza jednorazowy incydent, włącz metryki Synapse i zbieraj je za pomocą Prometheusa. Oficjalne dokumenty dotyczące monitorowania enable_metrics: trueoraz dedykowany wewnętrzny nasłuchiwacz metryk. Zachowaj punkt końcowy metryk na wewnętrznym interfejsie lub chroń go na odwrotnym serwerze proxy; nie powinien być niepotrzebnie ujawniany.
Śledź jednocześnie opóźnienie pamięci i synchronizacji. Efektywnym rezultatem jest stabilna pamięć z akceptowalnym czasem reakcji, a nie najmniejsza możliwa wartość RSS.
Skorzystaj z oficjalnego przewodnika monitorowania Synapse Prometheus , aby zapoznać się z aktualną składnią programu nasłuchującego. W przypadku wdrożeń procesów roboczych monitoruj każdy proces osobno, ponieważ metryki procesów roboczych nie są automatycznie agregowane w procesie głównym.
Typowe błędy, których należy unikać
Obniżanie parametru SYNAPSE_CACHE_FACTOR do momentu spowolnienia serwera
Mniejsza pamięć podręczna zużywa mniej pamięci na wpis, ale zwiększa obciążenie bazy danych i obliczeń. Jeśli ta dodatkowa praca stworzy kolejkę niedokończonych żądań, całkowita ilość pamięci może wzrosnąć, a nie spaść. Zmniejszaj współczynnik małymi krokami i zawsze obserwuj opóźnienie.
Zakładając, że każde żądanie /sync kosztuje tyle samo
Trwająca synchronizacja z sincetokenem i początkowa synchronizacja bez tokena mają zupełnie inne profile zasobów. Rozdziel je w diagnostyce przed skalowaniem całego serwera.
Korzystanie z pracowników w środowisku SQLite
Pracownicy Synapse współdzielą bazę danych PostgreSQL. W dokumentacji pracowników podano, że SQLite jest przeznaczony do użytku demonstracyjnego lub testowego i nie stanowi podstawy do wdrożenia produkcyjnego opartego na pracownikach.
Użycie swapu jako głównego rozwiązania
Niewielka ilość swapu może zapobiec nagłemu zamknięciu procesu, ale intensywne swapowanie znacznie spowalnia synchronizację i może prowadzić do powstania tej samej pętli sprzężenia zwrotnego w zaległych procesach. Traktuj swap jako zabezpieczenie przed krótkotrwałym skokiem obciążenia, a nie jako planowanie wydajności.
Zmiana kilku ustawień pamięci jednocześnie
Jeśli jednocześnie zmniejszysz pamięć podręczną, zmienisz routing procesów roboczych, zmodyfikujesz ustawienia PostgreSQL i zwiększysz limit kontenerów, nie będziesz wiedzieć, która zmiana rozwiązała problem. Wprowadzaj jedną kontrolowaną zmianę na raz i porównuj te same metryki.
Praktyczna ścieżka decyzyjna
Co obserwujesz
Prawdopodobna następna akcja
Skoki pamięci, gdy użytkownicy logują się na nowych urządzeniach
Zidentyfikuj początkową synchronizację i rozważ jej wyizolowanie na serwerze roboczym w przypadku większych wdrożeń.
Pamięć stale rośnie, a wskaźnik trafień w pamięć podręczną jest wysoki, a opóźnienie jest normalne
Zmniejsz pojemność pamięci podręcznej w sposób konserwatywny i przetestuj ponownie.
Opóźnienie pamięci i synchronizacji rośnie razem
Przed dalszym zmniejszaniem pamięci podręcznej sprawdź zaległości w bazie danych lub pamięci masowej.
Tylko jeden pracownik osiąga swój limit
Dostosuj budżet pamięci danego pracownika lub skaluj grupę pracowników, a nie cały serwer domowy.
Host ma wolną pamięć RAM, ale Synapse jest wyłączany
Sprawdź limity pamięci kontenera, cgroup, systemd lub Kubernetes.
Ostateczna lista kontrolna
Uruchom aktualną wersję Synapse; wersja 1.162.0 jest najnowszą stabilną wersją z dnia 6 października 2026 r.
Użyj PostgreSQL w środowisku produkcyjnym.
Sprawdź, który proces faktycznie zużywa dane RSS i jaki limit pamięci go dotyczy.
Rozróżnij zwykłą synchronizację przyrostową od synchronizacji początkowej.
Utrzymuj włączoną funkcję wygasania pamięci podręcznej i stopniowo dostosowuj współczynniki pamięci podręcznej.
Nie włączaj automatycznego dostrajania pamięci podręcznej, jeśli nie używasz polecenia jemalloc i nie skonfigurowano wszystkich wymaganych wartości.
W przypadku większych wdrożeń należy wyizolować synchronizację początkową lub dodać ogólne zadania synchronizacji, jeśli pomiary to uzasadniają.
Monitoruj pamięć i opóźnienia po każdej zmianie.
Synapse celowo zużywa dużo pamięci, ponieważ buforowanie jest częścią jego strategii wydajnościowej. Prawidłowym rozwiązaniem problemów z brakiem pamięci (OOM) związanych z synchronizacją jest zatem znalezienie równowagi: usunięcie zbędnego retencji pamięci podręcznej, wyeliminowanie zaległości w bazie danych lub żądaniach oraz izolowanie wyjątkowych obciążeń bez ograniczania zasobów pamięci podręcznej, która zapewnia szybką normalną synchronizację. Takie podejście jest bardziej niezawodne niż traktowanie najwyższego numeru RSS jako problemu samego w sobie.