Jak skonfigurować obiektową pamięć masową S3 dla usługi ownCloud Infinite Scale
Usługa ownCloud Infinite Scale może korzystać z pamięci masowej obiektów zgodnej ze standardem S3 dla obiektów blob, jednocześnie przechowując metadane plików w systemie plików zgodnym z POSIX. Ten podział to pierwsza koncepcja, którą należy zrozumieć: S3 nie zastępuje natychmiast każdego lokalnego katalogu danych. W obsługiwanym s3ngukładzie pamięć masowa obiektów przechowuje binarną zawartość plików, podczas gdy metadane pozostają w pamięci masowej POSIX, takiej jak lokalny system plików lub NFS.
Niniejszy przewodnik jest zgodny z aktualną dokumentacją dotyczącą pamięci masowej ownCloud Infinite Scale, która będzie dostępna w październiku 2026 r. Jest on przeznaczony dla administratorów, którzy dopiero zaczynają korzystać ze s3ngsterownika i chcą zrozumieć konfigurację, zanim dostosują ją do Docker Compose, systemd, Kubernetes lub innej metody wdrażania.
S3 to interfejs API do przechowywania obiektów, pierwotnie wprowadzony przez firmę Amazon. Usługa zgodna z S3 przechowuje dane jako obiekty w kontenerze i udostępnia operacje za pośrednictwem interfejsów API opartych na protokole HTTP. Usługa ownCloud Infinite Scale wykorzystuje s3ngsterownik pamięci masowej do umieszczania obiektów blob w takim kontenerze.
Pamięć masowa POSIX oznacza system plików, który zapewnia zachowanie systemu plików, jakiego Infinite Scale oczekuje dla metadanych. W przypadku s3ng, metadane nie są przenoszone do kontenera S3. ownCloud wyraźnie dokumentuje, że obiekty blob trafiają do S3, a metadane pozostają w pamięci masowej POSIX.
To rozróżnienie zapobiega częstemu błędowi: skierowaniu Infinite Scale na kontener i założeniu, że cały stan serwera znajduje się właśnie tam. Tak nie jest. Twój plan tworzenia kopii zapasowych i odzyskiwania musi obejmować zarówno metadane po stronie POSIX, jak i bloby po stronie S3.
Krok 1: Przygotuj kontener, magazyn metadanych, dane uwierzytelniające i ścieżkę sieciową
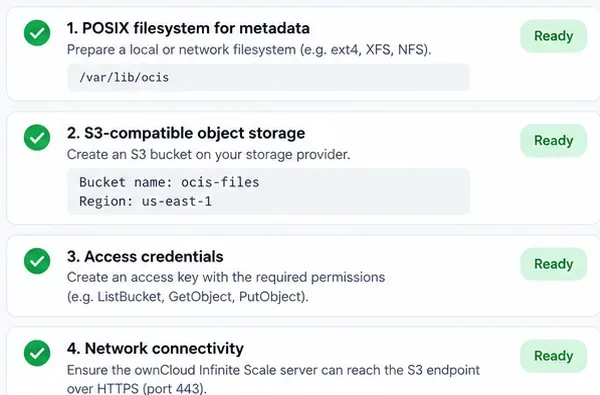
Przed wprowadzeniem zmian w Infinite Scale przygotuj cztery rzeczy:
Dedykowany kontener S3.
Zgodna ze standardem POSIX ścieżka s3ngmetadanych. W przypadku wdrożenia wielowęzłowego ownCloud zaleca staranne przemyślenie kwestii współdzielonej pamięci masowej; NFS jest powszechnie używany, gdy wiele instancji Infinite Scale potrzebuje dostępu do ścieżki metadanych.
Klucz dostępu i klucz tajny zawierające tylko uprawnienia do kontenera wymagane przez Infinite Scale.
Dostępność sieciowa z hosta lub kontenera Infinite Scale do punktu końcowego S3, zwykle przez protokół HTTPS.
Przed edycją konfiguracji Infinite Scale przygotuj ścieżkę metadanych POSIX, kontener S3, dane uwierzytelniające i łączność sieciową.
Nie upubliczniaj kontenera. Infinite Scale uwierzytelnia się do kontenera za pomocą poświadczeń; publiczny dostęp nie jest ani wymagany, ani pożądany. Unikaj również ponownego używania ogólnych poświadczeń administratora, gdy możliwe jest utworzenie dedykowanej tożsamości usługi.
Jeśli korzystasz z Amazon S3, punkt końcowy i region są zgodne z konwencjami AWS. Jeśli korzystasz z innego dostawcy zgodnego z S3, sprawdź format jego punktu końcowego, zachowanie regionu, wymagania TLS i składnię zasad w dokumentacji tego dostawcy. OwnCloud wyraźnie ostrzega, że takie zachowania, jak szczegóły szyfrowania, mogą się różnić w zależności od dostawcy.
Krok 2: Włącz sterownik s3ng i podaj ustawienia połączenia S3
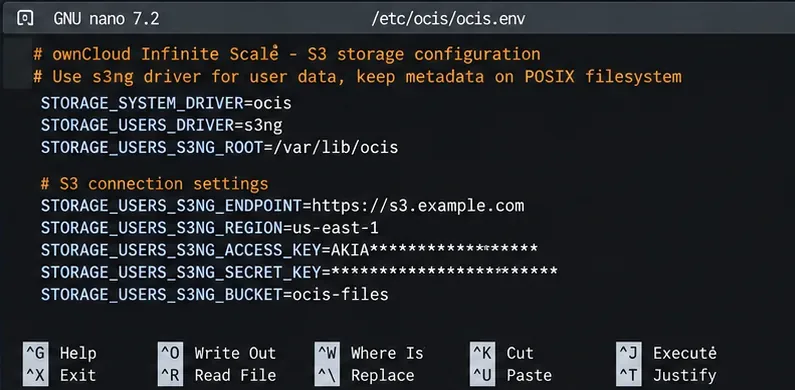
Główne ustawienie pamięci masowej to STORAGE_USERS_DRIVER=s3ng. Usługa Storage-Users to komponent Infinite Scale odpowiedzialny za przechowywanie plików użytkownika. Oficjalna konfiguracja utrzymuje również sterownik pamięci masowej systemu w standardowym ociszapleczu.
Podstawowe zmienne środowiskowe s3ng łączą usługę Storage-Users z S3, jednocześnie zachowując metadane w magazynie POSIX.
Przykładowe wartości to symbole zastępcze. Użyj punktu końcowego, regionu, kontenera i danych uwierzytelniających wydanych przez dostawcę. Nie zatwierdzaj klucza tajnego w publicznym repozytorium Git. W przypadku orkiestracji kontenerów preferuj mechanizm zarządzania kluczami tajnymi platformy zamiast osadzać dane uwierzytelniające bezpośrednio w pliku Compose lub manifeście.
Metoda wdrożenia określa, gdzie te zmienne mają się znaleźć. Wdrożenie Docker Compose może umieścić je w environmentsekcji usługi Infinite Scale lub załadować z pliku środowiska. Wdrożenie systemd może korzystać z pliku środowiska lub konfiguracji jednostki. Kubernetes zazwyczaj wstrzykuje je za pomocą obiektu Secret and Deployment lub StatefulSet. Nazwy zmiennych są istotną częścią; składnia ich składni zależy od platformy.
Krok 3: Udziel uprawnień kontenerowi, których potrzebuje Infinite Scale
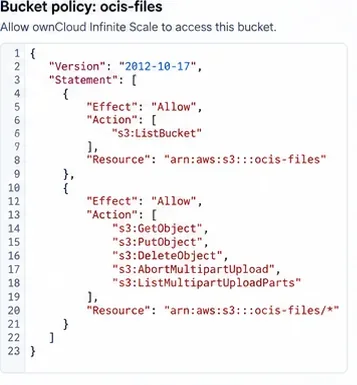
Polityka kontenera to reguła zarządzania tożsamościami i dostępem (IAM), która kontroluje, jakie działania uwierzytelniona tożsamość może wykonać względem kontenera i jego obiektów. ownCloud publikuje wymagany wzorzec polityki dla sterownika s3ng.
bucket-nameW poniższej polityce zastąp swoją prawdziwą nazwą kontenera:
Struktura polityki musi umożliwiać tworzenie listy kontenerów oraz wykonywanie operacji przesyłania obiektów i multipart-upload wymaganych przez sterownik s3ng. Użyj dokładnej polityki z oficjalnej dokumentacji dla swojego wdrożenia.
Nie rozwiązuj błędu odmowy dostępu, przyznając s3:*uprawnienia do każdego kontenera na koncie. Zacznij od udokumentowanych uprawnień o zakresie kontenera, a następnie dostosuj je tylko wtedy, gdy dostawca S3 będzie wymagał odpowiednika specyficznego dla dostawcy.
Krok 4: Uruchom ponownie Infinite Scale i sprawdź ścieżkę pamięci masowej
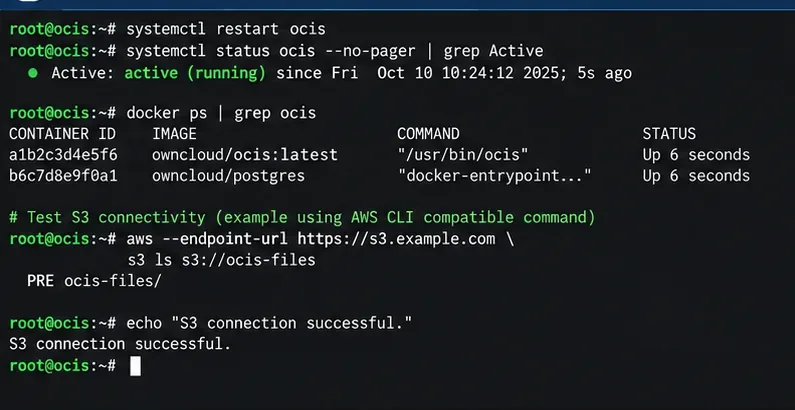
Zastosuj konfigurację, wykonując standardową procedurę ponownego uruchomienia dla wdrożenia. Na przykład instalacja systemd może używać systemctl restart ocis, podczas gdy wdrożenie Compose spowoduje ponowne utworzenie lub ponowne uruchomienie kontenerów usług, których to dotyczy. Sprawdź logi natychmiast po uruchomieniu pod kątem błędów uwierzytelniania, DNS, TLS, regionu lub uprawnień.
Po zastosowaniu konfiguracji uruchom ponownie odpowiednie usługi Infinite Scale i sprawdź, czy host może nawiązać połączenie z docelowym kontenerem i uwierzytelnić się w nim.
Lista kontenerów w interfejsie wiersza poleceń dostawcy S3 dowodzi, że host i dane uwierzytelniające mogą dotrzeć do kontenera, ale sama w sobie nie dowodzi, że Infinite Scale poprawnie zapisuje bloby. Lepszym kompleksowym testem jest uruchomienie Infinite Scale, przesłanie niewielkiego pliku przez interfejs internetowy ownCloud, ponowne pobranie go i sprawdzenie logów usługi pod kątem błędów.
Jeśli zainstalowana wersja Infinite Scale zawiera polecenie konserwacji magazynu blobów udokumentowane przez ownCloud, możesz również użyć polecenia ocis storage-users blobstore check. ownCloud opisuje to polecenie jako dwukierunkową transmisję danych do skonfigurowanego magazynu blobów. Sprawdź oficjalną dokumentację weryfikacji magazynu blobów, aby poznać składnię specyficzną dla danej wersji.
Nie należy oczekiwać, że oryginalne nazwy plików będą wyświetlane jako normalne obiekty S3
Jednym z najczęstszych nieporozumień jest przeglądanie kontenera i oczekiwanie znanego drzewa folderów użytkownika, takiego jak Documents/report.pdf. Infinite Scale traktuje S3 jako magazyn obiektów blob, a nie jako system plików widoczny dla użytkownika. Udokumentowany s3ngformat klucza opiera się na identyfikatorach przestrzeni i identyfikatorach obiektów blob, podczas gdy czytelna dla człowieka przestrzeń nazw jest rekonstruowana z metadanych.
Oznacza to, że nie należy ręcznie zmieniać nazw, reorganizować ani usuwać obiektów w kontenerze tylko dlatego, że ich klucze wyglądają nieznajomo. Zarządzaj plikami użytkowników za pośrednictwem ownCloud. Bezpośrednia manipulacja kontenerem może zerwać relację między metadanymi a obiektami typu blob.
Duże pliki do przesłania: sprawdź rozmiar części wieloczęściowej przed produkcją
S3 wykorzystuje przesyłanie wieloczęściowe do dzielenia dużych obiektów na części. Dokumenty ownCloud STORAGE_USERS_S3NG_PUT_OBJECT_PART_SIZEsłużą do kontrolowania rozmiaru części. Udokumentowana wartość domyślna to 16 MiB, jeśli nie podano konkretnej wartości.
Amazon S3 pozwala na przesłanie maksymalnie 10 000 części w ramach jednego przesyłania wieloczęściowego. Przy rozmiarze części 16 MiB, odpowiada to około 160 GiB, zanim limit liczby części stanie się problemem. Jeśli Twoi użytkownicy regularnie przesyłają większe pliki, oblicz wymagany rozmiar części przed uruchomieniem, zamiast czekać na niepowodzenie dużego transferu.
Kompromis jest prosty: większe części obsługują większe pliki maksymalne przy mniejszej liczbie żądań, ale zmieniają również charakterystykę pamięci, buforowania, ponawiania prób i transferu. ownCloud zauważa również, że przychodzące dane plików wymagają tymczasowego miejsca do przechowywania podczas buforowania, więc planowanie pojemności musi obejmować więcej niż tylko zdalny kontener.
Typowe problemy i co należy sprawdzić w pierwszej kolejności
Objaw
Prawdopodobny obszar
Pierwsza kontrola
Odmowa dostępu
Poświadczenia lub polityka dotycząca wiaderek
Potwierdź klucz dostępu, klucz tajny, numer ARN kontenera i wymagane działania.
Nie znaleziono wiadra
Nazwa kontenera, punkt końcowy lub region
Sprawdź dokładną nazwę kontenera i kombinację punktu końcowego/regionu specyficznego dla dostawcy.
Błąd TLS lub certyfikatu
Zaufanie HTTPS
Sprawdź, czy certyfikat punktu końcowego jest ważny i zaufany w hoście/kontenerze Infinite Scale.
Małe pliki działają, ale bardzo duże nie
Rozmiarowanie wieloczęściowe
Sprawdź STORAGE_USERS_S3NG_PUT_OBJECT_PART_SIZElimity wieloczęściowe swojego dostawcy.
Pliki znikają po przywróceniu tylko S3
Niekompletna kopia zapasowa
Przywróć metadane POSIX i bloby S3 jako jeden spójny zestaw danych.
Twórz kopie zapasowe obiektów blob S3 i metadanych POSIX razem
W przypadku s3ngwiadra, kontener stanowi tylko połowę stanu pamięci masowej. Dokumentacja kopii zapasowych ownCloud mówi, że rozproszona konfiguracja S3 musi obejmować konfigurację, dane systemowe, metadane i obiekty blob. Dokumentacja przywracania danych również wymaga spójnego przywracania tych zestawów danych.
W przypadku usługi produkcyjnej należy udokumentować montowanie metadanych, kontener, dane uwierzytelniające lub rolę, pliki konfiguracyjne oraz procedurę tworzenia kopii zapasowej w tym samym runbooku. Przetestuj odzyskiwanie przed wykorzystaniem projektu. Odpowiednie oficjalne źródła to przewodnik po tworzeniu kopii zapasowych i rozważania dotyczące przywracania w chmurze ownCloud .
Zalecany punkt wyjścia
W przypadku pierwszego wdrożenia należy zachować prostotę projektu: użyj jednego dedykowanego kontenera S3 dla obiektów blob, jednej trwałej ścieżki metadanych POSIX, dedykowanej tożsamości usługi z udokumentowanymi uprawnieniami kontenera, protokołu HTTPS do punktu końcowego pamięci masowej obiektów oraz domyślnych ustawień multipart, chyba że oczekiwane rozmiary plików wymagają zmiany.
Po konfiguracji należy oddzielnie zweryfikować trzy warstwy: dostęp do sieci i poświadczeń do kontenera, uruchomienie Infinite Scale bez błędów pamięci masowej oraz faktyczne przesyłanie/pobieranie przez ownCloud. Po pomyślnym zakończeniu tych kontroli należy przejść do monitorowania, tworzenia kopii zapasowych, reguł cyklu życia i dostrajania wydajności. Taka kolejność znacznie ułatwia rozwiązywanie problemów, ponieważ każdy test odpowiada na inne pytanie, zamiast traktować „S3 działa” jako pojedynczy wynik typu „wszystko albo nic”.