Integracja Nextcloud z Elasticsearch jest nadal aktywna w 2026 roku, ale przed rozpoczęciem warto sprawdzić jeden szczegół dotyczący zgodności: obecna aplikacja platformy wyszukiwania pełnotekstowego Elasticsearch obsługuje Elasticsearch 8, a nie Elasticsearch 9. Oficjalne repozytorium projektu podaje, że wersje 26.0.0 i nowsze są zgodne tylko z Elasticsearch 8. Ponadto Nextcloud 35 ma teraz zgodną wersję platformy Elasticsearch 35.0.0, opublikowaną 18 września 2026 roku. Jeśli aktualizujesz istniejący serwer, sprawdź wersję aplikacji zgodną z główną wersją Nextcloud, zanim dotkniesz indeksu wyszukiwania.
Ten przewodnik przedstawia praktyczną konfigurację indeksowania zawartości plików w NextCloud z Elasticsearch 8. Koncentruje się na standardowym stosie trzech aplikacji: frameworku wyszukiwania pełnotekstowego, konektorze platformy Elasticsearch oraz dostawcy plików. Polecenia korzystają z occinterfejsu wiersza poleceń NextCloud, ponieważ łatwiej jest walidować i automatyzować niż polegać wyłącznie na interfejsie internetowym.
Oficjalne odniesienia: aplikacja platformy Nextcloud Full text search - Elasticsearch , repozytorium platformy Nextcloud Elasticsearch , struktura wyszukiwania pełnotekstowego Nextcloud , dostawca wyszukiwania pełnotekstowego Nextcloud Files oraz podręcznik instalacji Dockera jednowęzłowego Elastic .
Co tak naprawdę zawiera stos wyszukiwania pełnotekstowego Nextcloud
Wyszukiwanie pełnotekstowe w NextCloud to nie pojedyncza aplikacja. Podstawowa aplikacja wyszukiwania pełnotekstowego zapewnia odpowiednie ramy. Aplikacja platformy łączy tę ramę z wyszukiwarką, a jedna lub więcej aplikacji dostawcy wyodrębnia wyszukiwalną treść. W przypadku treści plików dostawcą jest Wyszukiwanie pełnotekstowe – Pliki. Elasticsearch przechowuje wynikowy indeks i odpowiada na zapytania.
- Wyszukiwanie pełnotekstowe: podstawowe ramy i warstwa koordynacji wyszukiwania.
- Wyszukiwanie pełnotekstowe — platforma Elasticsearch: łącznik, który wysyła dokumenty i zapytania do Elasticsearch.
- Wyszukiwanie pełnotekstowe — Pliki: dostawca udostępniający pliki użytkowników platformie w celu indeksowania.
- Elasticsearch 8: zewnętrzna wyszukiwarka przechowująca indeks.
Separacja ma znaczenie podczas rozwiązywania problemów. Działający punkt końcowy HTTP Elasticsearch nie dowodzi, że Nextcloud może wyodrębnić zawartość pliku, a włączony dostawca plików nie dowodzi, że konektor platformy może połączyć się z Elasticsearch. Wbudowane fulltextsearch:testpolecenie jest przydatne, ponieważ sprawdza skonfigurowany łańcuch, a nie tylko jeden komponent.
Zanim zaczniesz
Potrzebujesz dostępu administratora do NextCloud, dostępu do powłoki serwera lub kontenera, na którym działa NextCloud, oraz instancji Elasticsearch 8 dostępnej z tego środowiska. Poniższe przykłady zakładają serwer Linux i użycie Dockera dla Elasticsearch, ponieważ utrzymuje on usługę wyszukiwania w izolacji. Jeśli korzystasz już z zarządzanego lub dedykowanego klastra Elasticsearch 8, użyj istniejącego punktu końcowego HTTPS.
W środowisku produkcyjnym nie udostępniaj portu 9200 bezpośrednio do publicznego Internetu. Aktualna dokumentacja Dockera firmy Elastic zaleca powiązanie portu HTTP z kontrolowanym interfejsem i zachowanie funkcji bezpieczeństwa. Firma Elastic dokumentuje również wymagania dotyczące hosta, na przykład vm.max_map_countw przypadku wdrożeń Dockera w środowisku produkcyjnym. Traktuj każde polecenie pojedynczego węzła z wyłączonymi zabezpieczeniami jako lokalny skrót laboratoryjny, a nie szablon produkcyjny.
Krok 1: Zainstaluj trzy wymagane aplikacje Nextcloud
Na stronie aplikacji Nextcloud zainstaluj i włącz opcje Wyszukiwanie pełnotekstowe , Wyszukiwanie pełnotekstowe – Platforma Elasticsearch i Wyszukiwanie pełnotekstowe – Pliki . Możesz je również zainstalować za pomocą [ occbrakuje kontekstu - kontekstu], co często jest prostsze na serwerach bez interfejsu graficznego:
sudo -u www-data php /var/www/nextcloud/occ app:install fulltextsearch
sudo -u www-data php /var/www/nextcloud/occ app:install fulltextsearch_elasticsearch
sudo -u www-data php /var/www/nextcloud/occ app:install files_fulltextsearch
Jeśli Twoje pliki Nextcloud znajdują się gdzie indziej, zmień ścieżkę na occ. W oficjalnym obrazie Nextcloud Docker ścieżka to zazwyczaj /var/www/html/occ. Po instalacji użyj , occ app:listaby sprawdzić, czy wszystkie trzy aplikacje są widoczne w sekcji Włączone.
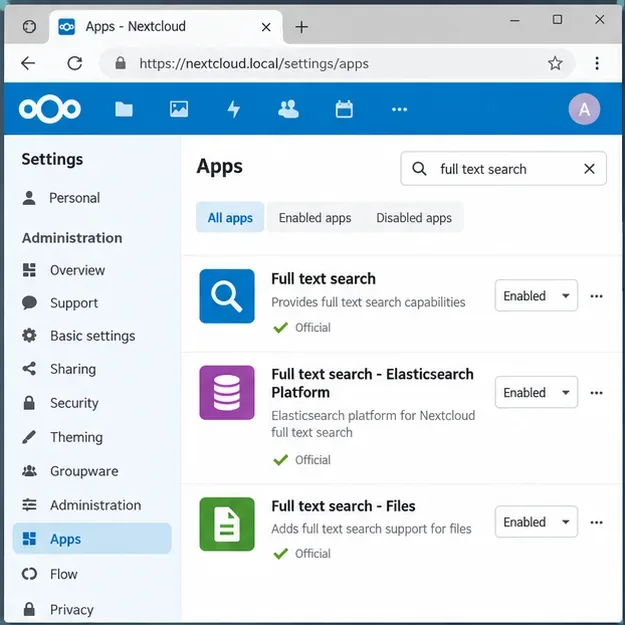
Podpis: Strona aplikacji Nextcloud z podstawowym środowiskiem pełnotekstowym, łącznikiem platformy Elasticsearch i włączonym dostawcą plików.
Krok 2: Uruchom Elasticsearch 8 i sprawdź, czy NextCloud może się z nim połączyć
Konektor Elasticsearch wymaga Elasticsearch 8 od generacji 26.0.0 aplikacji Nextcloud. Nie należy zastępować Elasticsearch wersją 9, chyba że oficjalna deklaracja zgodności zmieni się dla używanej wersji aplikacji.
W przypadku lokalnego laboratorium firma Elastic dokumentuje podejście oparte na Dockerze z jednym węzłem. Minimalna instancja testowa może zostać uruchomiona na prywatnym interfejsie. W przypadku wdrożenia produkcyjnego należy włączyć uwierzytelnianie i TLS oraz postępować zgodnie z aktualnymi instrukcjami instalacji firmy Elastic zamiast wyłączać zabezpieczenia.
docker run --name es01 --net elastic -p 127.0.0.1:9200:9200 -it -m 6GB docker.elastic.co/elasticsearch/elasticsearch:<ELASTICSEARCH_8_VERSION>
Domyślny, bezpieczny start Elastic wyświetla hasło dla wbudowanego elasticużytkownika i tworzy certyfikaty HTTP TLS. Następnie można zweryfikować węzeł za pomocą certyfikatu CA i poświadczeń, zgodnie z opisem w oficjalnym przewodniku. Jeśli NextCloud znajduje się w innym kontenerze Docker, należy pamiętać, że 127.0.0.1wskazuje on na sam kontener NextCloud, a nie kontener Elasticsearch. Umieść obie usługi we współdzielonej sieci Docker i użyj nazwy usługi Elasticsearch, takiej jak [lub] https://elasticsearch:9200, lub przekieruj przez adres prywatny.
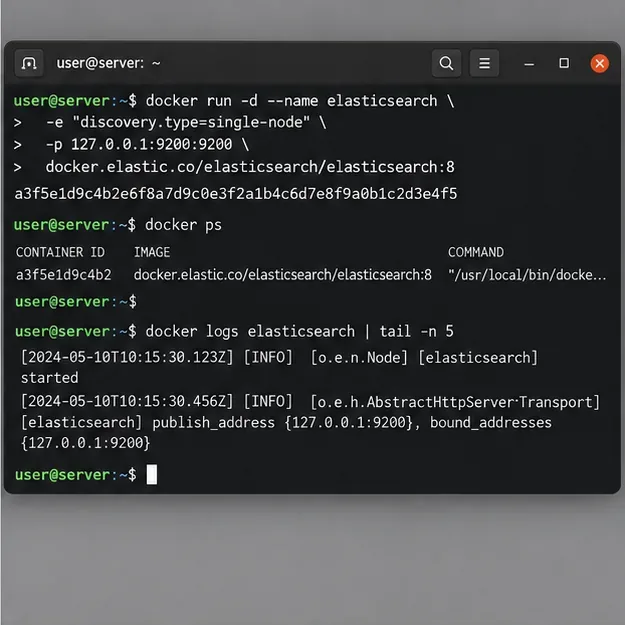
Podpis: Widok terminala usługi Elasticsearch na pojedynczym węźle, która jest uruchamiana i sprawdzana. W środowisku produkcyjnym należy zachować włączone uwierzytelnianie i protokół TLS zamiast korzystać z niezabezpieczonej konfiguracji laboratoryjnej.
Krok 3: Skonfiguruj Nextcloud do korzystania z Elasticsearch
Platformę można skonfigurować w interfejsie administracyjnym, ale formularz CLI jest precyzyjny i powtarzalny. Własna integracja All-in-One firmy Nextcloud konfiguruje platformę poprzez wybranie klasy platformy Elasticsearch, a następnie przekazuje nazwę hosta i indeksu Elasticsearch do łącznika.
sudo -u www-data php /var/www/nextcloud/occ fulltextsearch:configure '{"search_platform":"OCA\\FullTextSearch_Elasticsearch\\Platform\\ElasticSearchPlatform"}'

sudo -u www-data php /var/www/nextcloud/occ fulltextsearch_elasticsearch:configure '{"elastic_host":"https://elastic:YOUR_PASSWORD@elasticsearch:9200","elastic_index":"nextcloud_index"}'
Użyj adresu URL hosta, do którego można dotrzeć z procesu PHP Nextcloud. Jeśli punkt końcowy Elasticsearch korzysta z prywatnego urzędu certyfikacji, upewnij się, że środowisko Nextcloud ufa temu urzędowi, zamiast wyłączać weryfikację certyfikatów. Unikaj umieszczania poświadczeń w historii powłoki w systemach współdzielonych; użyj chronionej metody konfiguracji odpowiedniej dla danego wdrożenia.
Nazwa indeksu powinna być zapisana małymi literami i dedykowana tej instancji NextCloud. Nazwa taka nextcloud_indexpowinna być łatwa do zidentyfikowania. Jeśli kilka instancji NextCloud współdzieli jeden klaster Elasticsearch, nadaj każdej instancji unikalną nazwę indeksu.
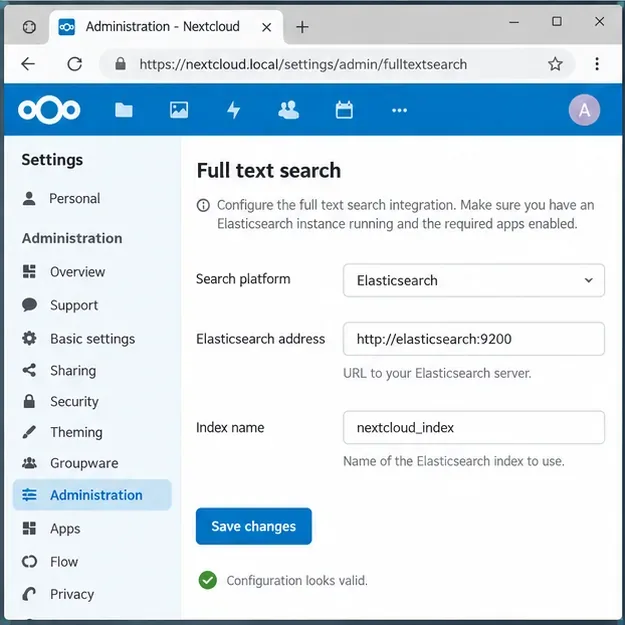
Podpis: Ekran administracyjny wyszukiwania pełnotekstowego z Elasticsearch wybranym jako platforma wyszukiwania i skonfigurowaną dedykowaną nazwą indeksu.
Krok 4: Wybierz, jaka zawartość pliku ma zostać zindeksowana
Dostawca plików kontroluje, które kategorie zawartości plików są wysyłane do indeksowania. Inicjalizacja All-in-One w NextCloud umożliwia obecnie wyodrębnianie plików PDF i dokumentów Office za pomocą tego polecenia:
sudo -u www-data php /var/www/nextcloud/occ files_fulltextsearch:configure '{"files_pdf":true,"files_office":true}'
Dostępne opcje dostawcy mogą się różnić w zależności od wersji aplikacji, dlatego przed skopiowaniem ustawień ze starszego samouczka należy sprawdzić aktualną konfigurację. Należy również pamiętać, że jakość wyodrębniania tekstu zależy od pliku źródłowego. Zwykły plik PDF z osadzonym tekstem jest znacznie łatwiejszy do indeksowania niż zeskanowany plik PDF zawierający wyłącznie obraz. Wyszukiwanie pełnotekstowe nie gwarantuje automatycznie dokładności słabego OCR.
Krok 5: Przetestuj pełną konfigurację wyszukiwania
Przed indeksowaniem dużej biblioteki należy uruchomić test struktury:
sudo -u www-data php /var/www/nextcloud/occ fulltextsearch:test
Pomyślny test powinien wykazać, że platforma jest osiągalna, a skonfigurowana kombinacja dostawcy i platformy może działać. W przypadku niepowodzenia należy naprawić połączenie przed uruchomieniem indeksu początkowego. Typowe przyczyny to użycie localhostniewłaściwego kontenera, problemy z zaufaniem certyfikatu, błędy uwierzytelniania, niezgodna wersja główna Elasticsearch lub konfiguracja indeksu odrzucana przez Elasticsearch.
Krok 6: Zbuduj indeks początkowy
Po zaliczeniu testu utwórz indeks początkowy:
sudo -u www-data php /var/www/nextcloud/occ fulltextsearch:index
Na dużym serwerze może to zająć trochę czasu i zużyć procesor, pamięć, wejście/wyjście pamięci masowej oraz stos Elasticsearch. Uruchom pierwsze skanowanie w oknie o niskim ruchu i obserwuj logi Nextcloud i Elasticsearch. Platforma obsługuje również formularz resetowania błędów używany przez Nextcloud All-in-One podczas początkowej konfiguracji:
sudo -u www-data php /var/www/nextcloud/occ fulltextsearch:index '{"errors":"reset"}' --no-readline
Nie resetuj i nie odbudowuj poprawnie indeksu wielokrotnie bez powodu. W przypadku aktualizacji, najpierw przeczytaj informacje o wydaniach trzech wyszukiwarek i sprawdź, czy ponowne indeksowanie jest rzeczywiście wymagane.
Krok 7: Utrzymuj indeks aktualny
Indeks początkowy to tylko migawka. Nowe przesłania i edycje wymagają ciągłego indeksowania. Struktura wyszukiwania pełnotekstowego zawiera fulltextsearch:livepolecenie do ciągłego przetwarzania. Jeśli z niej korzystasz, uruchom ją pod nadzorem procesu lub innym menedżerem usług, aby uruchomić ją ponownie po awariach lub ponownym uruchomieniu hosta.
sudo -u www-data php /var/www/nextcloud/occ fulltextsearch:live
Nie uruchamiaj niezarządzanego procesu pierwszego planu w sesji SSH i nie zakładaj, że indeksowanie będzie kontynuowane po wylogowaniu. Wdrożenia kontenerowe mogą uruchamiać proces roboczy na żywo jako dedykowany proces nadzorowany; tradycyjne serwery mogą korzystać z systemd lub procesu nadzorczego. Monitoruj go jak każdą inną usługę działającą w tle.
Krok 8: Zweryfikuj wyszukiwanie zarówno z poziomu interfejsu CLI, jak i interfejsu Nextcloud
Po zakończeniu wstępnego przeszukiwania wyszukaj frazę, która pojawia się w znanym dokumencie, a nie tylko w jego nazwie pliku. To potwierdza, że ekstrakcja treści i indeksowanie działają. Najnowsze wersje wyszukiwania pełnotekstowego obsługują również przeszukiwanie occ, co jest przydatne przy oddzielaniu problemu z indeksowaniem zaplecza od problemu z przeglądarką lub wyszukiwaniem ujednoliconym.
W interfejsie internetowym skorzystaj z pola wyszukiwania Nextcloud i poszukaj charakterystycznej frazy w pliku PDF, DOCX lub tekstowym, o którym wiesz, że został zindeksowany. Jeśli wyszukiwanie po nazwie pliku działa, ale wyszukiwanie po treści dokumentu nie, sprawdź ustawienia dostawcy plików i typ dokumentu źródłowego.
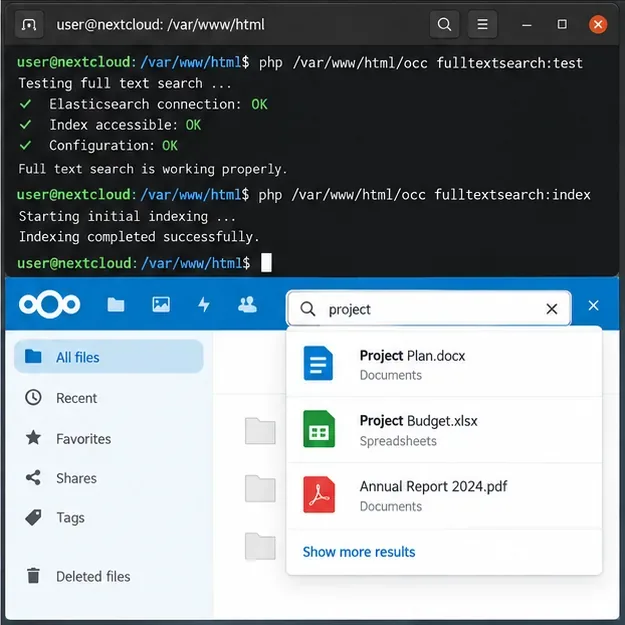
Podpis: Udany test struktury i początkowy indeks, po którym nastąpiło wyszukiwanie w usłudze Nextcloud zwracające zindeksowane dokumenty.
Rozwiązywanie typowych usterek
Elasticsearch współpracuje z curl, ale Nextcloud nie może się połączyć
Przeprowadź test z tej samej przestrzeni nazw sieciowych, co proces PHP Nextcloud. W Dockerze pomyślne żądanie od hosta nie dowodzi, że kontener Nextcloud może rozwiązać lub dotrzeć do usługi Elasticsearch. Sprawdź DNS, sieci kontenerów, reguły zapory sieciowej, zaufanie TLS i dokładny schemat w skonfigurowanym adresie URL.
Łącznik zgłasza problem z wersją Elasticsearch
Sprawdź faktyczną wersję główną Elasticsearch, a nie tylko tag obrazu, który chcesz wdrożyć. Aktualne oficjalne repozytorium konektorów nadal podaje kompatybilność Elasticsearch 8 z aplikacją w wersji 26.0.0 i nowszych. W momencie pisania tego tekstu istnieje otwarte żądanie wsparcia dla Elasticsearch 9, więc nie należy zakładać zgodności Elasticsearch 9.
Indeksowanie zużywa zbyt dużo pamięci
Obejrzyj jednocześnie stertę Elasticsearch, limity pamięci kontenera i pamięć hosta. Dokumentacja produkcyjna Dockera firmy Elastic również omawia ustawienia na poziomie hosta, takie jak vm.max_map_count: Jeśli maszyna wirtualna Java (JVM) jest wyłączana, samo zwiększenie limitu pamięci PHP w Nextcloud nie rozwiąże problemu po stronie Elasticsearch.
Brakuje niektórych plików współdzielonych lub zewnętrznych
Działanie wyszukiwania może zależeć od wsparcia dostawcy i wersji aplikacji. Projekt dostawcy plików stale monitoruje problemy związane z folderami współdzielonymi, folderami grupowymi i pamięcią zewnętrzną. Jeśli jeden typ pamięci masowej zachowuje się inaczej niż zwykłe pliki lokalne, należy odtworzyć problem na małym, kontrolowanym przykładzie i sprawdzić oficjalny system śledzenia problemów dostawcy przed odbudowaniem całego indeksu.
Jak sprawdzić, czy konfiguracja została ukończona
Prawidłowe wdrożenie ma cztery obserwowalne oznaki: Elasticsearch 8 jest dostępny z NextCloud, fulltextsearch:testpomyślnie przeszedł proces, początkowe fulltextsearch:indexwyszukiwanie kończy się bez nierozwiązanych błędów, a wyszukiwanie tekstu w znanym dokumencie zwraca ten plik dla autoryzowanego użytkownika. Zachowaj prywatność punktu końcowego indeksu, zachowaj bezpieczeństwo Elasticsearch w środowisku produkcyjnym i zaktualizuj trzy aplikacje wyszukiwania NextCloud zgodnie z główną wersją NextCloud.
Aby uzyskać szczegółowe informacje dotyczące wersji, skorzystaj z oficjalnej listy wydań platformy Nextcloud Elasticsearch oraz oficjalnych wskazówek Elastic dotyczących środowiska produkcyjnego Docker . Te źródła to najbezpieczniejsze miejsce do potwierdzenia zgodności i wymagań dotyczących hosta przed poważną aktualizacją.









