Collabora Online kontra ONLYOFFICE: Test wykorzystania zasobów i opóźnień
Wybór między Collabora Online a ONLYOFFICE Docs jest często przedstawiany jako kwestia funkcji lub formatu pliku, ale zespoły infrastrukturalne zazwyczaj podejmują drugą decyzję po wdrożeniu: ile procesora i pamięci zużywa każdy stos oraz jak szybko można edytować dane, wydłużając czas transmisji i zwiększając współbieżność? Nie ma wiarygodnej, uniwersalnej wartości dla żadnego z produktów, ponieważ złożoność dokumentów, czcionki, nakład pracy związany z konwersją, opóźnienie pamięci masowej, zachowanie przeglądarki, odwrotne proxy i liczba jednocześnie otwartych dokumentów – wszystko to wpływa na wynik.
Według stanu na październik 2026 r. żaden z dostawców nie publikuje aktualnego, porównywalnego testu porównawczego z innymi. To ma znaczenie. Rzetelne porównanie powinno zatem uwzględniać dwa rodzaje dowodów: wytyczne dotyczące rozmiaru platformy dostawcy, które wskazują, ile zasobów oczekuje się od każdego projektu, oraz powtarzalny test opóźnień/zasobów, przeprowadzany na identycznym sprzęcie. Poniższy plan testów ma na celu wygenerowanie wyników, które można wykorzystać we własnym wdrożeniu, bez udawania, że jeden wynik laboratoryjny ma zastosowanie wszędzie.
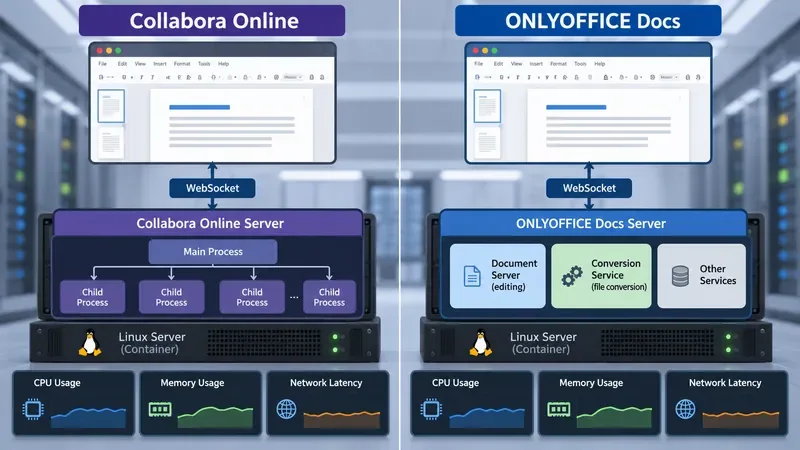
Układ testów porównawczych dla Collabora Online i ONLYOFFICE Docs. Panele monitorujące pokazują metryki do zebrania – procesor, pamięć i opóźnienie sieci – zamiast zmierzonych wartości testów porównawczych.
Co tak naprawdę mówią oficjalne wytyczne dotyczące zasobów
Dostawcy publikują przydatne informacje o rozmiarach, ale dane te nie są bezpośrednio równoważne. Podręcznik SDK Collabora zawiera przykład produkcyjny Kubernetes/Helm, który zaleca żądania zasobów na poziomie 4 CPU i 6 GB pamięci, z limitem 8 CPU i 8 GB. Ten sam podręcznik opisuje num_prespawn_children, który utrzymuje procesy potomne w gotowości, aby nowe sesje mogły uruchamiać się szybciej, kosztem dodatkowej pamięci. Zobacz podręcznik SDK Collabora Online . Aktualny szablon konfiguracji Collabora udostępnia również limit proporcji pamięci i kontrolę współbieżności dla poszczególnych dokumentów; oficjalne źródło projektu jest dostępne w szablonie konfiguracji Collabora Online .
ONLYOFFICE publikuje bardziej szczegółowe poziomy referencyjne dla Docs Community Edition w Dockerze. Aktualne wytyczne mówią o 4 GB pamięci RAM lub więcej i wymieniają konfiguracje referencyjne z jednym rdzeniem 2,8 GHz dla mniej niż 100 jednoczesnych aktywnych użytkowników, dwoma rdzeniami dla 100–200 i czterema rdzeniami dla 200–400, przy czym w tych wierszach referencyjnych zachowano 4 GB pamięci RAM. Dostawca wyraźnie ostrzega, że rzeczywista pojemność zależy od liczby, typu i rozmiaru dokumentów. Zobacz wymagania ONLYOFFICE Docs Community Edition Docker .
Obszar
Współpraca online
Dokumenty ONLYOFFICE
Co należy stwierdzić
Opublikowane rozmiary produkcji
Przykład SDK Helm zaleca 4 procesory / 6 GiB, limit do 8 procesorów / 8 GiB
Referencje Dockera zaczynają się od 4 GB pamięci RAM; poziomy procesorów skalują się wraz z liczbą aktywnych użytkowników
Nie należy nazywać żadnego z produktów „lżejszymi” wyłącznie na podstawie tych liczb; założenia dotyczące wdrożenia różnią się
Zachowanie ciepłego startu
Utworzone wcześniej procesy potomne mogą wymieniać pamięć na szybsze uruchamianie sesji
Wiele usług po stronie serwera obsługuje edycję, konwersję, polecenia i tworzenie dokumentów
Bezczynna pamięć i opóźnienie pierwszego otwarcia mogą odzwierciedlać architekturę i dostrojenie, a nie tylko wydajność edytora
Model współbieżności
Przetwarzanie na podstawie dokumentu ma konfigurowalne kontrole współbieżności
Użytkownikiem aktywnym jednocześnie jest użytkownik z otwartym dokumentem, wliczając sesje tylko do przeglądania zgodnie z definicją dostawcy
Konsekwentnie licz otwarte sesje przed porównaniem pojemności
Dlaczego zrzut ekranu z pamięci bezczynnej nie jest punktem odniesienia
Częstym porównaniem jest uruchomienie obu kontenerów, nieotwieranie żadnych dokumentów i uznanie za zwycięzcę tego z mniejszym zużyciem pamięci RAM. W ten sposób mierzy się jedynie bazowy rozmiar pliku. Pomija się w ten sposób istotną pracę: otwieranie pliku, konwertowanie go w razie potrzeby, renderowanie stron lub arkuszy, przesyłanie zmian, przeliczanie arkuszy kalkulacyjnych, obsługę wielu edytorów i zapisywanie wyników z powrotem do pamięci masowej.
Model procesów Collabora pozwala na wcześniejsze przygotowanie procesów potomnych. Pozwala to na zmniejszenie liczby bezczynnych procesów i jednoczesne skrócenie czasu, w którym dokument staje się gotowy do użycia. ONLYOFFICE oddziela edycję dokumentów od usług takich jak konwersja; dokumentacja architektury opisuje edytor dokumentów, usługę edycji, usługę poleceń, usługę konwersji i usługę konstruktora. Zobacz, jak działa ONLYOFFICE Docs . Innymi słowy, bazowy RSS jest użyteczną metryką operacyjną, ale nie wystarcza do przewidywania prędkości widocznej dla użytkownika.
Uczciwa konfiguracja testów zasobów i opóźnień
Uruchom oba produkty pojedynczo na tym samym hoście lub na dwóch identycznie skonfigurowanych maszynach wirtualnych. Unikaj testowania jednego na rozgrzanym hoście z plikami w pamięci podręcznej, a drugiego bezpośrednio po uruchomieniu. Zachowaj identyczne parametry dystrybucji Linuksa, wersji Dockera, limitu procesora, limitu pamięci, klasy pamięci masowej, odwrotnego proxy, zakończenia TLS, wersji przeglądarki i ścieżki do przechowywania dokumentów.
Użyj trzech obciążeń dokumentowych
Dokument tekstowy: typowy plik DOCX z nagłówkami, tabelami, obrazami, śledzonymi zmianami i komentarzami.
Arkusz kalkulacyjny: plik XLSX z formułami, formatowaniem warunkowym, kilkoma arkuszami i wystarczającą ilością danych, aby uruchomić sensowne przeliczenia.
Prezentacja: plik PPTX z obrazami, wykresami i wieloma slajdami, a nie prawie pusty zestaw.
Użyj tych samych plików dla obu platform. Jeśli plik wymaga konwersji formatu w jednym produkcie, odnotuj ten fakt, ponieważ konwersja może mieć decydujący wpływ na czas otwarcia. Nie optymalizuj pliku specjalnie pod kątem jednego edytora, a następnie traktuj wynik jako ogólne porównanie platform.
Testuj na więcej niż jednym poziomie współbieżności
Praktyczna sekwencja to 1, 5, 10 i 20 jednocześnie otwartych edytorów, a następnie wyższy poziom, który odpowiada rzeczywistemu oczekiwanemu szczytowi. „Użytkownik” powinien oznaczać to samo w każdym przebiegu: zakładkę edytora z całkowicie otwartym dokumentem. Powtórz każdy poziom co najmniej trzy razy po przebiegu rozgrzewkowym i zapisz medianę oraz najwolniejszy wynik. Dzięki temu krótkie skoki tła będą miały mniejsze prawdopodobieństwo zniekształcenia wniosków.
Metryki zasobów do zarejestrowania
Docker zapewnia niezależną od dostawcy pierwszą warstwę telemetrii. Oficjalna dokumentacja statystyk Dockera wyjaśnia, że docker statsraporty obejmują procentowe wykorzystanie procesora, użycie pamięci, wejście/wyjście sieciowe, wejście/wyjście blokowe oraz identyfikatory PID. Przechwytuj zarówno strumień na żywo podczas obciążenia, jak i próbkę bez strumienia w zdefiniowanych punktach kontrolnych.
Dla każdego poziomu współbieżności należy rejestrować pamięć bezczynną przed otwarciem czegokolwiek, pamięć stacjonarną po otwarciu wszystkich dokumentów, szczytowe obciążenie procesora podczas otwierania, obciążenie procesora po ustabilizowaniu się sesji oraz pamięć po zamknięciu każdej sesji. Należy również obserwować, czy po okresie schładzania pamięć powraca do poziomu bazowego. Wyższa wartość po teście nie oznacza automatycznie wycieku – pamięci podręczne i pamięć współdzielona mogą pozostać użyteczne – ale stale rosnący poziom minimalnego obciążenia w powtarzających się, identycznych cyklach wymaga zbadania.
Nie porównuj tylko procentowych wartości kontenerów, jeśli jeden z nich ma inny limit procesora lub pamięci. Zapisz rzeczywiste limity hosta lub cgroup wraz z wynikami testów porównawczych. Dane dotyczące pamięci Dockera w systemie Linux również uwzględniają niuanse związane z rozliczaniem pamięci podręcznej, dlatego używaj tego samego środowiska Dockera i cgroup dla obu produktów.
Jak zmierzyć opóźnienie otwarte
Zdefiniuj opóźnienie otwarcia przed testowaniem. Obronną definicją jest czas od otwarcia okna przez użytkownika do momentu, gdy edytor będzie widoczny i gotowy do wprowadzenia danych, a treść dokumentu ustabilizuje się na tyle, aby można było rozpocząć pisanie. Zmierz ten sam znacznik dla obu produktów. Proste nagranie ekranu ze znacznikami czasu może być bardziej porównywalne niż poleganie na wewnętrznych zdarzeniach specyficznych dla produktu.
Zbierz dwie formy opóźnienia otwarcia. Zimne otwarcie rozpoczyna się po ponownym uruchomieniu kontenera Office i wyczyszczeniu sesji testowej. Ciepłe otwarcie powtarza ten sam plik bez ponownego uruchamiania usługi. Ustawienie wstępnego tworzenia (prespawn) w Collabora sprawia, że to rozróżnienie jest szczególnie ważne, ponieważ więcej oczekujących procesów potomnych może zmniejszyć opóźnienie uruchamiania, jednocześnie zwiększając zużycie pamięci. Jeśli dostosujesz num_prespawn_children, podaj jego wartość obok wyników, zamiast ją ukrywać.
Jak mierzyć opóźnienie we współpracy
W przypadku współedycji w czasie rzeczywistym, miarodajnym wskaźnikiem nie jest zwykły ping ICMP. Zmierz opóźnienie między edycją w przeglądarce A a widoczną zmianą w przeglądarce B. Użyj dwóch oddzielnych profili przeglądarek lub komputerów i zsynchronizuj ich zegary. Zarejestruj 20–50 prostych edycji, takich jak dodanie znaku do tego samego akapitu, a następnie oblicz medianę i widoczne opóźnienie propagacji dla 95. percentyla.
Oficjalny opis współedycji w ONLYOFFICE potwierdza, że zmiany są przesyłane z edytora do usługi edycji dokumentów, a następnie do drugiego edytora. Zobacz przepływ pracy współedycji w ONLYOFFICE . Konfiguracja serwera ujawnia również ustawienia związane z WebSocket, w tym zachowanie ponownego połączenia i maksymalny rozmiar ładunku, w dokumentacji konfiguracji serwera ONLYOFFICE . Collabora również opiera się na stałym ruchu WebSocket przez odwrotny serwer proxy, dlatego buforowanie serwera proxy, zachowanie limitu czasu, zakończenie TLS i czas RTT sieci powinny być traktowane jako część środowiska testowego, a nie jako szczegóły tła.
Dodaj kontrolowane opóźnienie sieciowe
Jeśli użytkownicy pracują zdalnie, powtórz test współpracy z kontrolowanym opóźnieniem w obie strony, np. około 20 ms, 80 ms i 150 ms. Zastosuj to samo kształtowanie sieci w obu systemach i udokumentuj dokładnie moment jego wprowadzenia. Ujawnia to różnicę, którą mogą ukrywać testy porównawcze w lokalnych sieciach LAN: redaktor może czuć się doskonale przy RTT 1–5 ms, ale zauważalnie mniej bezpośrednio w oddziałach lub zespołach międzynarodowych.
Opóźnienie zapisu wymaga własnego pomiaru
Zapisywanie nie jest tożsame z opóźnieniem wpisywania. ONLYOFFICE dokumentuje przepływ pracy, w którym usługa edycji kompiluje zmiany i wysyła do usługi pamięci masowej wywołanie zwrotne po zakończeniu edycji; w dokumentacji odnotowano domyślne opóźnienie rozpoczęcia konwersji wynoszące pięć sekund i dodano, że ostateczny czas zależy również od czasu konwersji, złożoności pliku i wydajności serwera. Zobacz dokumentację ONLYOFFICE saving-file . Oznacza to, że stwierdzenie „zapis trwał kilka sekund” nie powinno być automatycznie interpretowane jako opóźnienie interaktywne.
W przypadku obu produktów należy mierzyć czas ukończenia zapisu od momentu zakończenia pracy ostatniego edytora do momentu potwierdzenia zaktualizowanego pliku w pamięci masowej. Pamięć masowa powinna znajdować się w tej samej ścieżce sieciowej i tej samej klasie dysku. W przeciwnym razie powolne działanie NextCloud, ownCloud, magazynu obiektów, bazy danych lub odwrotnego proxy może być przypisane pakietowi biurowemu.
Arkusz wyników: liczby, które mają znaczenie
Metryczny
Nagraj w
Dlaczego to ważne
Pamięć bezczynna
Brak otwartych dokumentów
Koszt bazowy dla małych serwerów
Stała pamięć na obciążenie
1, 5, 10, 20+ otwartych edytorów
Pokazuje lepsze zachowanie skalowania niż bezczynny RSS
Maksymalny procesor
Podczas otwierania dokumentu i ponownego przeliczania arkusza kalkulacyjnego
Ujawnia wymagania dotyczące pojemności wybuchowej
Opóźnienie zimnego otwarcia
Po ponownym uruchomieniu usługi
Rejestruje koszt uruchomienia/utworzenia procesu
Opóźnienie ciepłego otwarcia
Powtarzający się plik otwarty
Wykazuje normalną reakcję na powtarzane sesje
Edytuj propagację p50/p95
Współedycja przez dwóch użytkowników
Pomiary postrzeganego opóźnienia współpracy
Zapisz zakończenie
Ostatni edytor zamyka lub kończy
Oddziela czas trwałości od opóźnienia interaktywnego
Jak interpretować wynik
Jeśli Collabora zużywa więcej wolnej pamięci w Twojej konfiguracji, ale zapewnia niższe opóźnienie przy zimnym otwarciu, może to być akceptowalne rozwiązanie, jeśli użytkownicy często otwierają dokumenty, a serwer ma wolną pamięć RAM. Jeśli ONLYOFFICE wykazuje niższą wartość bazową, ale silniejsze skoki obciążenia procesora podczas konwersji, zapas mocy obliczeniowej procesora może mieć większe znaczenie niż pamięć. Możliwe są również odwrotne wzorce; chodzi o to, aby powiązać każdą krzywą zasobów ze zdarzeniem widocznym dla użytkownika.
W przypadku małej, samodzielnie hostowanej instalacji, należy skupić się na bezczynności, czasie pierwszego otwarcia oraz na tym, czy jeden lub dwa duże dokumenty powodują podmianę. W przypadku wdrożenia biznesowego z dziesiątkami aktywnych edytorów, priorytetem powinno być uwzględnienie wzrostu pamięci, nasycenia procesora, opóźnienia współedycji p95 oraz odzyskiwania po obciążeniu. W przypadku użytkowników rozproszonych geograficznie, konfiguracja RTT sieci i serwera proxy może przeważyć nad niewielkimi różnicami po stronie serwera.
Najbardziej wartościowym zwycięzcą jest zatem produkt, który mieści się w budżecie procesora i pamięci RAM, a jednocześnie spełnia cel dotyczący opóźnień w rzeczywistych dokumentach. Strony z rozmiarami dostawców to punkty wyjścia, a nie wyniki testów porównawczych. Uruchom to samo obciążenie, utrzymuj kontrolę nad środowiskiem, publikuj konfigurację testową obok wyników i unikaj uogólniania pojedynczego odczytu pamięci bezczynności na stwierdzenie dotyczące ogólnej wydajności.