Jak naprawić wysokie użycie procesora w Collabora Online z loolwsd / coolwsd
Gdy Collabora Online nagle zużywa większość zasobów procesora serwera, najważniejszym pierwszym krokiem jest unikanie jego wielokrotnego restartowania lub natychmiastowego narzucania bardzo niskiego limitu procesora. Najpierw sprawdź, czy obciążenie pochodzi z normalnej pracy nad dokumentami, jednej patologicznej sesji dokumentów, zbyt dużej ilości pracy równoległej, bezczynnej sesji, która nie jest czyszczona, czy też regresji specyficznej dla danej wersji. Nazwa procesu może być dostępna zarówno coolwsdw bieżących wersjach, jak i loolwsdw starszych instalacjach.
Przykładowy scenariusz: wyobraź sobie serwer z 8 procesorami wirtualnymi (vCPU) i usługą Collabora Online w chmurze NextCloud. Wydaje się, że tylko kilka osób edytuje dokumenty, ale kontener Collabora przez kilka minut obciąża procesor na poziomie 250–350%. Jest to hipotetyczny przykład używany w tym przewodniku, a nie zmierzony benchmark ani raport z rzeczywistego wdrożenia.
Od października 2026 roku aktualna stabilna gałąź Collabora to 26.04, a oficjalne informacje o wydaniu wymieniają Collabora Online 26.04.3.3 z datą wydania 14 września 2026 roku. Aktualne szablony konfiguracji używają tej coolwsdnazwy. Narzędzia migracji Collabora nadal dokumentują starszą /etc/loolwsd/loolwsd.xmlścieżkę dla instalacji z wersji 6.4 lub starszych, dlatego administratorzy mogą nadal spotykać się z obiema nazwami.
1. Sprawdź, który proces faktycznie zużywa zasoby procesora
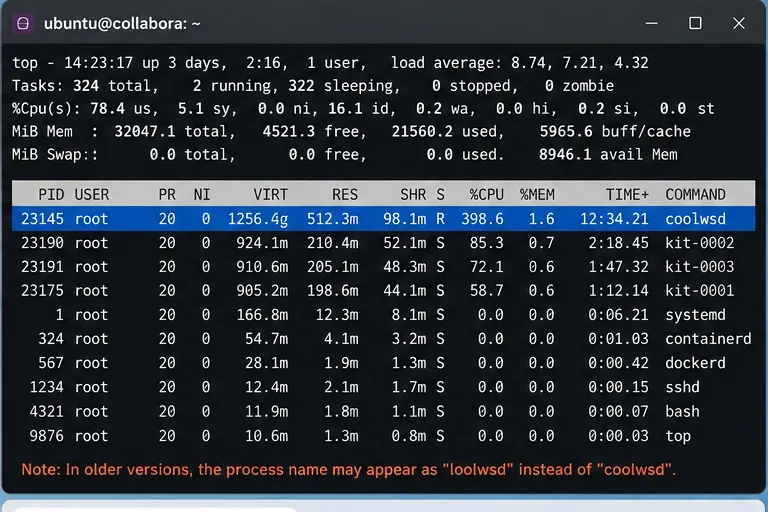
Zacznij od poziomu systemu operacyjnego lub kontenera. Wysoka wartość obok coolwsdnie oznacza automatycznie, że demon koordynujący wykonuje całą kosztowną pracę związaną z dokumentami. Collabora uruchamia również procesy kit/forkit dla sesji dokumentów, dlatego przed zmianą konfiguracji warto poznać drzewo procesów i obciążenie procesora dla każdego procesu.
ps -eo pid,ppid,pcpu,pmem,etime,cmd --sort=-pcpu | head -n 25
top -H -p $(pgrep -d, -f 'coolwsd|loolwsd|coolkit|loolkit|forkit')
W przypadku Dockera należy również sprawdzić kontener jako całość:
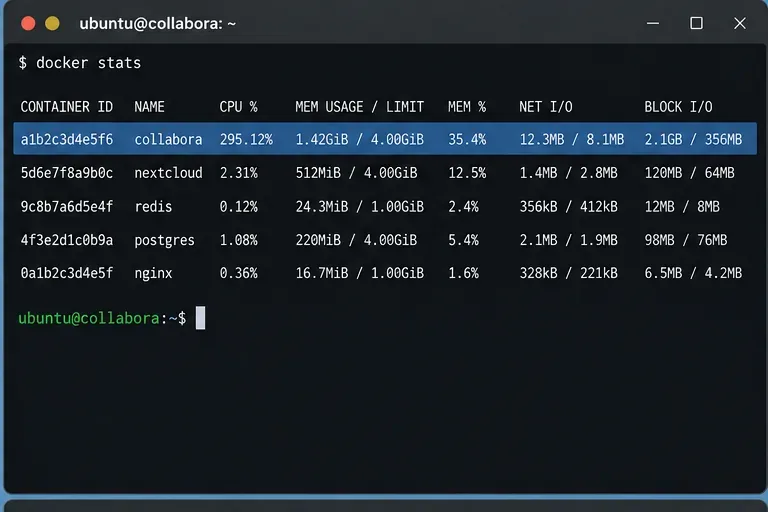
docker stats --no-stream
Widok na poziomie procesu pomaga oddzielić głównego demona Collabora od procesów zestawu dokumentów przed podjęciem próby dostrajania.Procesor na poziomie kontenera przydaje się do potwierdzenia, że Collabora jest źródłem obciążenia hosta, ale nie identyfikuje odpowiedzialnego dokumentu lub procesu potomnego.
W tym ilustratywnym scenariuszu załóżmy, że kontener wykorzystuje blisko 300% procesora, a jeden proces zestawu stale znajduje się na szczycie listy procesów. To wskazuje na konkretną aktywną sesję dokumentu, a nie na ogólne założenie, że cały serwer jest przeciążony.
2. Sprawdź własne wskaźniki Collabora zamiast polegać tylko na danych z góry
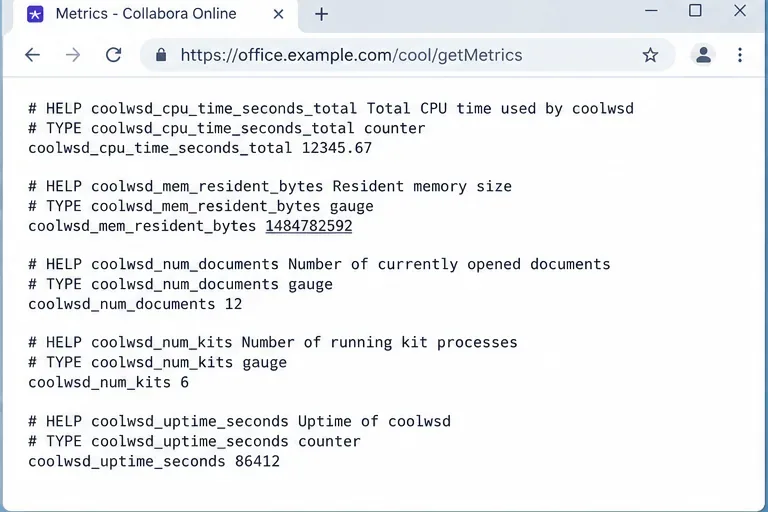
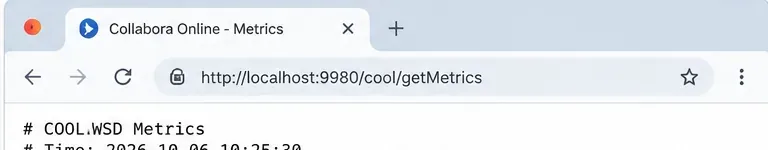
Collabora Online udostępnia metryki zgodne z Prometheusem pod adresem /cool/getMetrics. Aktualny podręcznik SDK mówi, że ten punkt końcowy może raportować użycie procesora i pamięci, uruchomione procesy zestawu, widoki i inne dane dotyczące wykorzystania serwera. Używa tego samego uwierzytelniania co konsola administracyjna, chyba że metryki są jawnie skonfigurowane dla dostępu nieuwierzytelnionego.
Nie udostępniaj publicznie punktu końcowego metryk, aby uprościć rozwiązywanie problemów. Oficjalna konfiguracja Helm zawiera nawet przykłady blokowania /cool/getMetricsi adresów URL administratora na wejściu. W miarę możliwości używaj uwierzytelnionej ścieżki wewnętrznej.
Punkt końcowy metryk Collabora zapewnia kontekst po stronie serwera, który uzupełnia pomiary procesora Linux lub Docker.
Poszukaj związku między obciążeniem procesora a aktywnymi dokumentami lub widokami. Jeśli obciążenie procesora rośnie i spada podczas prawidłowej edycji, może to oznaczać problem z wydajnością lub współbieżnością. Jeśli obciążenie procesora utrzymuje się na wysokim poziomie, ale nie ma odpowiedniej pracy interaktywnej, sprawdź nieaktualne sesje, problematyczny dokument, powtarzające się zadania w tle lub problem z oprogramowaniem.
3. Przeczytaj logi w czasie, gdy procesor zaczyna działać
W przypadku instalacji pakietu zarządzanej przez systemd:
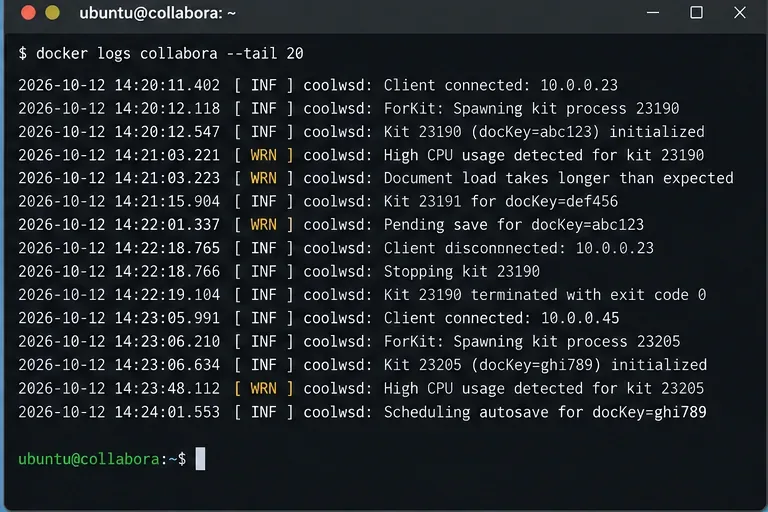
Jeśli Twoja usługa lub kontener ma inną nazwę, zmień ją. Wyszukaj powtarzające się wczytywanie dokumentów, tworzenie zestawów, nieudane zapisy, awarie, pętle ponownego łączenia lub powtarzający się ten sam klucz dokumentu. Krótki okres zwiększonego obciążenia procesora podczas otwierania dokumentu, przeliczania, renderowania, konwersji lub eksportu może być uzasadniony. Silniejszym sygnałem ostrzegawczym jest stałe obciążenie procesora bez postępu lub powtarzający się ten sam błąd.
Porównuj logi z momentem szczytowego obciążenia procesora, aby odróżnić normalną aktywność dokumentu od powtarzających się lub zawieszonych zadań.
4. Odtwórz kolce w jednym dokumencie na raz
Wróć do hipotetycznego serwera. Jeśli jeden z procesów zestawu jest gorący, zamknij lub odizoluj podejrzany dokument i obserwuj, czy wystąpi spadek obciążenia procesora. Następnie otwórz ten sam plik w okresie ciszy, monitorując jednocześnie listę procesów i metryki. Powtórz z prostym dokumentem testowym.
To porównanie jest bardziej przydatne niż natychmiastowe ponowne uruchomienie całej usługi:
Jeśli tylko jeden plik niezawodnie wyzwala skok, to większym podejrzeniem jest jego zawartość, formuły, osadzone obiekty, obciążenie renderowaniem lub błąd specyficzny dla dokumentu.
Jeśli każdy plik powoduje podobne nasycenie, gdy aktywnych jest kilku użytkowników, należy sprawdzić przepustowość serwera i współbieżność.
Jeśli obciążenie procesora utrzymuje się na wysokim poziomie po ustaniu wszelkiej aktywności użytkownika, należy skupić się na czyszczeniu, nieaktualnych zestawach narzędzi, powtarzających się zadaniach w tle lub regresji.
Jeśli problem pojawił się zaraz po uaktualnieniu, zapisz starą i nową wersję przed zmianą wielu innych zmiennych.
5. Zmniejsz współbieżność poszczególnych dokumentów, gdy jeden dokument może monopolizować rdzenie
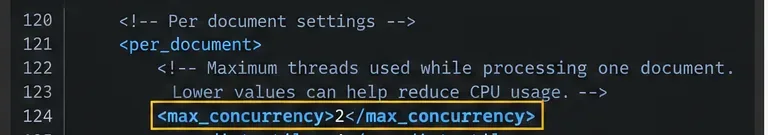
Obecny szablon konfiguracji Collabora per_document.max_concurrencyokreśla maksymalną liczbę wątków używanych podczas przetwarzania dokumentu. Domyślna wartość szablonu to 4. Na mniejszym hoście lub gdy pojedynczy, złożony dokument może zdominować maszynę, zmniejszenie tej wartości może sprawić, że obciążenie procesora będzie bardziej przewidywalne.
Obniżenie współbieżności poszczególnych dokumentów wiąże się z pewnym kompromisem: może zmniejszyć intensywność wykorzystania procesora przez jeden dokument, ale ciężkie operacje mogą zająć więcej czasu.
Nie kopiuj cyfry 2 bezmyślnie. Jeśli użytkownicy regularnie pracują z dużymi arkuszami kalkulacyjnymi lub prezentacjami, a serwer ma wystarczającą liczbę rdzeni, niższa wartość może po prostu spowolnić pracę. Zmień jedno ustawienie, odtwórz to samo obciążenie i porównaj obciążenie procesora, szybkość reakcji i czas wykonania.
6. Sprawdź ustawienia czyszczenia i sesji bezczynności przed ich agresywnym użyciem
Obecny coolwsd.xmlszablon zawiera logikę czyszczenia dla dokumentów, które są nieaktywne i pochłaniają dużo zasobów. W chwili pisania tego tekstu szablon zawiera interwał sprawdzania czyszczenia wynoszący 10 000 ms, 60-sekundowy okres nieprawidłowego działania, 300-sekundowy próg bezczynności oraz 85% próg wykorzystania procesora, aby dokument mógł zostać uznany za kandydata do czyszczenia. Zawiera również limit czasu bezczynności dla każdego dokumentu wynoszący 3600 sekund.
Ten sam szablon uwzględnia limity czasu dla każdego widoku. Aktualne wartości wskazują 300 sekund przed przyciemnieniem nieaktywnego widoku przeglądarki i zatrzymaniem aktualizacji oraz 900 sekund przed podobnym traktowaniem nieaktywnego widoku. Te limity czasu widoku nie są tym samym, co natychmiastowe zamknięcie całej sesji dokumentu.
Funkcje czyszczenia i kontroli bezczynności widoku mogą ograniczyć marnowanie pracy, jednak należy je dostrajać ostrożnie, aby nie zakłócać normalnych, długotrwałych sesji edycyjnych.
Unikaj ustawiania progu CPU na skrajnie niskim poziomie tylko po to, by wykres wyglądał lepiej. Czyszczenie ma na celu wyłapywanie zasobożernych, złych lub nieaktywnych dokumentów, a nie przerywanie zwykłej, aktywnej edycji, gdy staje się ona zbyt kosztowna obliczeniowo.
7. Uruchom ponownie dopiero po zapisaniu kontrolowanej zmiany konfiguracji
Najpierw wykonaj kopię zapasową aktywnej konfiguracji. Instalacje pakietów zazwyczaj korzystają z /etc/coolwsd/coolwsd.xml. Wdrożenia Dockera mogą przekazywać opcje jako zmienne środowiskowe lub nadpisania wiersza poleceń, albo montować plik konfiguracyjny w kontenerze. Przed edycją sprawdź, które źródło jest faktycznie aktywne.
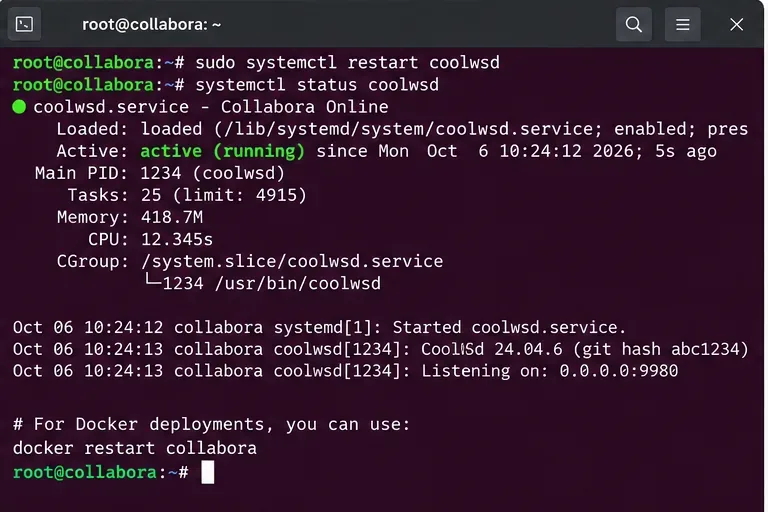
Ponowne uruchomienie należy wykonać dopiero po celowej, zapasowej zmianie konfiguracji, a następnie sprawdzić, czy usługa działa prawidłowo, zanim użytkownicy wznowią testowanie.
Jeśli samo ponowne uruchomienie tymczasowo naprawi procesor, ale problem będzie się powtarzał, jest to informacja diagnostyczna, a nie trwałe rozwiązanie. Kontynuuj, aż będziesz w stanie wyjaśnić, jakie obciążenie lub stan powoduje nawrót problemu.
8. Porównaj stan przed i po tym samym obciążeniu pracą
Użyj tego samego dokumentu, mniej więcej tej samej liczby użytkowników i tej samej sekwencji operacji. Pomiar powinien trwać kilka minut, zamiast porównywać pojedyncze momenty. W tym przypadku sukces oznaczałby, że serwer nie będzie już obciążony podczas odtworzonego obciążenia, a otwieranie, edytowanie, zapisywanie i współpraca nad dokumentami nadal będą przebiegać akceptowalnie.
Używaj tego samego punktu końcowego metryk po każdej kontrolowanej zmianie, aby porównanie stanu przed i po opierało się na porównywalnych danych serwera.
Obserwacja
Prawdopodobne następne działanie
Jeden dokument lub zestaw pozostaje aktualny
Powtórz działanie z tym plikiem, zachowaj logi i przetestuj na bieżącej stabilnej mikrowersji.
Procesor śledzi liczbę aktywnych użytkowników
Przeanalizuj pojemność, współbieżność i rozmiar wdrożenia zamiast traktować obciążenie jako wyciek.
Procesor pozostaje na wysokim poziomie po odejściu użytkowników
Przeprowadź inspekcję nieaktywnych dokumentów, zachowań czyszczenia, powtarzających się zadań w tle oraz porzuconych lub ponownie uruchamianych zestawów.
Spike rozpoczął pracę natychmiast po aktualizacji
Przed zmianą wielu wartości dostrajających zapisz dokładne wersje i sprawdź bieżące informacje o wydaniach oraz znane problemy.
Niższy max_concurency zmniejsza obciążenie procesora, ale edycja staje się wolniejsza
Zwiększaj ją stopniowo lub dodaj moc procesora; to ustawienie jest kompromisem, a nie uniwersalnym rozwiązaniem.
Kiedy należy dokonać aktualizacji zamiast strojenia?
Jeśli problem pojawił się wraz z konkretną wersją Collabora i można go odtworzyć za pomocą konkretnego pliku lub operacji, dostrojenie konfiguracji może jedynie ukryć defekt oprogramowania. Collabora zaleca korzystanie z najnowszej wersji z bieżącej gałęzi stabilnej. Na dzień 7 października 2026 r. oficjalna strona z informacjami o wydaniu 26.04 wymieniała wersję 26.04.3.3 jako najnowszą wersję Collabora Online.
Użytkownicy CODE powinni pamiętać, że Collabora opisuje wersję Development Edition jako odpowiednią dla małych zespołów, do użytku domowego, programowania i testowania nowych funkcji, jednocześnie zaznaczając, że nie jest ona przeznaczona do środowisk produkcyjnych. Incydent produkcyjny w CODE może zatem uzasadniać przejście na wspierany produkt Collabora Online zamiast ciągłego dostosowywania się do działania wersji Development Edition.
Czego nie robić
Nie zakładaj, że wysoka coolwsdwartość dowodzi wycieku pamięci lub nieskończonej pętli.
Nie należy ustawiać na stałe rejestrowania debugowania lub śledzenia podczas incydentów z procesorem, chyba że jest to rzeczywiście potrzebne; szczegółowe rejestrowanie powoduje dodatkowe obciążenie i zwiększa obciążenie pamięci masowej.
Nie udostępniaj konsoli administracyjnej ani punktu końcowego metryk publicznemu Internetowi wyłącznie w celu ułatwienia monitorowania.
Nie obniżaj progów czyszczenia, dopóki normalne aktywne sesje nie zostaną zamknięte.
Nie należy używać limitów procesora jako pierwszego kroku diagnostycznego. Sztywny limit może chronić sąsiadów na hoście współdzielonym, ale może przekształcić problem z procesorem w powolne renderowanie dokumentów i przekroczenia limitu czasu bez ujawnienia przyczyny.
Zalecana kolejność rozwiązywania problemów
Sprawdź, czy zajętym procesem jest coolwsd, starszy proces loolwsdczy proces podrzędny zestawu/zestawu.
Rejestruje procesor, pamięć, aktywne dokumenty i widoki Dockera lub hosta.
Powiąż logi z dokładnym oknem szczytowym.
Powtórz z jednym podejrzanym dokumentem, a następnie z prostym dokumentem kontrolnym.
Przetestuj per_document.max_concurrencytylko wtedy, gdy jeden dokument wykorzystuje zbyt dużo równoległego procesora.
Sprawdź ustawienia czyszczenia i bezczynności, nie ustawiając ich niepotrzebnie zbyt agresywnie.
Po każdej kontrolowanej zmianie konfiguracji należy ponownie uruchomić usługę i sprawdzić jej stan.
Porównaj to samo obciążenie przed i po, a następnie sprawdź bieżącą stabilną wersję, jeśli zachowanie wydaje się specyficzne dla danej wersji.
Praktycznym celem nie jest zmuszanie Collabora Online do jak najmniejszego wykorzystania procesora. Chodzi o to, aby obciążenie procesora było zrozumiałe i proporcjonalne do użytecznej pracy, przy jednoczesnym zachowaniu akceptowalnej wydajności edycji i współpracy.