Acasă
» MS OFFICE
»
How to Fix Collabora Online High CPU Usage from loolwsd / coolwsd
How to Fix Collabora Online High CPU Usage from loolwsd / coolwsd
When Collabora Online suddenly uses most of a server's CPU, the most important first step is not to restart it repeatedly or immediately impose a very low CPU limit. First determine whether the load comes from normal document work, one pathological document session, too much parallel work, an idle session that is not being cleaned up, or a version-specific regression. The process name may be coolwsd on current releases and loolwsd on older installations.
Illustrative scenario: imagine an 8-vCPU server running Collabora Online behind Nextcloud. Only a few people appear to be editing documents, but the Collabora container sits around 250% to 350% CPU for several minutes. This is a hypothetical example used throughout this guide, not a measured benchmark or a report from a real deployment.
As of October 2026, Collabora's current stable branch is 26.04, and the official release notes list Collabora Online 26.04.3.3 as released on September 14, 2026. Current configuration templates use the coolwsd name. Collabora's migration tooling still documents the older /etc/loolwsd/loolwsd.xml path for installations from the 6.4 era or earlier, which is why administrators may still encounter both names.
1. Confirm which process is actually consuming CPU
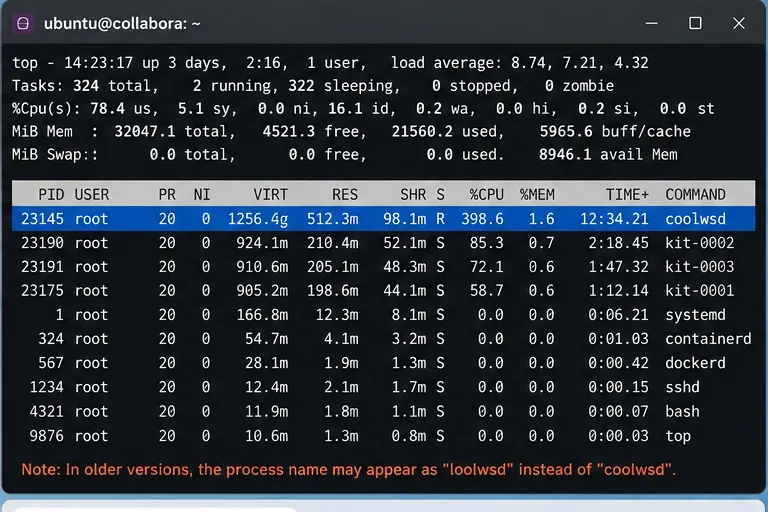
Start at the operating-system or container level. A high number beside coolwsd does not automatically mean the coordinating daemon itself is doing all of the expensive document work. Collabora also runs kit/forkit processes for document sessions, so you want the process tree and per-process CPU usage before changing configuration.
ps -eo pid,ppid,pcpu,pmem,etime,cmd --sort=-pcpu | head -n 25
top -H -p $(pgrep -d, -f 'coolwsd|loolwsd|coolkit|loolkit|forkit')
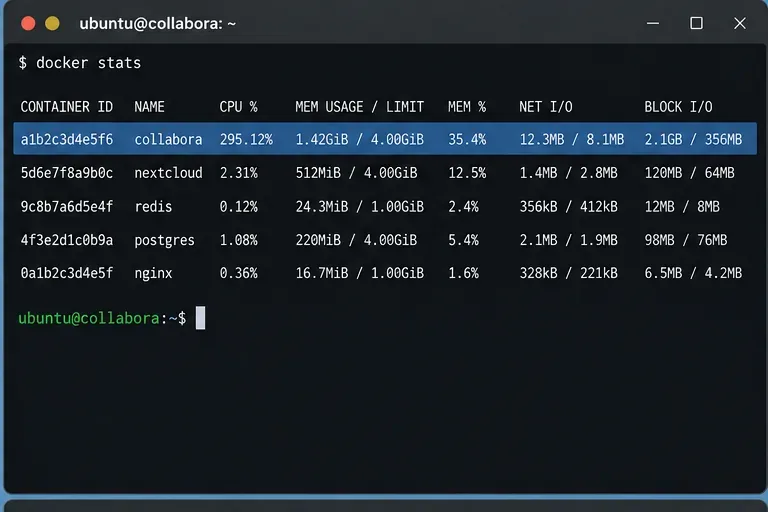
For Docker, also check the container as a whole:
docker stats --no-stream
A process-level view helps separate the main Collabora daemon from document-related kit processes before any tuning is attempted.Container-level CPU is useful for confirming that Collabora is the source of host load, but it does not identify the document or child process responsible.
In the illustrative scenario, suppose the container is near 300% CPU and one kit process is consistently at the top of the process list. That points you toward a specific active document session rather than a generic assumption that the entire server is overloaded.
2. Check Collabora's own metrics instead of relying only on top
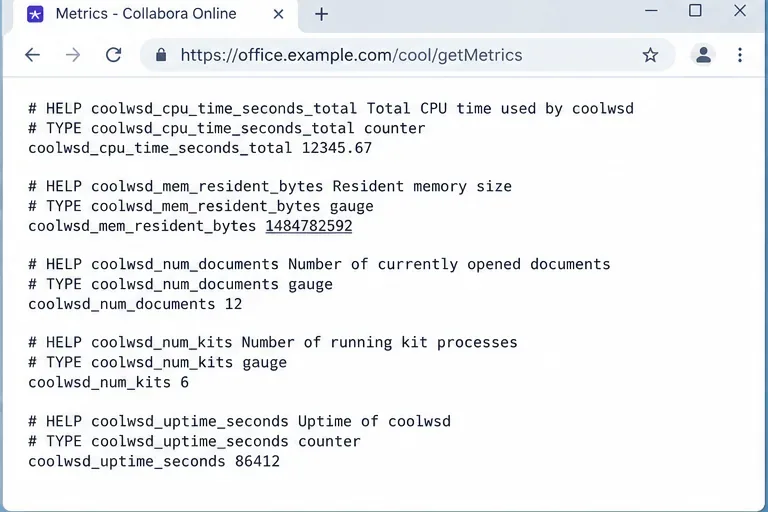
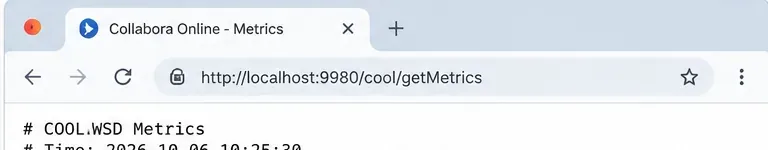
Collabora Online exposes Prometheus-compatible metrics at /cool/getMetrics. The current SDK manual says this endpoint can report CPU and memory use, running kit processes, views, and other server-usage data. It uses the same authentication as the admin console unless metrics are explicitly configured for unauthenticated access.
Nu expuneți public endpoint-ul metric-urilor doar pentru a simplifica depanarea. Configurația oficială Helm include chiar și exemple pentru blocarea /cool/getMetricsși administrarea URL-urilor la o intrare. Folosiți o cale internă autentificată ori de câte ori este posibil.
Punctul final de metrică Collabora oferă context la nivel de server care completează măsurătorile CPU Linux sau Docker.
Căutați o relație între CPU și documentele sau vizualizările active. Dacă CPU crește și scade în funcție de activitatea legitimă de editare, este posibil să aveți o problemă de capacitate sau concurență. Dacă CPU rămâne ridicat fără nicio activitate interactivă corespunzătoare, investigați sesiunile învechite, un document problematic, activitatea repetată în fundal sau o problemă de software.
3. Citiți jurnalele în jurul momentului exact în care CPU crește
Pentru o instalare de pachet gestionată de systemd:
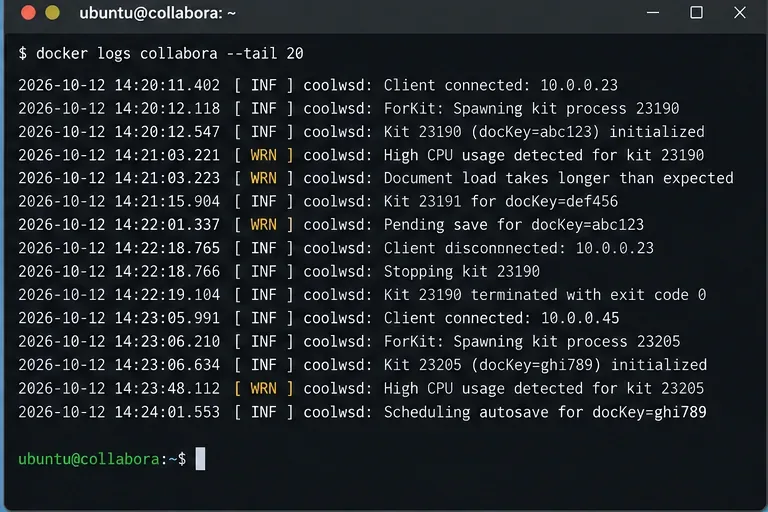
Dacă serviciul sau containerul are un nume diferit, înlocuiți-l. Căutați încărcări repetate de documente, creări repetate de kituri, salvări eșuate, blocări, bucle de reconectare sau apariția aceleiași chei de document în mod repetat. O perioadă scurtă de utilizare mai mare a CPU în timpul deschiderii, recalculării, redării, conversiei sau exportului documentului poate fi legitimă. Semnul de avertizare mai puternic este utilizarea CPU susținută fără progres util sau repetarea aceleiași erori.
Corelați jurnalele cu momentul vârfului de solicitare a procesorului, astfel încât să puteți distinge activitatea normală a documentelor de cea repetată sau blocată.
4. Reproduceți vârful de acțiune cu câte un document pe rând
Reveniți la serverul ipotetic. Dacă un proces din kit este activ, închideți sau izolați documentul suspect și observați dacă CPU-ul scade. Apoi deschideți același fișier într-o perioadă de liniște, monitorizând în același timp lista de procese și metricile. Repetați cu un document de test simplu.
Această comparație este mai utilă decât repornirea imediată a întregului serviciu:
Dacă un singur fișier declanșează în mod fiabil vârful de solicitare, conținutul fișierului, formulele, obiectele încorporate, volumul de lucru de randare sau o eroare specifică documentului reprezintă un suspect mai puternic.
Dacă fiecare fișier provoacă o saturație similară odată ce mai mulți utilizatori sunt activi, investigați capacitatea serverului și concurența.
Dacă nivelul procesorului rămâne ridicat după ce toată activitatea utilizatorului se oprește, concentrați-vă pe curățare, kituri învechite, activități repetate în fundal sau o regresie.
Dacă problema a început imediat după o actualizare, înregistrați versiunile veche și nouă înainte de a modifica multe alte variabile.
5. Reduceți concurența per document atunci când un document poate monopoliza nucleele
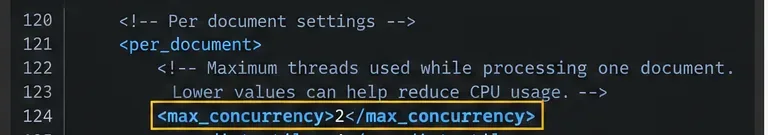
Șablonul de configurare Collabora actual documentează per_document.max_concurrencynumărul maxim de fire de execuție utilizate în timpul procesării unui document. Valoarea implicită a șablonului este 4. Pe o gazdă mai mică sau când un singur document complex poate domina mașina, reducerea acestei valori poate face utilizarea procesorului mai previzibilă.
Reducerea concurenței per document este un compromis: poate reduce agresivitatea utilizării CPU de către un document, dar operațiunile complexe pot dura mai mult.
Nu copiați numărul 2 orbește. Dacă utilizatorii manipulează în mod obișnuit foi de calcul mari sau prezentări, iar serverul are suficiente nuclee, o valoare mai mică poate pur și simplu să încetinească lucrul. Schimbați o setare, reproduceți aceeași sarcină de lucru și comparați CPU-ul, timpul de răspuns și timpul de finalizare.
6. Verificați setările de curățare și de sesiune inactivă înainte de a le face agresive
Șablonul actual coolwsd.xmlinclude o logică de curățare pentru documentele inactive care consumă resurse. În momentul scrierii, șablonul arată un interval de verificare a curățării de 10.000 ms, o perioadă de 60 de secunde pentru comportament necorespunzătoare, un prag de inactivitate de 300 de secunde și un prag de 85% al CPU pentru ca un document să devină un candidat pentru curățare. De asemenea, include un timeout de inactivitate per document de 3.600 de secunde.
Același șablon include timeout-uri per vizualizare. Valorile curente arată 300 de secunde înainte ca o vizualizare de browser nefocalizată să fie estompată și să oprească actualizările și 900 de secunde înainte ca o vizualizare inactivă să fie tratată în mod similar. Aceste timeout-uri pentru vizualizări nu sunt același lucru cu descărcarea imediată a unei întregi sesiuni de documente.
Controalele de curățare și de inactivitate pot reduce munca irosită, dar acestea ar trebui ajustate cu moderație, astfel încât sesiunile normale de editare de lungă durată să nu fie întrerupte.
Evitați setarea pragului CPU extrem de scăzut doar pentru a îmbunătăți aspectul graficului. Curățarea este concepută pentru a detecta documentele inactive sau proaste care consumă resurse, nu pentru a opri editarea activă obișnuită ori de câte ori devine costisitoare din punct de vedere computațional.
7. Reporniți numai după salvarea unei modificări de configurație controlate
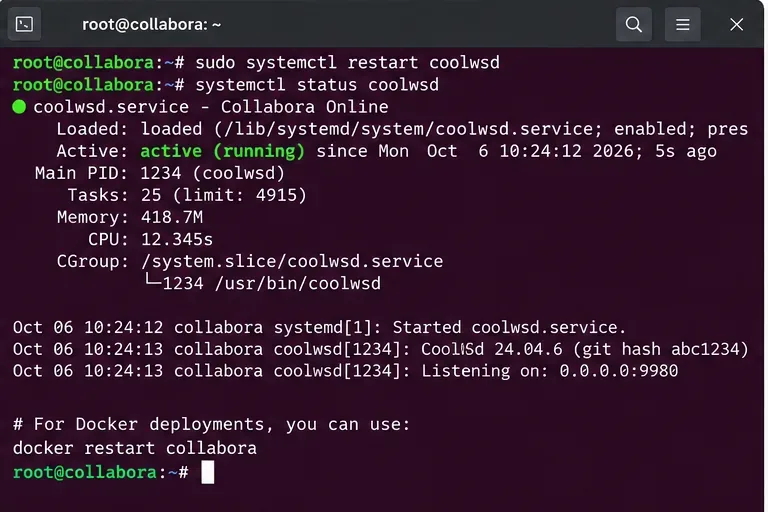
Mai întâi faceți o copie de rezervă a configurației active. Instalările de pachete utilizează de obicei /etc/coolwsd/coolwsd.xml. Implementările Docker pot transmite opțiuni ca variabile de mediu sau suprascrieri din linia de comandă sau pot monta un fișier de configurare în container. Confirmați care sursă este de fapt activă înainte de a edita ceva.
Reporniți numai după o modificare deliberată a configurației, cu backup, apoi verificați dacă serviciul este sănătos înainte ca utilizatorii să reia testarea.
Dacă o repornire singură remediază temporar procesorul, dar problema reapare în mod repetat, aceasta este o informație de diagnosticare, nu o soluție permanentă. Continuați până când puteți explica ce sarcină de lucru sau stare cauzează recurența.
8. Comparați înainte și după în cadrul aceleiași sarcini de lucru
Folosiți același document, aproximativ același număr de utilizatori și aceeași secvență de operațiuni. Măsurați timp de câteva minute, în loc să comparați un singur moment. În scenariul ilustrativ, succesul ar însemna că serverul nu mai rămâne saturat în timpul volumului de lucru reprodus, în timp ce deschiderea, editarea, salvarea și colaborarea documentelor se comportă în continuare acceptabil.
Folosește același punct final de metrică după fiecare modificare controlată, astfel încât comparația înainte și după să se bazeze pe date comparabile ale serverului.
Observare
Următoarea acțiune probabilă
Un document sau un kit rămâne fierbinte
Reproduceți cu acel fișier, păstrați jurnalele și testați pe versiunea micro stabilă curentă.
CPU urmărește numărul de utilizatori activi
Revizuiți capacitatea, concurența și dimensionarea implementării, în loc să tratați sarcina ca pe o scurgere.
CPU-ul rămâne la capacitate maximă după ce utilizatorii pleacă
Inspectați documentele inactive, comportamentul de curățare, lucrările repetate în fundal și kiturile orfane sau care se repornesc.
Spike a pornit imediat după o actualizare
Înregistrați versiunile exacte și verificați notele de lansare actuale și problemele cunoscute înainte de a modifica multe valori de reglare.
O valoare mai mică a max_concurrency reduce procesorul, dar editarea devine lentă
Măriți-o treptat sau adăugați capacitatea procesorului; setarea este un compromis, nu o soluție universală.
Când ar trebui să faci actualizarea în loc de reglarea?
Dacă comportamentul a început cu o anumită versiune Collabora și îl puteți reproduce cu un anumit fișier sau o anumită operațiune, ajustarea configurației poate ascunde doar un defect software. Collabora recomandă utilizarea celei mai recente versiuni din ramura stabilă curentă. Începând cu 7 octombrie 2026, pagina oficială cu note de lansare 26.04 listează versiunea 26.04.3.3 ca fiind cea mai recentă versiune Collabora Online afișată acolo.
Pentru utilizatorii CODE, rețineți că Collabora descrie Development Edition ca fiind potrivită pentru echipe mici, utilizare acasă, dezvoltare și testarea unor funcționalități mai noi, precizând în același timp că nu este destinată mediilor de producție. Prin urmare, un incident de producție pe CODE poate justifica trecerea la produsul Collabora Online suportat, în loc de ajustarea continuă a comportamentului ediției de dezvoltare.
Ce să nu faci
Nu presupuneți că un coolwsdnumăr mare dovedește o scurgere de memorie sau o buclă infinită.
Nu setați permanent înregistrarea în jurnal a depanării sau a urmăririi în timpul unui incident CPU decât dacă aveți nevoie de ele; înregistrarea detaliată adaugă propriul cost suplimentar și presiune asupra spațiului de stocare.
Nu expuneți consola de administrare sau endpoint-ul metricilor la internetul public doar pentru comoditatea monitorizării.
Nu reduceți pragurile de curățare până când sesiunile active normale nu sunt închise.
Nu utilizați cotele CPU ca prim pas de diagnosticare. O limită fixă poate proteja vecinii de pe o gazdă partajată, dar poate transforma o problemă a CPU într-o randare lentă a documentelor și expirări fără a dezvălui cauza.
Ordinea de depanare recomandată
Confirmați dacă procesul ocupat este coolwsdun proces kit/forkit mai vechi loolwsdsau un proces fiu.
Înregistrați procesorul, memoria, documentele active și vizualizările din Docker sau gazdă.
Corelați jurnalele cu fereastra exactă a vârfurilor.
Reproduceți cu un document suspect și apoi cu un document de control simplu.
Testați per_document.max_concurrencydoar dacă un document utilizează prea mult CPU paralel.
Revizuiți setările de curățare și de inactivitate fără a le face inutil de agresive.
Reporniți după fiecare modificare controlată a configurației și verificați starea serviciului.
Comparați aceeași sarcină de lucru înainte și după, apoi verificați versiunea stabilă curentă dacă comportamentul pare specific versiunii.
Scopul practic nu este de a forța Collabora Online să utilizeze cât mai puțin CPU posibil. Ci de a face consumul CPU explicabil și proporțional cu munca utilă, menținând în același timp performanțe acceptabile de editare și colaborare.