Inicio
» MS OFFICE
»
Collabora Online vs ONLYOFFICE: Prueba de uso de recursos y latencia
Collabora Online vs ONLYOFFICE: Prueba de uso de recursos y latencia
La elección entre Collabora Online y ONLYOFFICE Docs suele plantearse como una cuestión de características o formato de archivo, pero los equipos de infraestructura suelen descubrir una segunda decisión tras la implementación: ¿cuánta CPU y memoria consume cada plataforma y qué tan fluida sigue siendo la edición a medida que aumentan el tiempo de respuesta y la concurrencia? No existe una cifra universal fiable para ninguno de los dos productos, ya que la complejidad del documento, las fuentes, el trabajo de conversión, la latencia de almacenamiento, el comportamiento del navegador, los proxies inversos y el número de documentos abiertos simultáneamente influyen en el resultado.
A octubre de 2026, ninguno de los proveedores publica una comparativa directa y actualizada. Esto es importante. Por lo tanto, una comparación justa debe diferenciar dos tipos de evidencia: la guía de dimensionamiento del proveedor, que indica qué recursos se esperan para cada proyecto, y una prueba repetible de latencia y recursos ejecutada en hardware idéntico. El plan de pruebas que se presenta a continuación está diseñado para generar datos que pueda utilizar en su propia implementación, sin pretender que un resultado de laboratorio sea aplicable en todos los casos.
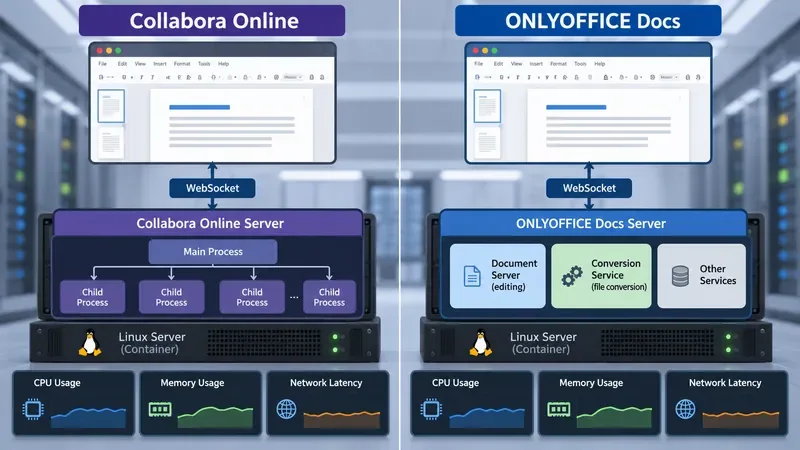
Un diseño comparativo para Collabora Online y ONLYOFFICE Docs. Los paneles de monitorización muestran las métricas que se deben recopilar (CPU, memoria y latencia de red) en lugar de los valores de referencia medidos.
Lo que realmente dice la guía oficial sobre recursos.
Los proveedores publican información útil sobre el dimensionamiento, pero las cifras no son directamente equivalentes. El manual del SDK de Collabora incluye un ejemplo de producción de Kubernetes/Helm que recomienda solicitudes de recursos de 4 CPU y 6 GiB de memoria, con límites de 8 CPU y 8 GiB. El mismo manual describe num_prespawn_children, que mantiene los procesos secundarios listos para que las nuevas sesiones puedan iniciarse más rápido a costa de memoria adicional. Consulte el manual del SDK de Collabora Online . La plantilla de configuración actual de Collabora también expone un límite de proporción de memoria y controles de concurrencia por documento; el código fuente oficial del proyecto está disponible en la plantilla de configuración de Collabora Online .
ONLYOFFICE publica niveles de referencia más explícitos para Docs Community Edition en Docker. Su guía actual indica 4 GB de RAM o más y enumera configuraciones de referencia de un núcleo de 2,8 GHz para menos de 100 usuarios activos concurrentes, dos núcleos para 100-200 y cuatro núcleos para 200-400, manteniendo los 4 GB de RAM en esas filas de referencia. El proveedor advierte explícitamente que la capacidad real depende del número, tipo y tamaño de los documentos. Consulte los requisitos de Docker de ONLYOFFICE Docs Community Edition .
Área
Colabora en línea
Documentos de ONLYOFFICE
¿Qué concluir?
Tamaño de producción publicado
El ejemplo de SDK Helm recomienda 4 CPU / 6 GiB solicitados, hasta un límite de 8 CPU / 8 GiB.
Docker de referencia comienza con 4 GB de RAM; los niveles de CPU se escalan con usuarios activos concurrentes.
No califique ninguno de los productos como “más ligero” basándose únicamente en estas cifras; las suposiciones de implementación difieren.
Comportamiento de arranque en caliente
Los procesos hijos pregenerados pueden intercambiar memoria por inicios de sesión más rápidos.
Múltiples servicios del lado del servidor se encargan de la edición, la conversión, los comandos y la creación de documentos.
La memoria inactiva y la latencia de la primera apertura pueden reflejar la arquitectura y la optimización, no solo la eficiencia del editor.
Modelo de concurrencia
El procesamiento por documento cuenta con controles de concurrencia configurables.
Un usuario activo concurrente es un usuario con un documento abierto, incluidas las sesiones de solo lectura según la definición del proveedor.
Cuente las sesiones abiertas de forma consistente antes de comparar la capacidad.
Por qué una captura de pantalla de memoria inactiva no es una prueba de rendimiento.
Una comparación común consiste en iniciar ambos contenedores, no abrir ningún documento y declarar ganador al que consuma menos RAM. Esto solo mide el consumo básico de recursos. No tiene en cuenta las tareas importantes: abrir un archivo, convertirlo cuando sea necesario, renderizar páginas u hojas de cálculo, transmitir cambios, recalcular hojas de cálculo, atender a varios editores y guardar el resultado en el almacenamiento.
El modelo de procesos de Collabora puede mantener los procesos secundarios listos con anticipación. Esto puede aumentar el tiempo de inactividad y reducir el tiempo de espera antes de que un documento esté disponible. ONLYOFFICE separa la edición de documentos de servicios como la conversión; su documentación de arquitectura describe el editor de documentos, el servicio de edición, el servicio de comandos, el servicio de conversión y el servicio de creación. Consulte Cómo funciona ONLYOFFICE Docs . En otras palabras, el RSS base es una métrica operativa útil, pero no es suficiente para predecir la velocidad visible para el usuario.
Configuración de prueba de recursos y latencia justa
Ejecute ambos productos uno a la vez en el mismo host o en dos máquinas virtuales idénticas. Evite probar uno en un host ya caliente con archivos en caché y el otro inmediatamente después del arranque. Mantenga idénticas la distribución de Linux, la versión de Docker, la cuota de CPU, el límite de memoria, la clase de almacenamiento, el proxy inverso, la terminación TLS, la versión del navegador y la ruta de almacenamiento de documentos.
Utilice tres cargas de trabajo de documentos
Documento de texto: un documento DOCX representativo con encabezados, tablas, imágenes, control de cambios y comentarios.
Hoja de cálculo: un archivo XLSX con fórmulas, formato condicional, varias hojas de cálculo y datos suficientes para que se produzca un recálculo significativo.
Presentación: una presentación PPTX con imágenes, gráficos y varias diapositivas, en lugar de una presentación casi vacía.
Utilice los mismos archivos para ambas plataformas. Si un archivo requiere conversión de formato en un producto, registre este dato, ya que la conversión puede ser un factor determinante en el tiempo de apertura. No optimice un archivo específicamente para un editor y luego utilice el resultado como una comparación general entre plataformas.
Realizar pruebas en más de un nivel de concurrencia.
Una secuencia práctica consiste en abrir simultáneamente 1, 5, 10 y 20 editores, seguidos de un nivel superior que se ajuste al pico real esperado. En cada prueba, "usuario" debe significar lo mismo: una pestaña del editor con el documento completamente abierto. Repita cada nivel al menos tres veces después de una prueba de calentamiento e informe la mediana más el resultado más lento. Esto reduce la probabilidad de que los picos de fondo breves distorsionen la conclusión.
Métricas de recursos a registrar
Docker proporciona una primera capa de telemetría independiente del proveedor. La documentación oficial de estadísticas de Docker explica que docker statsinforma sobre el porcentaje de CPU, el uso de memoria, la E/S de red, la E/S de bloques y los PID. Permite capturar tanto una transmisión en vivo durante la carga de trabajo como una muestra sin transmisión en puntos de control definidos.
Para cada nivel de concurrencia, registre la memoria inactiva antes de abrir cualquier documento, la memoria en estado estable después de abrir todos los documentos, el pico de CPU durante la apertura, la CPU después de que las sesiones se estabilicen y la memoria después de que se cierre cada sesión. Observe también si la memoria vuelve a un valor cercano al de referencia después de un período de enfriamiento. Un valor posterior a la prueba más alto no indica automáticamente una fuga (las cachés y la memoria compartida pueden seguir siendo útiles), pero un aumento continuo del nivel mínimo en ciclos idénticos repetidos merece ser investigado.
No compare únicamente los porcentajes de los contenedores si estos tienen límites de CPU o memoria diferentes. Registre los límites reales del host o del cgroup junto con los resultados de la prueba de rendimiento. La cifra de memoria de Docker para Linux también tiene particularidades en la gestión de la caché, por lo que debe usar el mismo entorno de Docker y cgroup para ambos productos.
Cómo medir la latencia de apertura
Defina la latencia de apertura antes de realizar las pruebas. Una definición válida es el tiempo que transcurre desde que el usuario abre el documento hasta que el editor está visiblemente listo para recibir datos y el contenido se ha estabilizado lo suficiente como para empezar a escribir. Mida el mismo indicador para ambos productos. Una simple grabación de pantalla con marcas de tiempo puede ser más comparable que basarse en eventos internos específicos de cada producto.
Recopile dos formas de latencia de apertura. La apertura en frío comienza después de reiniciar el contenedor de Office y borrar la sesión de prueba. La apertura en caliente repite el mismo archivo sin reiniciar el servicio. La configuración de pregeneración de Collabora hace que esta distinción sea especialmente importante, ya que un mayor número de procesos secundarios en espera puede reducir el retraso de inicio, pero aumenta el uso de memoria. Si ajusta este parámetro num_prespawn_children, muestre su valor junto con los resultados en lugar de ocultarlo.
Cómo medir la latencia de la colaboración
Para la edición colaborativa en tiempo real, la métrica relevante no es el ping ICMP convencional. Mida el retraso entre una edición en el navegador A y el cambio visible en el navegador B. Utilice dos perfiles de navegador o máquinas diferentes y sincronice sus relojes. Registre entre 20 y 50 ediciones sencillas, como añadir un carácter al mismo párrafo, y luego calcule la mediana y el percentil 95 del retraso de propagación visible.
La descripción oficial de la edición colaborativa de ONLYOFFICE confirma que los cambios se transmiten del editor al servicio de edición de documentos y luego al otro editor. Consulte el flujo de trabajo de edición colaborativa de ONLYOFFICE . Su configuración de servidor también expone ajustes relacionados con WebSocket, incluido el comportamiento de reconexión y el tamaño máximo de carga útil, en la referencia de configuración del servidor de ONLYOFFICE . Collabora también depende del tráfico WebSocket persistente a través del proxy inverso, por lo que el almacenamiento en búfer del proxy, el comportamiento de tiempo de espera, la terminación TLS y el RTT de la red deben tratarse como parte del entorno de prueba en lugar de como detalles de fondo.
Agregar retardo de red controlado
Si sus usuarios trabajan de forma remota, repita la prueba de colaboración con una latencia de ida y vuelta controlada, por ejemplo, de 20 ms, 80 ms y 150 ms. Aplique la misma configuración de red a ambos sistemas y documente con precisión dónde se introduce. Esto revela una diferencia que las pruebas de rendimiento en redes locales pueden ocultar: un editor puede tener una experiencia excelente con una latencia de ida y vuelta de 1 a 5 ms, pero una experiencia notablemente menos fluida para sucursales o equipos internacionales.
La latencia de guardado necesita su propia medición.
Guardar no es lo mismo que escribir. ONLYOFFICE documenta un flujo de trabajo en el que el servicio de edición compila los cambios y envía una llamada al servicio de almacenamiento una vez finalizada la edición. Su documentación indica un retraso predeterminado de cinco segundos al inicio de la conversión y señala que el tiempo final también depende del tiempo de conversión, la complejidad del archivo y el rendimiento del servidor. Consulte la documentación de ONLYOFFICE sobre cómo guardar archivos . Esto significa que una observación como «guardar tardó varios segundos» no debe interpretarse automáticamente como un retraso interactivo.
Para ambos productos, mida el tiempo de guardado desde que el último editor finaliza hasta que se confirma que el archivo actualizado se encuentra en el almacenamiento de respaldo. Mantenga el almacenamiento en la misma ruta de red y clase de disco. De lo contrario, una lentitud en Nextcloud, ownCloud, almacenamiento de objetos, base de datos o proxy inverso podría deberse a la suite ofimática.
Hoja de resultados: las cifras que importan
Métrico
Registro en
Por qué es importante
Memoria inactiva
No hay documentos abiertos
Coste base para servidores pequeños
Memoria constante por carga de trabajo
1, 5, 10, 20+ editores abiertos
Muestra un comportamiento de escalado mejor que el RSS inactivo.
CPU máxima
Durante la apertura del documento y el recálculo de la hoja de cálculo
Revela los requisitos de capacidad de ráfaga
Latencia de apertura en frío
Después del reinicio del servicio
Captura el costo de inicio/creación de procesos
latencia de apertura en caliente
Apertura de archivo repetida
Muestra una capacidad de respuesta normal en sesiones repetidas.
Propagación de ediciones p50/p95
Edición conjunta entre dos usuarios
Medidas de retraso percibido en la colaboración
Guardar finalización
El último editor cierra o finaliza
Separa el tiempo de persistencia de la latencia interactiva.
Cómo interpretar el resultado
Si Collabora utiliza más memoria inactiva en su configuración, pero produce una menor latencia de apertura en frío, esto podría ser aceptable si los usuarios abren documentos con frecuencia y el servidor tiene RAM disponible. Si ONLYOFFICE muestra un consumo base menor, pero picos de CPU más pronunciados durante la conversión, la capacidad de la CPU podría ser más importante que la memoria. También son posibles los patrones opuestos; lo importante es vincular cada curva de recursos con un evento visible para el usuario.
Para una instalación pequeña autoalojada, concéntrese en el consumo de recursos en reposo, el tiempo de primera apertura y si uno o dos documentos grandes provocan el intercambio de memoria. Para una implementación empresarial con docenas de editores activos, priorice la pendiente de crecimiento de la memoria, la saturación de la CPU, el retraso de coedición p95 y la recuperación tras la carga. Para usuarios distribuidos geográficamente, el RTT de red y la configuración del proxy pueden tener mayor peso que las pequeñas diferencias en el servidor.
Por lo tanto, el producto más útil es aquel que se ajusta a tu presupuesto de CPU y RAM, cumpliendo con tu objetivo de latencia en documentos reales. Las páginas de dimensionamiento de los proveedores son puntos de partida, no resultados de pruebas comparativas. Ejecuta la misma carga de trabajo, mantén el entorno controlado, publica tu configuración de prueba junto con los datos y evita generalizar una única lectura de memoria inactiva para hacer una afirmación sobre el rendimiento general.