Accueil
» BUREAU MS
»
Comparaison de Collabora Online et ONLYOFFICE : test d’utilisation des ressources et de latence
Comparaison de Collabora Online et ONLYOFFICE : test d’utilisation des ressources et de latence
Le choix entre Collabora Online et ONLYOFFICE Docs est souvent présenté comme une question de fonctionnalités ou de format de fichier, mais les équipes d'infrastructure doivent généralement prendre une seconde décision après le déploiement : quelle est la consommation de ressources (CPU et mémoire) de chaque solution ? La réactivité de l'édition reste-t-elle optimale lorsque le temps de réponse et le nombre de fichiers ouverts simultanément augmentent ? Il n'existe pas de valeur unique et fiable pour l'un ou l'autre produit, car la complexité des documents, les polices, les conversions, la latence de stockage, le comportement du navigateur, les serveurs proxy inverses et le nombre de documents ouverts simultanément influent tous sur le résultat.
En octobre 2026, aucun des deux fournisseurs ne publie de benchmark comparatif direct et à jour. C'est un point crucial. Une comparaison équitable doit donc s'appuyer sur deux types de données : les recommandations de dimensionnement des fournisseurs, qui indiquent les ressources à provisionner pour chaque projet, et un test de latence/ressources reproductible, réalisé sur un matériel identique. Le plan de test ci-dessous est conçu pour produire des résultats exploitables pour votre propre déploiement, sans présumer qu'un résultat de laboratoire est universellement applicable.
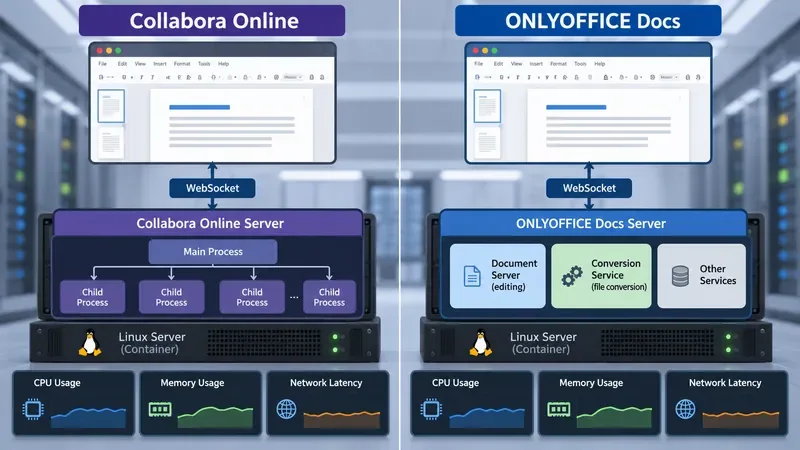
Un tableau comparatif des performances de Collabora Online et ONLYOFFICE Docs. Les panneaux de surveillance affichent les indicateurs à collecter (processeur, mémoire et latence réseau) plutôt que les valeurs de référence mesurées.
Que disent réellement les directives officielles en matière de ressources ?
Les fournisseurs publient des informations utiles sur le dimensionnement, mais les chiffres ne sont pas directement équivalents. Le manuel du SDK de Collabora inclut un exemple de production Kubernetes/Helm qui recommande des demandes de ressources de 4 CPU et 6 Gio de mémoire, avec des limites de 8 CPU et 8 Gio. Ce même manuel décrit le mécanisme num_prespawn_childrenqui maintient les processus enfants prêts afin que les nouvelles sessions puissent démarrer plus rapidement, au prix d'une consommation de mémoire supplémentaire. Consultez le manuel du SDK Collabora Online . Le modèle de configuration actuel de Collabora expose également une limite de proportion de mémoire et des contrôles de concurrence par document ; le code source officiel du projet est disponible dans le modèle de configuration de Collabora Online .
ONLYOFFICE publie des configurations de référence plus précises pour Docs Community Edition dans Docker. Ses recommandations actuelles préconisent au moins 4 Go de RAM et proposent les configurations suivantes : un cœur à 2,8 GHz pour moins de 100 utilisateurs actifs simultanés, deux cœurs pour 100 à 200 utilisateurs et quatre cœurs pour 200 à 400 utilisateurs, avec 4 Go de RAM minimum dans ces configurations. L’éditeur précise que la capacité réelle dépend du nombre, du type et de la taille des documents. Consultez la configuration requise pour ONLYOFFICE Docs Community Edition dans Docker .
Zone
Collabora Online
Documents ONLYOFFICE
Conclusion
Dimensions de production publiées
L'exemple Helm du SDK recommande une configuration de 4 CPU / 6 Gio, avec une limite maximale de 8 CPU / 8 Gio.
La configuration de référence de Docker commence à 4 Go de RAM ; les niveaux de CPU évoluent en fonction du nombre d'utilisateurs actifs simultanés.
Ne vous fiez pas uniquement à ces chiffres pour conclure que l'un ou l'autre produit est « plus léger » ; les hypothèses de déploiement diffèrent.
Comportement de démarrage à chaud
Les processus enfants pré-créés peuvent échanger de la mémoire pour des démarrages de session plus rapides.
Plusieurs services côté serveur gèrent l'édition, la conversion, les commandes et la création de documents.
La mémoire inactive et la latence de première ouverture peuvent refléter l'architecture et l'optimisation, et pas seulement l'efficacité de l'éditeur.
Modèle de concurrence
Le traitement par document dispose de contrôles de concurrence configurables.
Un utilisateur actif simultané est un utilisateur ayant un document ouvert, y compris les sessions en lecture seule selon la définition du fournisseur.
Comptez systématiquement les sessions ouvertes avant de comparer les capacités.
Pourquoi une capture d'écran de la mémoire inactive n'est pas un point de référence
Une comparaison courante consiste à lancer les deux conteneurs, à n'ouvrir aucun document et à déclarer vainqueur celui qui consomme le moins de RAM. Cette méthode ne mesure que l'empreinte mémoire de base. Elle ne prend pas en compte les opérations essentielles : l'ouverture d'un fichier, sa conversion si nécessaire, l'affichage des pages ou des feuilles de calcul, la transmission des modifications, le recalcul des feuilles de calcul, la gestion de plusieurs éditeurs et l'enregistrement du résultat.
Le modèle de processus de Collabora permet de maintenir les processus enfants prêts à l'avance. Cela peut augmenter l'empreinte mémoire disponible tout en réduisant le délai avant qu'un document ne soit utilisable. ONLYOFFICE dissocie l'édition de documents des services tels que la conversion ; sa documentation d'architecture décrit l'éditeur de documents, le service d'édition, le service de commandes, le service de conversion et le service de création. Voir « Fonctionnement de la documentation ONLYOFFICE » . En d'autres termes, le flux RSS de base est une mesure opérationnelle utile, mais insuffisante pour prédire la vitesse perçue par l'utilisateur.
Une configuration de test équitable des ressources et de latence
Exécutez les deux produits l'un après l'autre sur le même hôte ou sur deux machines virtuelles configurées de manière identique. Évitez de tester l'un sur un hôte déjà chaud avec des fichiers en cache et l'autre immédiatement après le démarrage. Veillez à ce que la distribution Linux, la version de Docker, le quota de processeur, la limite de mémoire, la classe de stockage, le proxy inverse, la terminaison TLS, la version du navigateur et le chemin d'accès au stockage des documents soient identiques.
Utilisez trois charges de travail documentaires
Document texte : un fichier DOCX représentatif avec titres, tableaux, images, suivi des modifications et commentaires.
Feuille de calcul : un fichier XLSX contenant des formules, une mise en forme conditionnelle, plusieurs feuilles de calcul et suffisamment de données pour déclencher un recalcul pertinent.
Présentation : un fichier PPTX avec des images, des graphiques et plusieurs diapositives plutôt qu’une présentation presque vide.
Utilisez les mêmes fichiers pour les deux plateformes. Si un fichier nécessite une conversion de format dans un logiciel, notez-le, car cette conversion peut considérablement allonger le temps d'ouverture. N'optimisez pas un fichier spécifiquement pour un éditeur et n'utilisez pas ensuite le résultat pour une comparaison générale entre plateformes.
Testez à plusieurs niveaux de concurrence.
Une séquence pratique consiste à ouvrir simultanément 1, 5, 10 et 20 éditeurs, puis à augmenter progressivement le nombre d'utilisateurs jusqu'à atteindre le pic attendu. Un « utilisateur » doit désigner de la même manière un onglet d'éditeur avec le document entièrement ouvert. Répétez chaque niveau au moins trois fois après une phase d'échauffement et indiquez la médiane ainsi que le résultat le plus lent. Cela permet de réduire l'impact des pics de faible intensité sur les résultats.
Métriques de ressources à enregistrer
Docker fournit une première couche de télémétrie indépendante du fournisseur. La documentation officielle de Docker Stats explique que celle-ci docker statsfournit des rapports sur le pourcentage d'utilisation du processeur, l'utilisation de la mémoire, les E/S réseau, les E/S par blocs et les PID. Il est possible de capturer un flux en direct pendant l'exécution de la charge et un échantillon sans flux à des points de contrôle définis.
Pour chaque niveau de concurrence, enregistrez la mémoire inactive avant l'ouverture de tout document, la mémoire en régime permanent une fois tous les documents ouverts, l'utilisation maximale du processeur pendant l'ouverture, l'utilisation du processeur une fois les sessions stabilisées et la mémoire après la fermeture de chaque session. Observez également si la mémoire revient à un niveau proche de sa valeur de base après une période de refroidissement. Une valeur plus élevée après le test n'indique pas automatiquement une fuite de mémoire (les caches et la mémoire partagée peuvent rester fonctionnels), mais une augmentation continue de la valeur minimale sur des cycles identiques répétés justifie une investigation.
Ne comparez pas uniquement les pourcentages des conteneurs si l'un d'eux a une limite de processeur ou de mémoire différente. Notez les limites réelles de l'hôte ou du cgroup avec les résultats du test. La consommation de mémoire de Docker sous Linux présente également des subtilités liées au cache ; utilisez donc le même environnement Docker et cgroup pour les deux produits.
Comment mesurer la latence d'ouverture
Définissez la latence d'ouverture avant les tests. Une définition acceptable est le temps écoulé entre l'action d'ouverture de l'utilisateur et le moment où l'éditeur est visiblement prêt à recevoir la saisie et où le contenu du document est suffisamment stabilisé pour commencer à écrire. Mesurez le même indicateur pour les deux produits. Un simple enregistrement d'écran horodaté est plus comparable que de se fier aux événements internes spécifiques à chaque produit.
Collectez deux types de latence d'ouverture. L'ouverture à froid (ou « cold open ») se produit après le redémarrage du conteneur Office et la suppression de la session de test. L'ouverture à chaud (ou « warm open ») consiste à relancer le même fichier sans redémarrer le service. Le paramètre de pré-création de Collabora rend cette distinction particulièrement importante, car un plus grand nombre de processus enfants en attente peut réduire le délai de démarrage tout en augmentant la consommation de mémoire. Si vous modifiez ce paramètre num_prespawn_children, affichez sa valeur avec les résultats au lieu de la masquer.
Comment mesurer la latence de collaboration
Pour la coédition en temps réel, la mesure pertinente n'est pas un simple ping ICMP. Il faut mesurer le délai entre une modification effectuée dans le navigateur A et la modification visible dans le navigateur B. Utilisez deux profils de navigateur ou machines distincts et synchronisez leurs horloges. Enregistrez 20 à 50 modifications simples, comme l'ajout d'un caractère au même paragraphe, puis calculez le délai de propagation visible médian et le 95e percentile.
La description officielle de la coédition d'ONLYOFFICE confirme que les modifications sont transmises de l'éditeur au service d'édition de documents, puis à l'autre éditeur. Voir le flux de travail de coédition d'ONLYOFFICE . La configuration du serveur expose également les paramètres liés à WebSocket, notamment le comportement de reconnexion et la taille maximale de la charge utile, dans la documentation de référence de la configuration du serveur ONLYOFFICE . Collabora dépend également d'un trafic WebSocket persistant via le proxy inverse ; par conséquent, la mise en mémoire tampon du proxy, le comportement en cas de délai d'expiration, la terminaison TLS et le RTT réseau doivent être considérés comme faisant partie intégrante de l'environnement de test et non comme des détails techniques.
Ajouter un délai réseau contrôlé
Si vos utilisateurs travaillent à distance, répétez le test de collaboration avec une latence aller-retour contrôlée, par exemple d'environ 20 ms, 80 ms et 150 ms. Appliquez la même limitation de bande passante aux deux systèmes et documentez précisément son application. Cela mettra en évidence une différence que les tests de performance sur réseau local peuvent masquer : un éditeur peut se sentir parfaitement à l'aise avec une latence de 1 à 5 ms, mais la réactivité peut être nettement moins bonne pour les succursales ou les équipes internationales.
La latence de sauvegarde nécessite sa propre mesure
L'enregistrement ne se résume pas à la latence de saisie. ONLYOFFICE décrit un flux de travail où le service d'édition compile les modifications et envoie une notification au service de stockage une fois l'édition terminée. Sa documentation indique un délai de conversion par défaut de cinq secondes et précise que le temps final dépend également de la durée de conversion, de la complexité du fichier et des performances du serveur. Consultez la documentation ONLYOFFICE sur l'enregistrement de fichiers . Par conséquent, une observation indiquant que « l'enregistrement a pris plusieurs secondes » ne doit pas être automatiquement interprétée comme un délai d'interaction.
Pour les deux produits, mesurez le temps d'enregistrement à partir du moment où le dernier éditeur a terminé sa modification jusqu'à la confirmation de la mise à jour du fichier dans le stockage de base. Conservez le stockage sur le même chemin réseau et avec la même classe de disque. Un serveur Nextcloud, ownCloud, un stockage d'objets, une base de données ou un proxy inverse lent peut sinon être imputé à la suite bureautique.
Feuille de résultats : les chiffres qui comptent
Métrique
Record à
Pourquoi c'est important
Mémoire inactive
Aucun document ouvert
Coût de base pour les petits serveurs
Mémoire stable par charge de travail
1, 5, 10, 20+ éditeurs ouverts
Affiche un comportement de mise à l'échelle plus précis que le flux RSS inactif
Processeur de pointe
Lors de l'ouverture du document et du recalcul de la feuille de calcul
Révèle les exigences en matière de capacité de rupture
latence d'ouverture à froid
Après le redémarrage du service
Capture le coût de démarrage/de lancement de processus
latence d'ouverture à chaud
Ouverture de fichier répétée
Présente une réactivité normale lors de séances répétées
Modification de la propagation p50/p95
Coédition à deux utilisateurs
Mesures du retard de collaboration perçu
Sauvegarder l'achèvement
Le dernier éditeur ferme ou termine
Distingue le temps de persistance de la latence interactive
Comment interpréter le résultat
Si Collabora utilise davantage de mémoire inactive dans votre configuration, mais réduit la latence d'ouverture à froid, ce compromis peut être acceptable si les utilisateurs ouvrent fréquemment des documents et que le serveur dispose de RAM disponible. Si ONLYOFFICE affiche une consommation de base plus faible, mais des pics d'utilisation du processeur plus importants lors de la conversion, la marge de manœuvre du processeur peut s'avérer plus importante que la mémoire. Les schémas inverses sont également possibles ; l'important est d'associer chaque courbe de ressources à un événement visible pour l'utilisateur.
Pour une petite installation auto-hébergée, concentrez-vous sur l'empreinte mémoire en veille, le temps de première ouverture et la fréquence d'utilisation du swap (un ou deux documents volumineux). Pour un déploiement en entreprise avec des dizaines d'éditeurs actifs, privilégiez la vitesse de croissance de la mémoire, la saturation du processeur, le délai de coédition p95 et la récupération après une charge importante. Pour les utilisateurs répartis géographiquement, le RTT réseau et la configuration du proxy peuvent compenser de légères différences côté serveur.
Le produit le plus performant est donc celui qui respecte vos contraintes de CPU et de RAM tout en atteignant votre objectif de latence sur vos documents réels. Les pages de dimensionnement fournies par les constructeurs ne sont qu'un point de départ, et non des résultats de tests comparatifs. Exécutez la même charge de travail, maintenez un environnement contrôlé, publiez votre configuration de test à côté des résultats et évitez de généraliser une simple mesure de la mémoire inactive pour conclure à une performance globale.