How to Connect ONLYOFFICE Desktop Editors to an ownCloud Server

Connect ONLYOFFICE Desktop Editors to your ownCloud server, sign in, open cloud files, manage the connection, and troubleshoot common setup issues.
Collabora Online が突然サーバーの CPU の大部分を使用するようになった場合、最初に行うべき最も重要な手順は、サーバーを繰り返し再起動したり、すぐに非常に低い CPU 制限を設定したりしないことです。まず、負荷の原因が通常のドキュメント作業、異常なドキュメントセッション、並列処理の過剰、クリーンアップされていないアイドルセッション、またはバージョン固有の不具合のいずれであるかを判断します。プロセス名は、coolwsd最新リリースとloolwsd古いインストールの両方で異なる場合があります。
具体例として、 Nextcloudの背後でCollabora Onlineを実行している8vCPUサーバーを想像してみてください。ドキュメントを編集しているユーザーはごく少数ですが、CollaboraコンテナのCPU使用率は数分間250%から350%程度にとどまります。これはこのガイド全体を通して使用されている架空の例であり、実際の運用環境での測定ベンチマークやレポートではありません。
2026年10月現在、Collaboraの最新安定版ブランチは26.04で、公式リリースノートにはCollabora Online 26.04.3.3が2026年9月14日にリリースされたと記載されています。現在の構成テンプレートではこのcoolwsd名前が使用されています。Collaboraの移行ツールには、6.4以前のインストール用の古い/etc/loolwsd/loolwsd.xmlパスがまだ記載されているため、管理者は両方の名前を目にする可能性があります。
オペレーティングシステムまたはコンテナレベルから始めましょう。横に高い数値が表示されていても、coolwsd必ずしもコーディネーションデーモン自体がすべての負荷の高いドキュメント処理を行っているとは限りません。Collaboraはドキュメントセッションのためにkit/forkitプロセスも実行するため、設定を変更する前にプロセスツリーとプロセスごとのCPU使用率を確認する必要があります。
ps -eo pid,ppid,pcpu,pmem,etime,cmd --sort=-pcpu | head -n 25
top -H -p $(pgrep -d, -f 'coolwsd|loolwsd|coolkit|loolkit|forkit')
Dockerの場合、コンテナ全体も確認してください。
docker stats --no-stream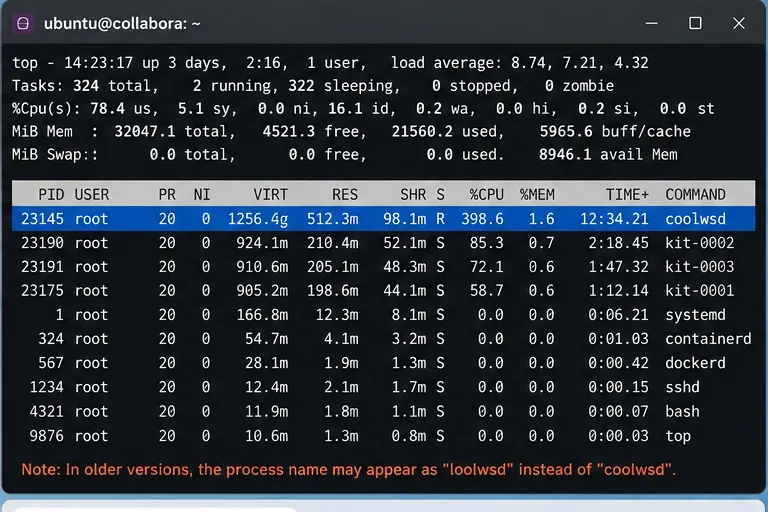
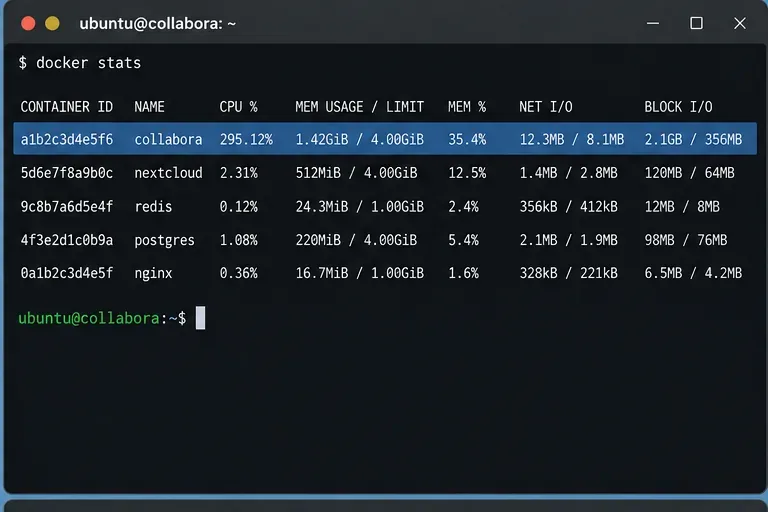
具体例として、コンテナのCPU使用率が300%近くになり、キットプロセスが常にプロセスリストの上位に表示されているとします。これは、サーバー全体が過負荷状態にあるという一般的な推測ではなく、特定のドキュメントセッションがアクティブになっていることを示唆しています。
Collabora Online は、Prometheus 互換のメトリクスを で公開しています/cool/getMetrics。現在の SDK マニュアルによると、このエンドポイントでは、CPU とメモリの使用状況、実行中のキットプロセス、ビュー、その他のサーバー使用状況データを報告できます。認証なしでのアクセスが明示的に設定されていない限り、管理コンソールと同じ認証方式が使用されます。
トラブルシューティングを簡略化するためだけに、メトリクスエンドポイントを公開しないでください。公式のHelm設定には、/cool/getMetricsイングレスでのブロックURLと管理URLの例も含まれています。可能な限り、認証済みの内部パスを使用してください。
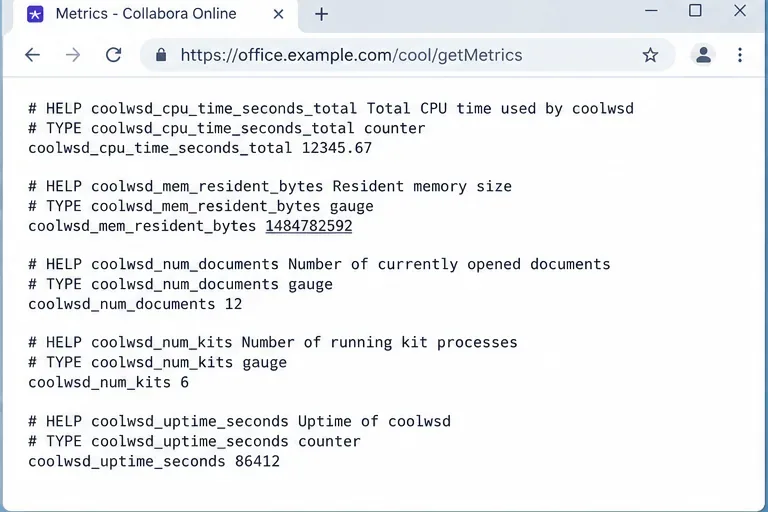
CPU使用率とアクティブなドキュメントまたはビューとの関係を調べてください。正当な編集作業に伴ってCPU使用率が上昇・下降する場合は、処理能力または同時実行性に問題がある可能性があります。対応するインタラクティブな作業がないにもかかわらずCPU使用率が高いままの場合は、古いセッション、問題のあるドキュメント、繰り返し実行されるバックグラウンド作業、またはソフトウェアの問題を調査してください。
systemdによって管理されるパッケージのインストールの場合:
journalctl -u coolwsd --since "15 minutes ago" --no-pager
journalctl -u coolwsd -f
Dockerの場合:
docker logs collabora --since 15m
docker logs -f collabora
サービスまたはコンテナに別の名前が付いている場合は、その名前に置き換えてください。ドキュメントの読み込みの繰り返し、キットの作成の繰り返し、保存の失敗、クラッシュ、再接続ループ、または同じドキュメントキーが繰り返し出現するなどのエラーがないか確認してください。ドキュメントのオープン、再計算、レンダリング、変換、エクスポート中に一時的にCPU使用率が高くなるのは正常な動作の場合があります。より深刻な警告サインは、CPU使用率が継続的に高いにもかかわらず、有用な処理が進まない、または同じエラーが繰り返される場合です。
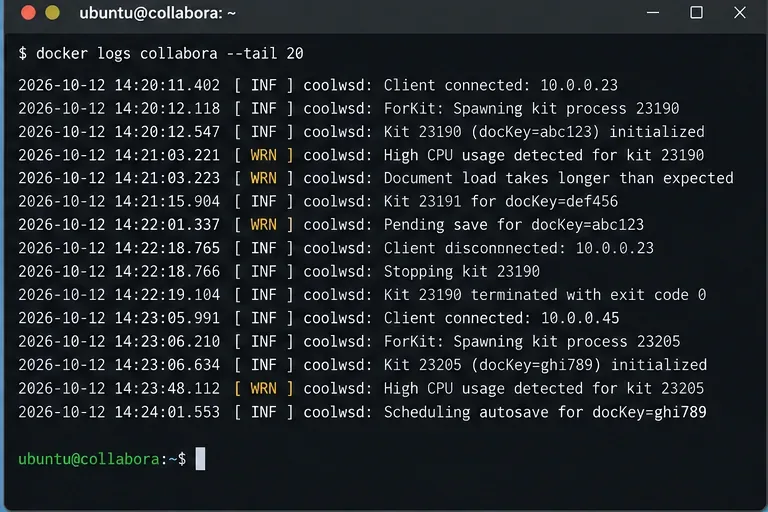
仮想サーバーに戻ります。キットプロセスのいずれかが高負荷状態にある場合は、疑わしいドキュメントを閉じるか隔離し、CPU使用率が低下するかどうかを確認します。次に、プロセスリストとメトリクスを監視しながら、静かな時間帯に同じファイルを開きます。簡単なテストドキュメントを使用して、この手順を繰り返します。
この比較は、サービス全体を即座に再起動するよりも有用です。
現在のCollabora構成テンプレートでは、per_document.max_concurrencyドキュメント処理中に使用されるスレッドの最大数を規定しています。テンプレートのデフォルト値は4です。ホストの規模が小さい場合や、複雑なドキュメント1つがマシンの処理能力を占有してしまう可能性がある場合は、この値を減らすことでCPU使用率をより予測しやすくなります。
例えば、値2をテストすることができます。
<per_document>
    <max_concurrency>2</max_concurrency>
</per_document>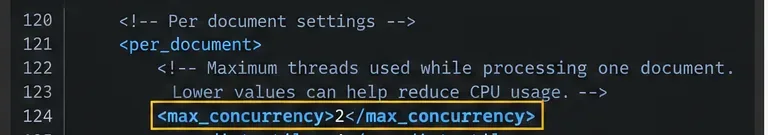
数字の2を盲目的にコピーしないでください。ユーザーが日常的に大規模なスプレッドシートやプレゼンテーションを操作し、サーバーに十分なコア数がある場合、低い値を設定すると処理速度が低下する可能性があります。設定を1つ変更し、同じワークロードを再現して、CPU、応答性、および完了時間を比較してください。
現在のcoolwsd.xmlテンプレートには、リソースを大量に消費するアイドル状態のドキュメントをクリーンアップするロジックが含まれています。執筆時点では、クリーンアップチェックの間隔は10,000ミリ秒、異常動作期間は60秒、アイドル状態のしきい値は300秒、CPU使用率が85%を超えた場合にドキュメントがクリーンアップ対象となります。また、ドキュメントごとのアイドルタイムアウトは3,600秒です。
同じテンプレートには、ビューごとのタイムアウト設定が含まれています。現在の設定では、フォーカスが外れたブラウザビューが暗くなり更新が停止するまで300秒、非アクティブなビューが同様に処理されるまで900秒となっています。これらのビュータイムアウトは、ドキュメントセッション全体を即座にアンロードすることとは異なります。

グラフの見栄えを良くするためだけに、CPUしきい値を極端に低く設定することは避けてください。クリーンアップの目的は、リソースを大量に消費する不良ドキュメントやアイドル状態のドキュメントを検出することであり、通常の編集作業が計算負荷の高いものになったからといって終了させることではありません。
まず、現在アクティブな設定をバックアップしてください。パッケージのインストールでは通常、. を使用します/etc/coolwsd/coolwsd.xml。Docker デプロイメントでは、環境変数またはコマンドラインのオーバーライドとしてオプションを渡したり、設定ファイルをコンテナにマウントしたりする場合があります。編集する前に、実際にどのソースがアクティブになっているかを確認してください。
パッケージのインストール方法:
sudo cp /etc/coolwsd/coolwsd.xml /etc/coolwsd/coolwsd.xml.before-cpu-tuning
sudo systemctl restart coolwsd
systemctl status coolwsd --no-pager
Dockerコンテナの場合:
docker restart collabora
docker ps --filter name=collabora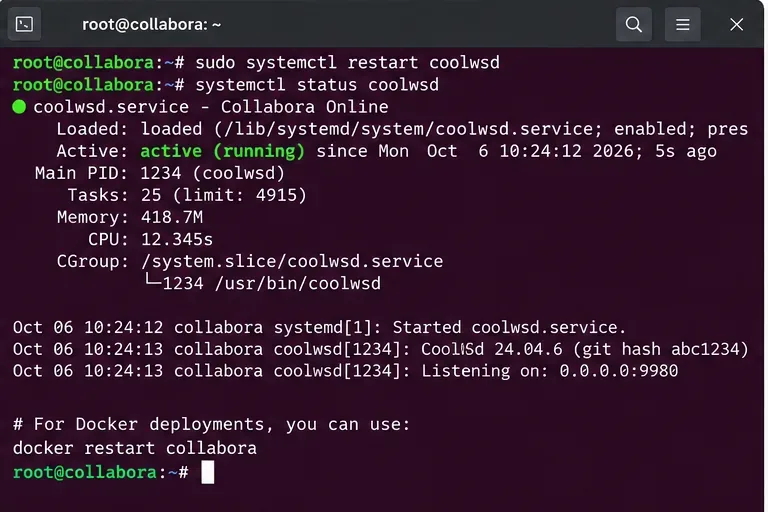
再起動だけで一時的にCPUの問題が解消されても、問題が繰り返し再発する場合は、それは診断情報であって、恒久的な解決策ではありません。どのようなワークロードや状態が再発の原因となっているのかを説明できるまで、調査を続けてください。
同じドキュメント、ほぼ同じユーザー数、同じ操作手順を使用してください。単一の瞬間を比較するのではなく、数分間測定してください。この例のシナリオでは、再現されたワークロード中にサーバーが飽和状態を維持せず、ドキュメントの開き、編集、保存、およびコラボレーションが許容範囲内で動作する状態が成功とみなされます。
| 観察 | 考えられる次の行動 |
|---|---|
| 1つの文書またはキットが熱いまま | そのファイルを使って再現し、ログを保存して、現在の安定版マイクロリリースでテストしてください。 |
| CPUはアクティブユーザー数を追跡します | 負荷を漏洩として扱うのではなく、容量、同時実行性、およびデプロイメントのサイジングを見直してください。 |
| ユーザーが退出した後もCPU使用率が高いまま | アイドル状態のドキュメント、クリーンアップの動作、繰り返されるバックグラウンドジョブ、および孤立したキットや再起動中のキットを検査します。 |
| アップグレード直後からスパイクが発生しました | 多くのチューニング値を変更する前に、正確なバージョンを記録し、最新のリリースノートと既知の問題を確認してください。 |
| max_concurrencyを下げるとCPU使用率は下がりますが、編集速度が遅くなります。 | 徐々に増やすか、CPU容量を追加するかのどちらかです。この設定はトレードオフであり、万能な解決策ではありません。 |
特定の Collabora バージョンで問題が発生し、特定のファイルまたは操作で再現できる場合は、設定の調整だけではソフトウェアの不具合を隠蔽するだけかもしれません。Collabora では、現在の安定版ブランチの最新バージョンを使用することをお勧めします。2026 年 10 月 7 日現在、公式の 26.04 リリース ノート ページには、最新の Collabora Online リリースとして 26.04.3.3 が記載されています。
CODEユーザーの皆様へ:Collaboraは、開発版は小規模チーム、家庭での使用、開発、新機能の試用に適していると説明しており、本番環境での使用を想定していないことをご留意ください。そのため、CODEで本番環境における問題が発生した場合は、開発版の動作を延々と調整するよりも、サポート対象のCollabora Online製品に移行する方が賢明な選択となる可能性があります。
coolwsd数値が大きいからといって、メモリリークや無限ループが発生していると決めつけないでください。coolwsd、古いプロセスloolwsd、または子キット/フォークキットプロセスであるかどうかを確認してください。per_document.max_concurrency1つのドキュメントが並列CPUを過剰に使用している場合にのみテストしてください。このガイドに記載されている設定の詳細は、現在の Collabora Online ソース テンプレート ( Collabora Online coolwsd.xml 設定テンプレート)に基づいています。公式 SDK マニュアルには、ログ記録、パフォーマンス制御、および Prometheus 互換のメトリクス エンドポイントについて記載されています ( Collabora Online SDK マニュアル)。バージョンを確認するには、メーカーのCollabora Online 26.04 リリース ノートを参照してください。開発版の想定される使用方法については、公式のCODE 26.04 リリース アナウンスを参照してください。
実際の目標は、Collabora OnlineのCPU使用率を可能な限り低く抑えることではありません。編集やコラボレーションのパフォーマンスを許容範囲内に保ちつつ、CPU使用率を説明可能で、かつ有用な作業量に見合ったものにすることです。
Connect ONLYOFFICE Desktop Editors to your ownCloud server, sign in, open cloud files, manage the connection, and troubleshoot common setup issues.
Collabora OnlineのCPU使用率が高い場合、ビジー状態のキットプロセスを特定し、メトリクスとログを確認し、同時実行性とクリーンアップを調整し、修正が安全に行われたことを検証することで、トラブルシューティングを行います。
ONLYOFFICE Docsをヘッダーロゴやインターフェースカラーでカスタマイズする方法を学びましょう。ライセンス制限、テーマJSONの設定、Dockerパス、テスト方法なども解説します。
LibreOffice Calc で読みにくいテキストを修正するには、アプリのテーマ、セルのフォントと塗りつぶしの色、スタイル、条件付き書式設定を確認し、印刷出力を検証してください。
LibreOfficeの不明ユーザーによるロック警告を安全に解除します。アクティブなセッションを確認し、コピーを保護し、検証済みの古いロックのみを削除して、ドキュメントをテストします。
LibreOffice Writerで、アラビア語またはヘブライ語のテキストが英語と正しく並ばず、位置がずれたり、混ざり合ったりする場合を修正します。複雑なテキストレイアウトを有効にし、段落の方向を設定して、結果を確認してください。
Learn VLOOKUP and XLOOKUP in LibreOffice Calc, including exact matches, left lookups, not-found results, reverse search, INDEX/MATCH alternatives, and common errors.
Collabora OnlineのWOPI認証検証エラーのトラブルシューティングを行うには、検出キー、キーローテーション、プロキシURL、タイムスタンプ、ホスト許可リストを確認してください。
ONLYOFFICEドキュメントで全員に対して変更履歴の記録を有効にし、再度開いた後もアクティブな状態を維持する方法、およびグローバルなデフォルト設定の制限事項を理解してください。
Collabora Onlineのビューごとのタイムアウト、フォーカスが外れた状態のタイムアウト、ドキュメントがアイドル状態のタイムアウト、自動保存のタイムアウト、プロキシのタイムアウトを比較し、導入環境に適した設定を選択して確認してください。




