Início
» ESCRITÓRIO MS
»
Collabora Online vs ONLYOFFICE: Teste de Uso de Recursos e Latência
Collabora Online vs ONLYOFFICE: Teste de Uso de Recursos e Latência
A escolha entre o Collabora Online e o ONLYOFFICE Docs costuma ser apresentada como uma questão de funcionalidade ou formato de arquivo, mas as equipes de infraestrutura geralmente se deparam com uma segunda decisão após a implementação: quanta CPU e memória cada solução consome e qual a capacidade de resposta da edição à medida que o tempo de resposta e a concorrência aumentam? Não existe um número universal confiável para nenhum dos produtos, pois a complexidade do documento, as fontes, o trabalho de conversão, a latência de armazenamento, o comportamento do navegador, os proxies reversos e o número de documentos abertos simultaneamente influenciam o resultado.
Até outubro de 2026, nenhum dos fornecedores publicou um benchmark comparativo direto e atualizado com o outro. Isso é importante. Uma comparação justa deve, portanto, separar dois tipos de evidência: as orientações de dimensionamento do fornecedor, que indicam o que cada projeto espera que você provisione, e um teste repetível de latência/recursos executado em hardware idêntico. O plano de testes abaixo foi desenvolvido para gerar números que você pode usar em sua própria implementação, sem presumir que um único resultado de laboratório se aplica a todos os casos.
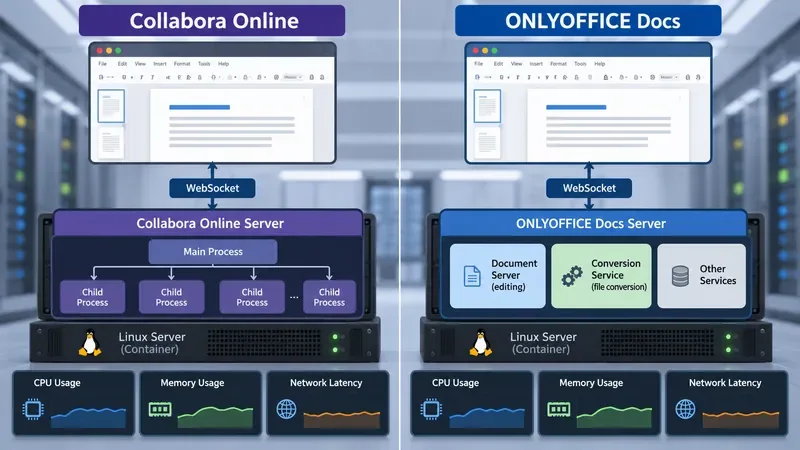
Um layout de comparação lado a lado para o Collabora Online e o ONLYOFFICE Docs. Os painéis de monitoramento mostram as métricas a serem coletadas — CPU, memória e latência de rede — em vez dos valores de referência medidos.
O que diz realmente a orientação oficial sobre recursos.
Os fornecedores publicam informações úteis sobre dimensionamento, mas os valores não são diretamente equivalentes. O manual do SDK da Collabora inclui um exemplo de produção com Kubernetes/Helm que recomenda solicitações de recursos de 4 CPUs e 6 GiB de memória, com limites de 8 CPUs e 8 GiB. O mesmo manual descreve o recurso `session_ready` num_prespawn_children, que mantém os processos filhos prontos para que novas sessões possam ser iniciadas mais rapidamente, ao custo de memória adicional. Consulte o manual do SDK do Collabora Online . O modelo de configuração atual da Collabora também expõe um limite de proporção de memória e controles de concorrência por documento; o código-fonte oficial do projeto está disponível no modelo de configuração do Collabora Online .
A ONLYOFFICE publica níveis de referência mais explícitos para o Docs Community Edition no Docker. Suas diretrizes atuais indicam 4 GB de RAM ou mais e listam configurações de referência com um núcleo de 2,8 GHz para menos de 100 usuários ativos simultâneos, dois núcleos para 100 a 200 e quatro núcleos para 200 a 400, mantendo 4 GB de RAM nessas configurações. O fornecedor alerta explicitamente que a capacidade real depende do número, tipo e tamanho dos documentos. Consulte os requisitos do Docker para o ONLYOFFICE Docs Community Edition .
Área
Colabore online
Documentos ONLYOFFICE
Para concluir, o que dizer?
Dimensionamento de produção publicado
O exemplo do SDK Helm recomenda 4 CPUs / 6 GiB solicitados, com limites máximos de 8 CPUs / 8 GiB.
A configuração de referência do Docker começa com 4 GB de RAM; os níveis de CPU escalam de acordo com o número de usuários ativos simultâneos.
Não classifique nenhum dos produtos como "mais leve" apenas com base nesses números; as premissas de implementação são diferentes.
comportamento de inicialização a quente
Processos filhos pré-criados podem trocar memória por inicializações de sessão mais rápidas.
Vários serviços do lado do servidor lidam com edição, conversão, comandos e construção de documentos.
O consumo de memória ociosa e a latência da primeira abertura podem refletir a arquitetura e o ajuste, e não apenas a eficiência do editor.
Modelo de concorrência
O processamento por documento possui controles de simultaneidade configuráveis.
Um usuário ativo simultâneo é um usuário com um documento aberto, incluindo sessões somente para visualização, conforme a definição do fornecedor.
Conte as sessões abertas de forma consistente antes de comparar a capacidade.
Por que uma captura de tela da memória ociosa não é um benchmark?
Uma comparação comum é iniciar ambos os contêineres, sem abrir nenhum documento, e declarar o que apresentar menor consumo de RAM como vencedor. Isso mede apenas o consumo básico de recursos. Ignora o trabalho que realmente importa: abrir um arquivo, convertê-lo quando necessário, renderizar páginas ou planilhas, transmitir alterações, recalcular planilhas, atender a vários editores e salvar o resultado de volta no armazenamento.
O modelo de processos do Collabora permite manter os processos filhos prontos com antecedência. Isso pode aumentar o tempo ocioso e, ao mesmo tempo, reduzir o atraso antes que um documento se torne utilizável. O ONLYOFFICE separa a edição de documentos de serviços como a conversão; sua documentação de arquitetura descreve o editor de documentos, o serviço de edição, o serviço de comandos, o serviço de conversão e o serviço de construção. Consulte Como o ONLYOFFICE Docs funciona . Em outras palavras, o RSS de referência é uma métrica operacional útil, mas não é suficiente para prever a velocidade visível ao usuário.
Uma configuração justa para testes de recursos e latência.
Execute os dois produtos um de cada vez no mesmo host ou em duas VMs provisionadas de forma idêntica. Evite testar um em um host já aquecido com arquivos em cache e o outro imediatamente após a inicialização. Mantenha a distribuição Linux, a versão do Docker, a cota de CPU, o limite de memória, a classe de armazenamento, o proxy reverso, a terminação TLS, a versão do navegador e o caminho de armazenamento de documentos idênticos.
Utilize três cargas de trabalho de documentos
Documento de texto: um DOCX representativo com títulos, tabelas, imagens, controle de alterações e comentários.
Planilha: um arquivo XLSX com fórmulas, formatação condicional, várias planilhas e dados suficientes para gerar um recálculo significativo.
Apresentação: um arquivo PPTX com imagens, gráficos e vários slides, em vez de uma apresentação quase vazia.
Use os mesmos arquivos para ambas as plataformas. Se um arquivo exigir conversão de formato em um dos produtos, registre esse fato, pois a conversão pode consumir grande parte do tempo de execução. Não otimize um arquivo especificamente para um editor e depois considere o resultado como uma comparação geral entre plataformas.
Teste em mais de um nível de concorrência
Uma sequência prática consiste em abrir simultaneamente 1, 5, 10 e 20 editores, seguida por um nível mais alto que corresponda ao pico esperado. O termo "usuário" deve se referir à mesma coisa em todas as execuções: uma aba do editor com o documento totalmente aberto. Repita cada nível pelo menos três vezes após uma execução de aquecimento e relate a mediana mais o resultado mais lento. Isso reduz a probabilidade de picos de fundo curtos distorcerem a conclusão.
Métricas de recursos a serem registradas
O Docker fornece uma primeira camada de telemetria independente de fornecedor. A documentação oficial do Docker Stats explica que docker statsele reporta a porcentagem de CPU, uso de memória, E/S de rede, E/S de bloco e PIDs. Capture tanto um fluxo de dados ao vivo durante a carga de trabalho quanto uma amostra sem fluxo em pontos de verificação definidos.
Para cada nível de concorrência, registre a memória ociosa antes de abrir qualquer item, a memória em estado estável após todos os documentos estarem abertos, o pico de uso da CPU durante a abertura, o uso da CPU após a estabilização das sessões e a memória após o fechamento de cada sessão. Observe também se a memória retorna a valores próximos ao seu nível basal após um período de resfriamento. Um valor pós-teste mais alto não indica automaticamente um vazamento — caches e memória compartilhada podem continuar sendo úteis —, mas um aumento contínuo do consumo mínimo em ciclos idênticos repetidos merece investigação.
Não compare apenas as porcentagens de contêineres se um contêiner tiver um limite de CPU ou memória diferente. Registre os limites reais do host ou do cgroup juntamente com os resultados do benchmark. O valor de memória do Docker no Linux também apresenta nuances de contabilização de cache, portanto, use o mesmo ambiente Docker e cgroup para ambos os produtos.
Como medir a latência de abertura
Defina a latência de abertura antes de testar. Uma definição adequada é o tempo decorrido desde a ação de abertura do usuário até que o editor esteja visivelmente pronto para entrada de dados e o conteúdo do documento esteja estável o suficiente para iniciar a digitação. Meça o mesmo indicador para ambos os produtos. Uma simples gravação de tela com registros de data e hora pode ser mais comparável do que depender de eventos internos específicos de cada produto.
Colete duas formas de latência de abertura. A abertura a frio inicia após a reinicialização do contêiner do Office e o encerramento da sessão de teste. A abertura a quente repete o mesmo arquivo sem reiniciar o serviço. A configuração de pré-inicialização do Collabora torna essa distinção especialmente importante, pois mais processos filhos em espera podem reduzir o atraso de inicialização, embora aumentem o uso de memória. Se você ajustar esse parâmetro num_prespawn_children, liste seu valor junto com os resultados, em vez de ocultá-lo.
Como medir a latência de colaboração
Para edição colaborativa em tempo real, a métrica relevante não é o ping ICMP comum. Meça o atraso entre uma edição no navegador A e a alteração visível no navegador B. Use dois perfis de navegador ou máquinas diferentes e sincronize seus relógios. Registre de 20 a 50 edições simples, como adicionar um caractere ao mesmo parágrafo, e calcule a mediana e o percentil 95 do atraso de propagação visível.
A descrição oficial da coedição do ONLYOFFICE confirma que as alterações são transmitidas do editor para o serviço de edição de documentos e, em seguida, para o outro editor. Consulte o fluxo de trabalho de coedição do ONLYOFFICE . A configuração do servidor também expõe as configurações relacionadas ao WebSocket, incluindo o comportamento de reconexão e o tamanho máximo da carga útil, na referência de configuração do servidor ONLYOFFICE . O Collabora também depende do tráfego persistente de WebSocket por meio do proxy reverso; portanto, o buffer do proxy, o comportamento de tempo limite, a terminação TLS e o RTT da rede devem ser tratados como parte do ambiente de teste, e não como detalhes de fundo.
Adicionar atraso de rede controlado
Se seus usuários estiverem remotos, repita o teste de colaboração com latência de ida e volta controlada, como aproximadamente 20 ms, 80 ms e 150 ms. Aplique o mesmo controle de rede a ambos os sistemas e documente exatamente onde ele é implementado. Isso revela uma diferença que os benchmarks de LAN local podem ocultar: um editor pode ter uma experiência excelente com RTT de 1 a 5 ms, mas uma experiência visivelmente menos imediata para filiais ou equipes internacionais.
A latência de salvamento precisa de sua própria medição.
O processo de salvar não é idêntico à latência de digitação. A documentação do ONLYOFFICE descreve um fluxo de trabalho no qual o serviço de edição compila as alterações e envia um retorno de chamada ao serviço de armazenamento após o término da edição; sua documentação indica um atraso padrão de cinco segundos no início da conversão e afirma que o tempo final também depende do tempo de conversão, da complexidade do arquivo e do desempenho do servidor. Consulte a documentação do ONLYOFFICE sobre como salvar arquivos . Isso significa que a observação de que "o salvamento levou vários segundos" não deve ser interpretada automaticamente como latência interativa.
Para ambos os produtos, meça o tempo de conclusão do salvamento a partir do momento em que o último editor termina até que o arquivo atualizado seja confirmado no armazenamento de backup. Mantenha o armazenamento no mesmo caminho de rede e classe de disco. Uma lentidão no Nextcloud, ownCloud, armazenamento de objetos, banco de dados ou proxy reverso pode ser atribuída ao pacote de escritório.
Folha de resultados: os números que importam
Métrica
Registro em
Por que isso importa
Memória ociosa
Nenhum documento aberto
Custo básico para servidores pequenos
Memória estável por carga de trabalho
1, 5, 10, 20+ editores abertos
Apresenta um comportamento de escalabilidade melhor do que o RSS ocioso.
Pico de CPU
Durante a abertura do documento e o recálculo da planilha
Revela os requisitos de capacidade de pico.
Latência de abertura a frio
Após a reinicialização do serviço
Captura o custo de inicialização/geração de processos
Latência de abertura quente
Abertura repetida de arquivo
Apresenta resposta normal em sessões repetidas.
Editar propagação p50/p95
Coedição por dois usuários
Mede a percepção de atraso na colaboração.
Salvar conclusão
O último editor fecha ou termina.
Separa o tempo de persistência da latência interativa.
Como interpretar o resultado
Se o Collabora utiliza mais memória ociosa na sua configuração, mas apresenta menor latência de inicialização a frio, isso pode ser uma troca aceitável caso os usuários abram documentos com frequência e o servidor tenha RAM disponível. Se o ONLYOFFICE apresentar uma linha de base mais baixa, mas picos de CPU mais acentuados durante a conversão, a capacidade de processamento da CPU pode ser mais importante do que a memória. Os padrões opostos também são possíveis; o objetivo é conectar cada curva de recursos a um evento visível para o usuário.
Para uma pequena instalação auto-hospedada, concentre-se no consumo de memória ociosa, no tempo de abertura da primeira página e se um ou dois documentos grandes causam troca de memória. Para uma implementação empresarial com dezenas de editores ativos, priorize a taxa de crescimento da memória, a saturação da CPU, o atraso na coedição do p95 e a recuperação após a carga. Para usuários geograficamente distribuídos, o RTT da rede e a configuração do proxy podem ser mais importantes do que pequenas diferenças no servidor.
O produto mais útil, portanto, é aquele que se mantém dentro do seu limite de CPU e RAM, atendendo à sua meta de latência em seus documentos reais. As páginas de dimensionamento dos fornecedores são pontos de partida, não resultados de benchmarks. Execute a mesma carga de trabalho, mantenha o ambiente controlado, publique sua configuração de teste junto com os números e evite generalizar uma única leitura de memória ociosa para uma afirmação sobre o desempenho geral.