Início
» ESCRITÓRIO MS
»
Como corrigir o alto uso da CPU no Collabora Online causado pelo loolwsd / coolwsd
Como corrigir o alto uso da CPU no Collabora Online causado pelo loolwsd / coolwsd
Quando o Collabora Online repentinamente passa a utilizar a maior parte da CPU de um servidor, o primeiro passo mais importante é não reiniciá-lo repetidamente nem impor imediatamente um limite de CPU muito baixo. Primeiramente, determine se a carga provém de trabalho normal com documentos, de uma sessão de documento com problemas, de excesso de trabalho paralelo, de uma sessão ociosa que não está sendo finalizada ou de uma regressão específica da versão. O nome do processo pode variar tanto coolwsdem versões atuais quanto loolwsdem instalações mais antigas.
Cenário ilustrativo: imagine um servidor com 8 vCPUs executando o Collabora Online por trás do Nextcloud. Aparentemente, apenas algumas pessoas estão editando documentos, mas o contêiner do Collabora permanece com uso de CPU entre 250% e 350% por vários minutos. Este é um exemplo hipotético usado ao longo deste guia, não um benchmark medido ou um relatório de uma implementação real.
Em outubro de 2026, a versão estável atual do Collabora é a 26.04, e as notas de lançamento oficiais listam o Collabora Online 26.04.3.3 como lançado em 14 de setembro de 2026. Os modelos de configuração atuais usam o coolwsdnome. As ferramentas de migração do Collabora ainda documentam o caminho antigo /etc/loolwsd/loolwsd.xmlpara instalações da era 6.4 ou anteriores, razão pela qual os administradores ainda podem encontrar ambos os nomes.
1. Confirme qual processo está realmente consumindo CPU.
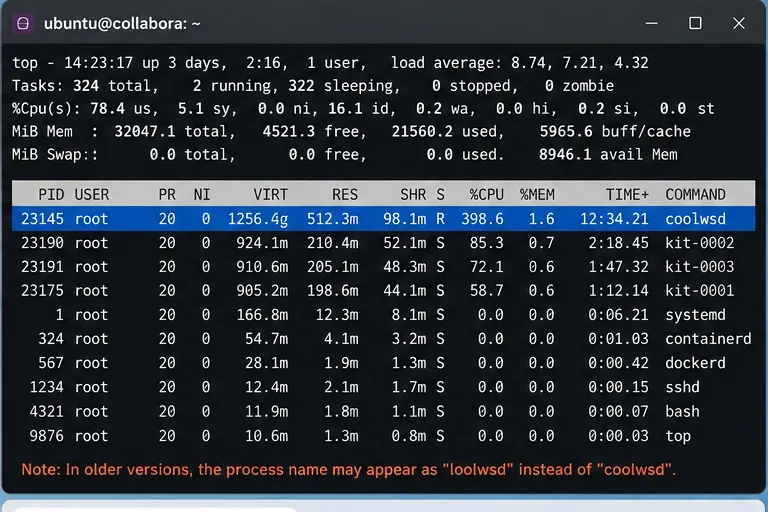
Comece pelo nível do sistema operacional ou do contêiner. Um número alto ao lado coolwsdnão significa automaticamente que o daemon coordenador esteja realizando todo o trabalho pesado de documentos. O Collabora também executa processos kit/forkit para sessões de documentos, portanto, você precisa verificar a árvore de processos e o uso da CPU por processo antes de alterar a configuração.
ps -eo pid,ppid,pcpu,pmem,etime,cmd --sort=-pcpu | head -n 25
top -H -p $(pgrep -d, -f 'coolwsd|loolwsd|coolkit|loolkit|forkit')
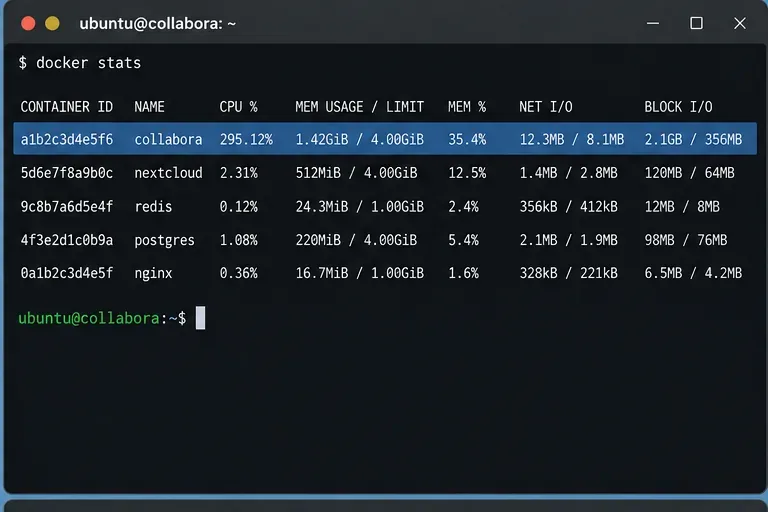
Para o Docker, verifique também o contêiner como um todo:
docker stats --no-stream
Uma visão em nível de processo ajuda a separar o daemon principal do Collabora dos processos do kit relacionados a documentos antes de qualquer tentativa de ajuste.O uso da CPU em nível de contêiner é útil para confirmar se o Collabora é a fonte da carga do host, mas não identifica o documento ou processo filho responsável.
No cenário ilustrativo, suponha que o contêiner esteja com uso de CPU próximo a 300% e que um processo específico esteja constantemente no topo da lista de processos. Isso indica uma sessão de documento ativa específica, em vez de uma suposição genérica de que todo o servidor está sobrecarregado.
2. Verifique as métricas da própria Collabora em vez de confiar apenas nas métricas dos principais fornecedores.
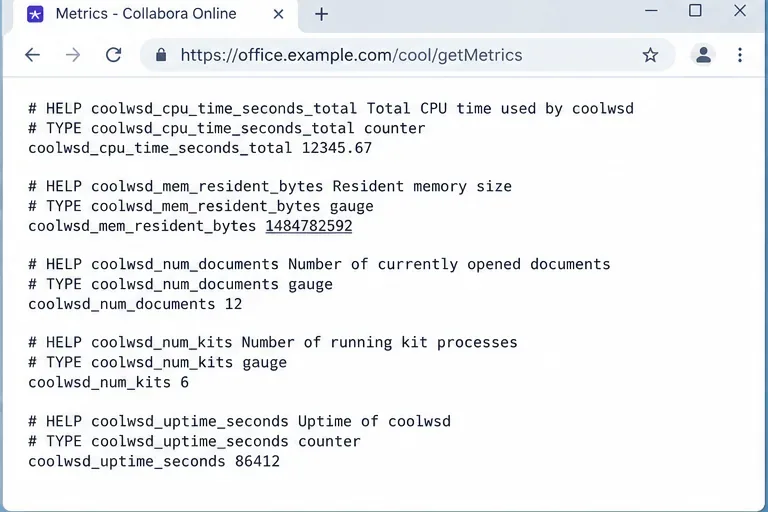
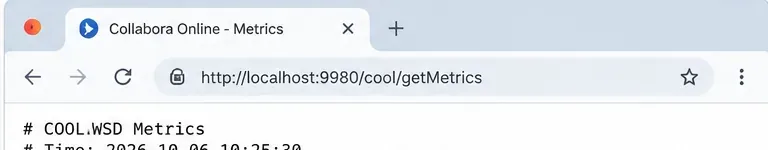
O Collabora Online expõe métricas compatíveis com o Prometheus em /cool/getMetrics. O manual atual do SDK indica que esse endpoint pode reportar o uso de CPU e memória, processos do kit em execução, visualizações e outros dados de uso do servidor. Ele utiliza a mesma autenticação do console de administração, a menos que as métricas sejam explicitamente configuradas para acesso não autenticado.
Não exponha o endpoint de métricas publicamente apenas para simplificar a resolução de problemas. A configuração oficial do Helm inclui exemplos de /cool/getMetricsURLs de bloqueio e administração em um ponto de entrada. Sempre que possível, utilize um caminho interno e autenticado.
O endpoint de métricas do Collabora fornece contexto do lado do servidor que complementa as medições de CPU do Linux ou do Docker.
Procure por uma relação entre o uso da CPU e os documentos ou visualizações ativos. Se o uso da CPU aumentar e diminuir com atividades legítimas de edição, você pode ter um problema de capacidade ou de concorrência. Se o uso da CPU permanecer alto sem nenhuma atividade interativa correspondente, investigue sessões antigas, um documento problemático, tarefas em segundo plano repetitivas ou um problema de software.
3. Leia os registros exatamente no momento em que o uso da CPU aumenta.
Para uma instalação de pacote gerenciada pelo systemd:
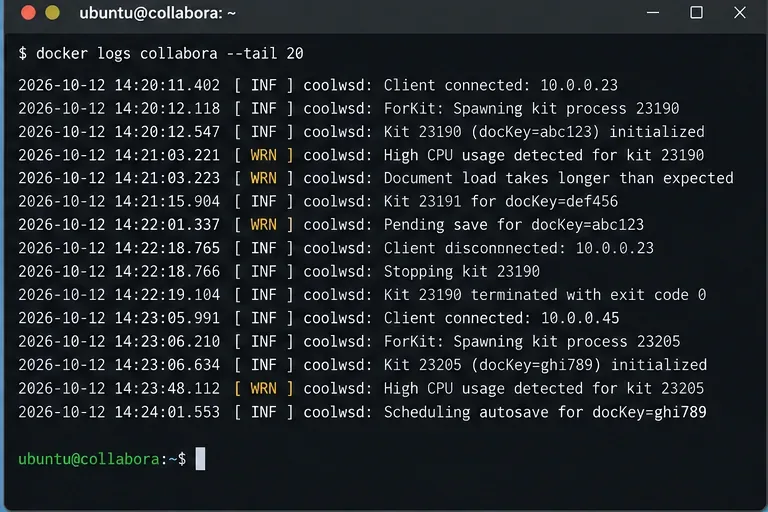
Se o seu serviço ou contêiner tiver um nome diferente, substitua-o. Procure por carregamentos repetidos de documentos, criação repetida de kits, falhas ao salvar, travamentos, loops de reconexão ou a mesma chave de documento aparecendo repetidamente. Um breve período de uso elevado da CPU durante a abertura, recálculo, renderização, conversão ou exportação de documentos pode ser legítimo. O sinal de alerta mais forte é o uso contínuo da CPU sem progresso útil ou a repetição da mesma falha.
Correlacione os registros com o horário do pico de uso da CPU para que você possa diferenciar a atividade normal do documento do trabalho repetido ou travado.
4. Reproduza o pico com um documento de cada vez.
Retorne ao servidor hipotético. Se um processo do kit estiver consumindo muita CPU, feche ou isole o documento suspeito e observe se o uso da CPU diminui. Em seguida, abra o mesmo arquivo durante um período de baixa atividade, monitorando a lista de processos e as métricas. Repita o processo com um documento de teste simples.
Essa comparação é mais útil do que reiniciar todo o serviço imediatamente:
Se apenas um arquivo desencadeia o pico de forma consistente, o conteúdo do arquivo, fórmulas, objetos incorporados, carga de trabalho de renderização ou um bug específico do documento são os principais suspeitos.
Se todos os arquivos causarem saturação semelhante quando vários usuários estiverem ativos, investigue a capacidade e a concorrência do servidor.
Se o uso da CPU permanecer alto após a interrupção de toda a atividade do usuário, concentre-se na limpeza, em kits obsoletos, em tarefas em segundo plano repetidas ou em uma possível regressão.
Se o problema começou imediatamente após uma atualização, registre as versões antiga e nova antes de alterar muitas outras variáveis.
5. Reduza a concorrência por documento quando um documento puder monopolizar os núcleos.
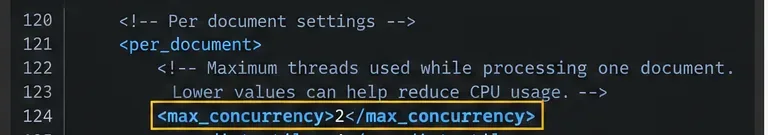
O modelo de configuração atual do Collabora define per_document.max_concurrencyo número máximo de threads utilizadas durante o processamento de um documento. O valor padrão do modelo é 4. Em servidores menores, ou quando um único documento complexo pode sobrecarregar a máquina, reduzir esse valor pode tornar o uso da CPU mais previsível.
Reduzir a concorrência por documento é uma questão de equilíbrio: pode diminuir a intensidade com que um documento utiliza a CPU, mas operações pesadas podem demorar mais.
Não copie o número 2 cegamente. Se os usuários manipulam rotineiramente planilhas ou apresentações grandes e o servidor possui núcleos suficientes, um valor menor pode simplesmente tornar o trabalho mais lento. Altere uma configuração, reproduza a mesma carga de trabalho e compare o uso da CPU, a capacidade de resposta e o tempo de conclusão.
6. Verifique as configurações de limpeza e de sessão ociosa antes de torná-las agressivas.
O modelo atual coolwsd.xmlinclui lógica de limpeza para documentos ociosos que consomem muitos recursos. No momento da redação deste documento, o modelo apresenta um intervalo de verificação de limpeza de 10.000 ms, um período de comportamento inadequado de 60 segundos, um limite de inatividade de 300 segundos e um limite de 85% de uso da CPU para que um documento se torne candidato à limpeza. Ele também inclui um tempo limite de inatividade por documento de 3.600 segundos.
O mesmo modelo inclui tempos limite por visualização. Os valores atuais mostram 300 segundos antes que uma visualização do navegador fora de foco seja escurecida e pare de atualizar, e 900 segundos antes que uma visualização inativa seja tratada da mesma forma. Esses tempos limite de visualização não são os mesmos que descarregar imediatamente uma sessão de documento inteira.
Os controles de limpeza e de inatividade da visualização podem reduzir o trabalho desperdiçado, mas devem ser ajustados de forma conservadora para que as sessões normais de edição de longa duração não sejam interrompidas.
Evite definir o limite de CPU extremamente baixo apenas para melhorar a aparência do gráfico. A função de limpeza visa identificar documentos inválidos ou ociosos que consomem muitos recursos, e não interromper edições ativas comuns sempre que elas se tornarem computacionalmente dispendiosas.
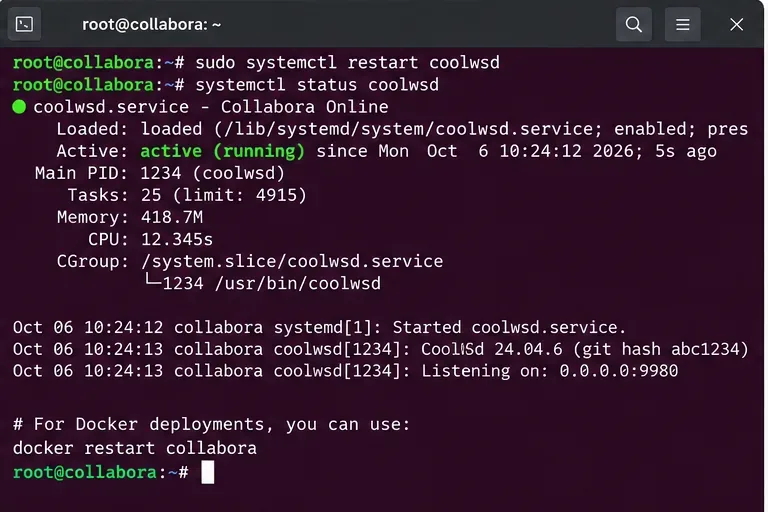
7. Reinicie somente após salvar uma alteração de configuração controlada.
Faça backup da configuração ativa primeiro. Instalações de pacotes normalmente usam [ /etc/coolwsd/coolwsd.xmlalguma configuração específica]. Implantações do Docker podem passar opções como variáveis de ambiente ou comandos de linha de comando, ou ainda montar um arquivo de configuração no contêiner. Confirme qual fonte está realmente ativa antes de editar qualquer coisa.
Reinicie somente após uma alteração de configuração deliberada e com backup realizado, e verifique se o serviço está funcionando corretamente antes que os usuários retomem os testes.
Se uma reinicialização por si só corrigir temporariamente o problema da CPU, mas ele retornar repetidamente, isso é informação de diagnóstico, não uma solução permanente. Continue até que você consiga explicar qual carga de trabalho ou estado causa a recorrência.
8. Compare o antes e o depois sob a mesma carga de trabalho.
Utilize o mesmo documento, aproximadamente o mesmo número de usuários e a mesma sequência de operações. Faça medições durante vários minutos, em vez de comparar um único instante. No cenário ilustrativo, o sucesso significaria que o servidor não permanece mais sobrecarregado durante a carga de trabalho reproduzida, enquanto a abertura, edição, salvamento e colaboração de documentos ainda se comportam de forma aceitável.
Utilize o mesmo endpoint de métricas após cada alteração controlada, para que a comparação entre o antes e o depois seja baseada em dados de servidor comparáveis.
Observação
Próxima ação provável
Um documento ou kit permanece aquecido.
Reproduza o problema com esse arquivo, preserve os registros e teste na versão micro estável atual.
A CPU monitora o número de usuários ativos.
Analise a capacidade, a simultaneidade e o dimensionamento da implementação, em vez de tratar a carga como um vazamento.
O uso da CPU permanece elevado mesmo após a saída de usuários.
Inspecione documentos ociosos, comportamento de limpeza, tarefas em segundo plano repetidas e kits órfãos ou reiniciados.
O pico de atividade começou imediatamente após a atualização.
Anote as versões exatas e verifique as notas de lançamento atuais e os problemas conhecidos antes de alterar muitos valores de ajuste.
Diminuir o valor de max_concurency reduz a CPU, mas a edição fica mais lenta.
Aumente gradualmente ou adicione capacidade de CPU; essa configuração é uma questão de equilíbrio, não uma solução universal.
Quando é melhor atualizar em vez de ajustar?
Se o problema começou com uma versão específica do Collabora e você consegue reproduzi-lo com um arquivo ou operação específica, o ajuste de configuração pode apenas mascarar um defeito de software. A Collabora recomenda o uso da versão mais recente do branch estável atual. Em 7 de outubro de 2026, a página oficial de notas de lançamento da versão 26.04 listava a versão 26.04.3.3 como a versão mais recente do Collabora Online disponível.
Para usuários do CODE, lembrem-se de que a Collabora descreve a Edição de Desenvolvimento como adequada para pequenas equipes, uso doméstico, desenvolvimento e experimentação de novas funcionalidades, afirmando, porém, que ela não se destina a ambientes de produção. Um incidente em produção no CODE pode, portanto, justificar a migração para o produto Collabora Online, que possui suporte, em vez de ficar ajustando indefinidamente o comportamento da edição de desenvolvimento.
O que não fazer
Não assuma que um coolwsdnúmero alto prova um vazamento de memória ou um loop infinito.
Não ative permanentemente o registro de depuração ou rastreamento durante um incidente de CPU, a menos que seja realmente necessário; o registro detalhado adiciona sua própria sobrecarga e pressão de armazenamento.
Não exponha o console de administração ou o endpoint de métricas à internet pública apenas para facilitar o monitoramento.
Não reduza os limites de limpeza até que as sessões ativas normais sejam encerradas.
Não utilize cotas de CPU como primeiro passo de diagnóstico. Um limite rígido pode proteger os usuários vizinhos em um host compartilhado, mas pode transformar um problema de CPU em lentidão na renderização de documentos e timeouts, sem revelar a causa.
Ordem recomendada para resolução de problemas
Confirme se o processo ocupado é coolwsdum processo antigo loolwsd, um processo filho ou um processo para kit/forkit.
Registre o uso de CPU, memória, documentos ativos e visualizações do Docker ou do host.
Correlacione os registros com a janela exata do pico.
Reproduza o problema com um documento suspeito e, em seguida, com um documento de controle simples.
Faça o teste per_document.max_concurrencyapenas se um documento estiver utilizando muita CPU em paralelo.
Revise as configurações de limpeza e de modo ocioso sem torná-las desnecessariamente agressivas.
Reinicie após cada alteração de configuração controlada e verifique a integridade do serviço.
Compare a mesma carga de trabalho antes e depois, e verifique a versão estável atual se o comportamento parece ser específico da versão.
O objetivo prático não é forçar o Collabora Online a usar o mínimo de CPU possível. É tornar o consumo de CPU explicável e proporcional ao trabalho útil, preservando, ao mesmo tempo, um desempenho aceitável de edição e colaboração.